Transformer 的核心贡献是把序列建模从循环结构中解放出来:每个 token 不再只能沿着时间步逐个传递信息,而是可以通过 attention 直接和上下文中的其他 token 建立联系。今天的 GPT、LLaMA、Qwen、Mistral 等 Decoder-only LLM,本质上都是在反复堆叠 Transformer Decoder Block。
本文从一次自回归语言模型的前向传播讲起:文本如何变成 token,token 如何进入 embedding,位置顺序如何通过 RoPE 注入 attention,multi-head attention 如何计算,FFN 为什么是逐 token 的非线性加工,最后模型如何得到下一个 token 的概率分布。
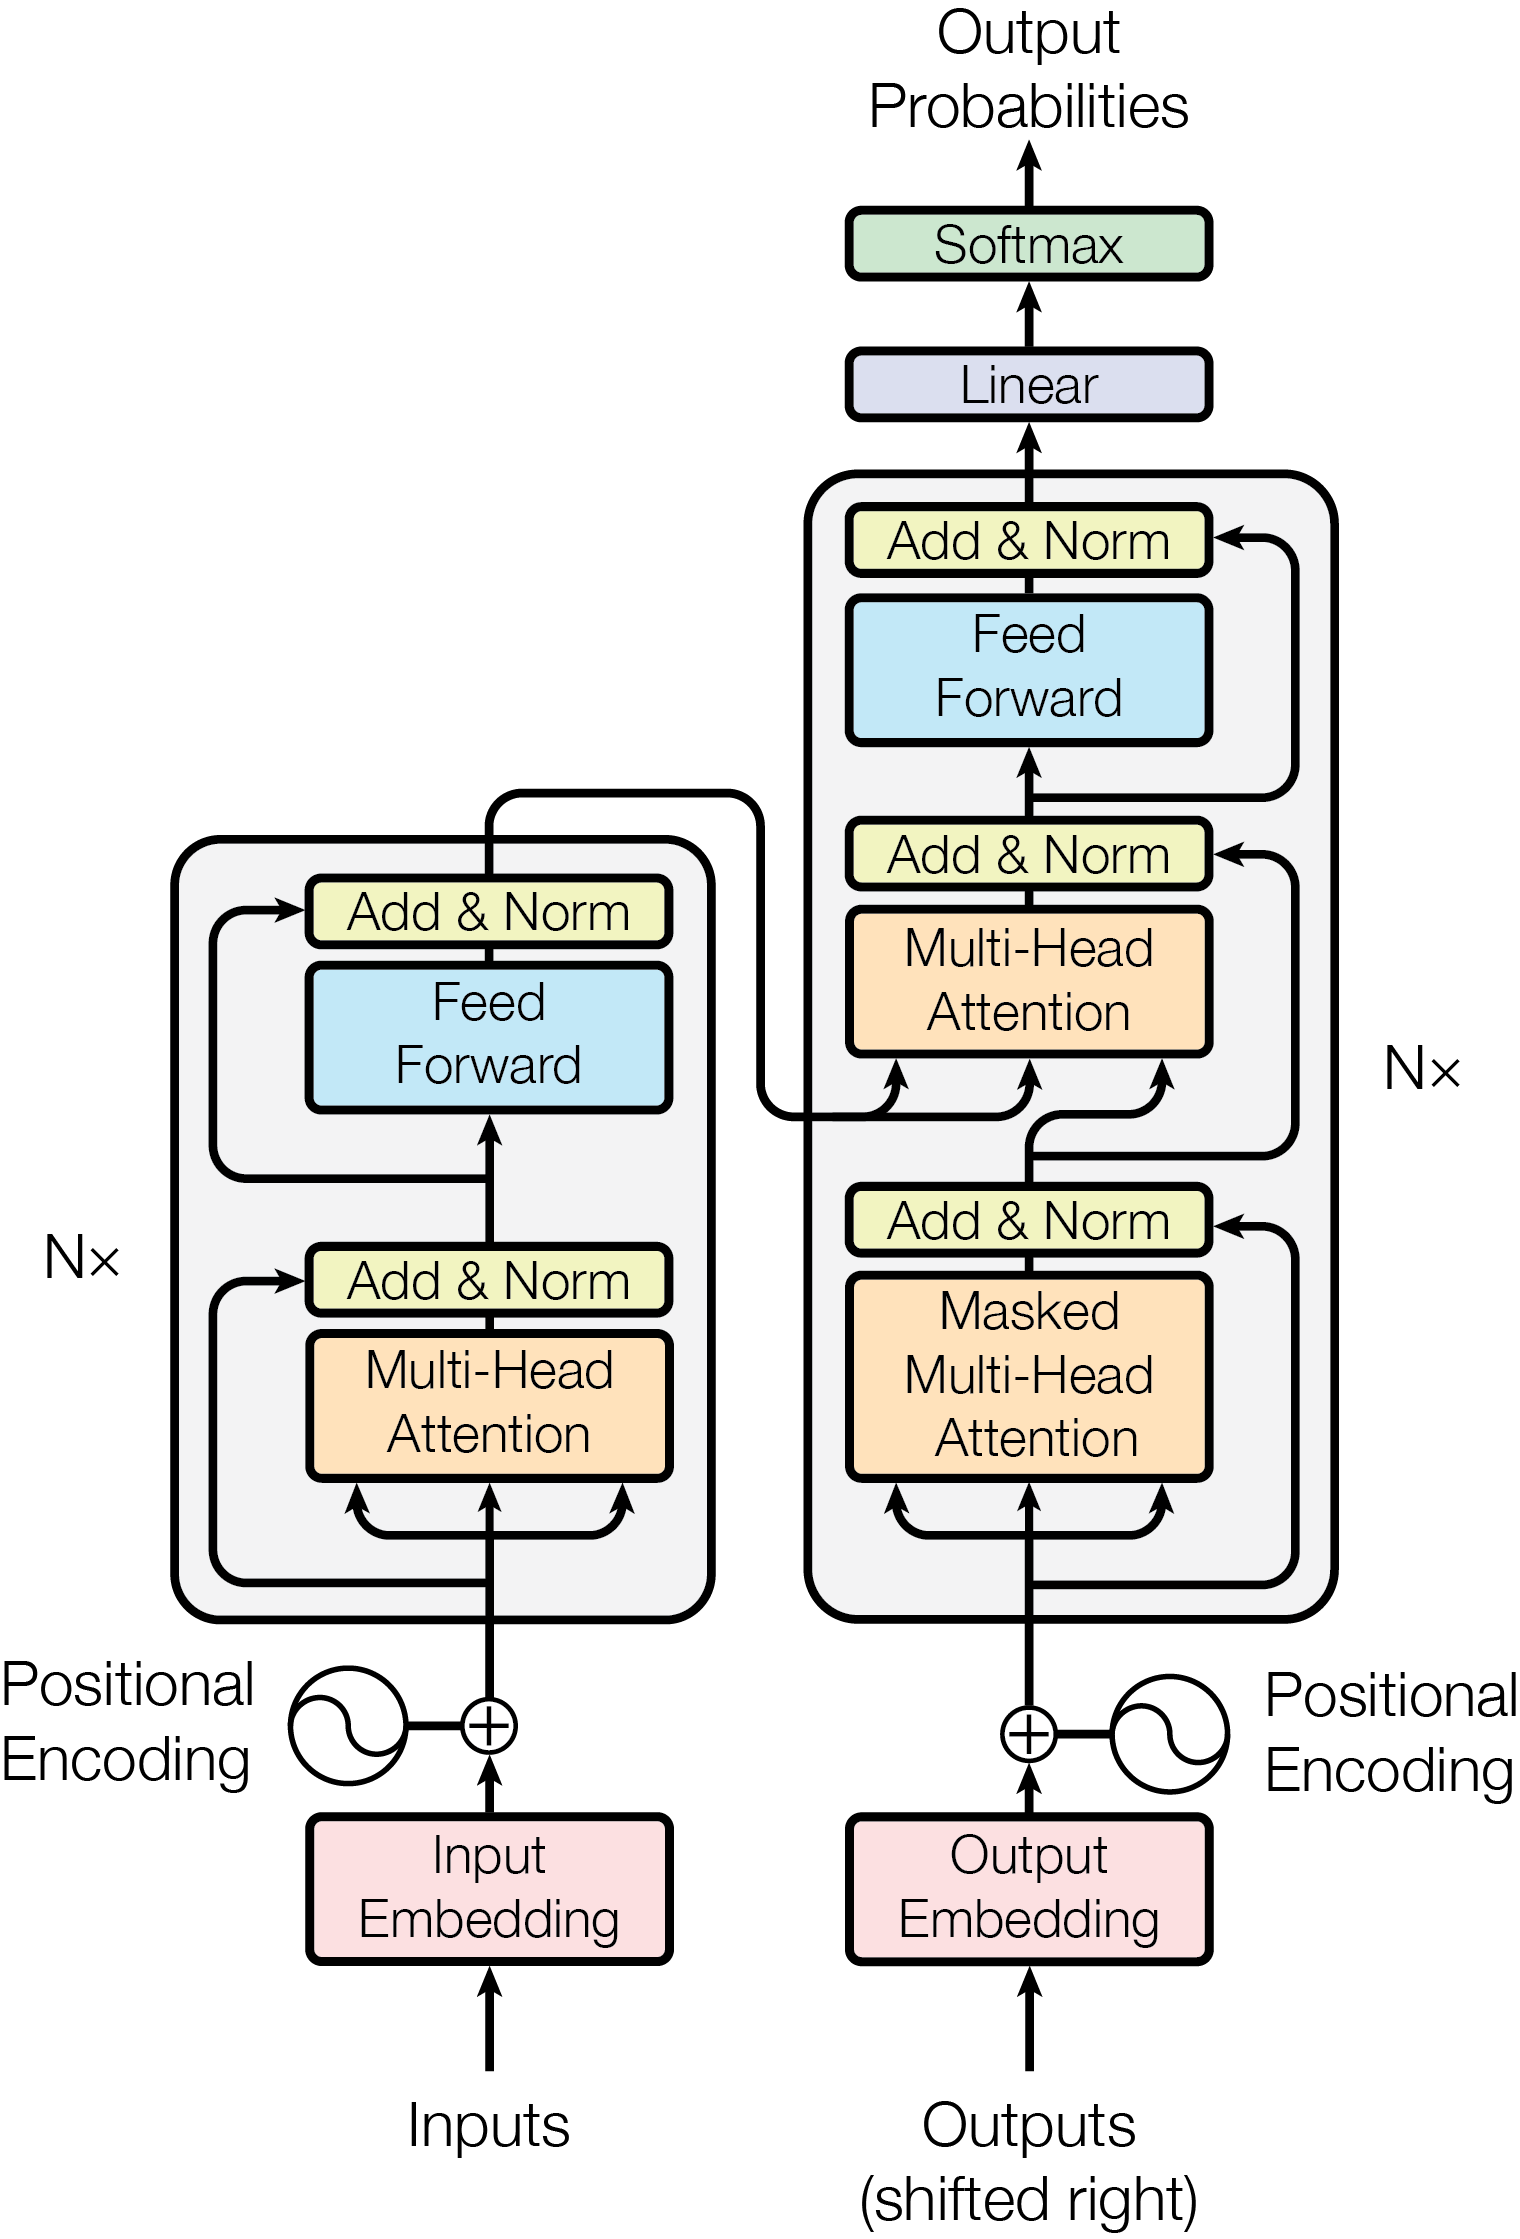
Fig. 1. Transformer 原论文中的 Encoder-Decoder 架构图。Decoder-only LLM 可以看作保留右侧 decoder 主干,并移除 cross-attention。 (Image source: Vaswani et al., 2017)
符号
| 符号 | 含义 |
|---|---|
| $N$ | 输入序列长度,即 token 数 |
| $V_{\text{vocab}}$ | 词表大小 |
| $d_{\text{model}}$ | 模型隐藏维度 |
| $n_{\text{head}}$ | attention head 数量 |
| $d_k$ | 每个 head 的维度,通常 $d_k=d_{\text{model}}/n_{\text{head}}$ |
| $X$ | token embedding 矩阵,$X\in\mathbb{R}^{N\times d_{\text{model}}}$ |
| $Q,K,V$ | Query、Key、Value 矩阵 |
| $\hat{Q},\hat{K}$ | 经过 RoPE 旋转后的 Query、Key |
| $A$ | attention weight 矩阵 |
| $M$ | causal mask 矩阵 |
Token Embedding
语言模型不能直接处理字符串。给定文本 $s$,tokenizer 会先把它变成 token id 序列:
$$ s \xrightarrow{\text{tokenizer}} [t_1,t_2,\ldots,t_N],\quad t_i\in\{1,\ldots,V_{\text{vocab}}\}. $$随后通过词嵌入矩阵查表:
$$ W_{\text{embed}}\in\mathbb{R}^{V_{\text{vocab}}\times d_{\text{model}}}, \quad X_i = W_{\text{embed}}[t_i]. $$堆叠所有 token 后得到:
$$ X = \begin{bmatrix} X_1\\ X_2\\ \vdots\\ X_N \end{bmatrix} \in \mathbb{R}^{N\times d_{\text{model}}}. $$从矩阵乘法角度看,token id 也可以先写成 one-hot 向量 $e_{t_i}\in\mathbb{R}^{V_{\text{vocab}}}$,再乘 embedding table:
$$ X_i=e_{t_i}^T W_{\text{embed}}. $$实际实现不会真的构造 one-hot,因为那会浪费内存;框架里的 embedding lookup 本质上就是按行索引。这个视角仍然有用:它说明 embedding layer 也是一个线性层,只是输入非常稀疏。
Tokenizer 的粒度会影响后续所有计算。字符级 tokenizer 词表小,但序列更长;词级 tokenizer 序列短,但词表巨大且难处理未登录词;现代 LLM 常用 BPE、SentencePiece 或类似 subword tokenizer,把常见词作为整体 token,把罕见词拆成子词。由于 attention 复杂度近似 $O(N^2)$,tokenizer 让同一段文本变成多少 token,会直接影响上下文成本。
Embedding 矩阵通常也是参数量大户之一。如果 $V_{\text{vocab}}=50{,}000$,$d_{\text{model}}=4096$,仅输入 embedding 就有:
$$ 50{,}000\times4096\approx2.05\times10^8 $$个参数。很多语言模型会把输入 embedding 和输出 LM head 权重绑定(weight tying),即:
$$ W_{\text{vocab}}=W_{\text{embed}}^T. $$这样可以减少参数量,也让“读入 token 的语义空间”和“预测 token 的语义空间”共享同一套表示。
此时 $X_i$ 只表达“第 $i$ 个 token 是什么”,还没有表达“它在序列中的位置”。如果把 token 顺序打乱,只看 embedding 本身,attention 并不会天然知道原始顺序。
位置编码
原始 Transformer 使用正弦位置编码:
$$ \begin{aligned} PE_{(pos,2i)} &= \sin\left(pos / 10000^{2i/d_{\text{model}}}\right),\\ PE_{(pos,2i+1)} &= \cos\left(pos / 10000^{2i/d_{\text{model}}}\right). \end{aligned} $$然后把位置向量直接加到 token embedding 上:
$$ \tilde{X}=X+PE. $$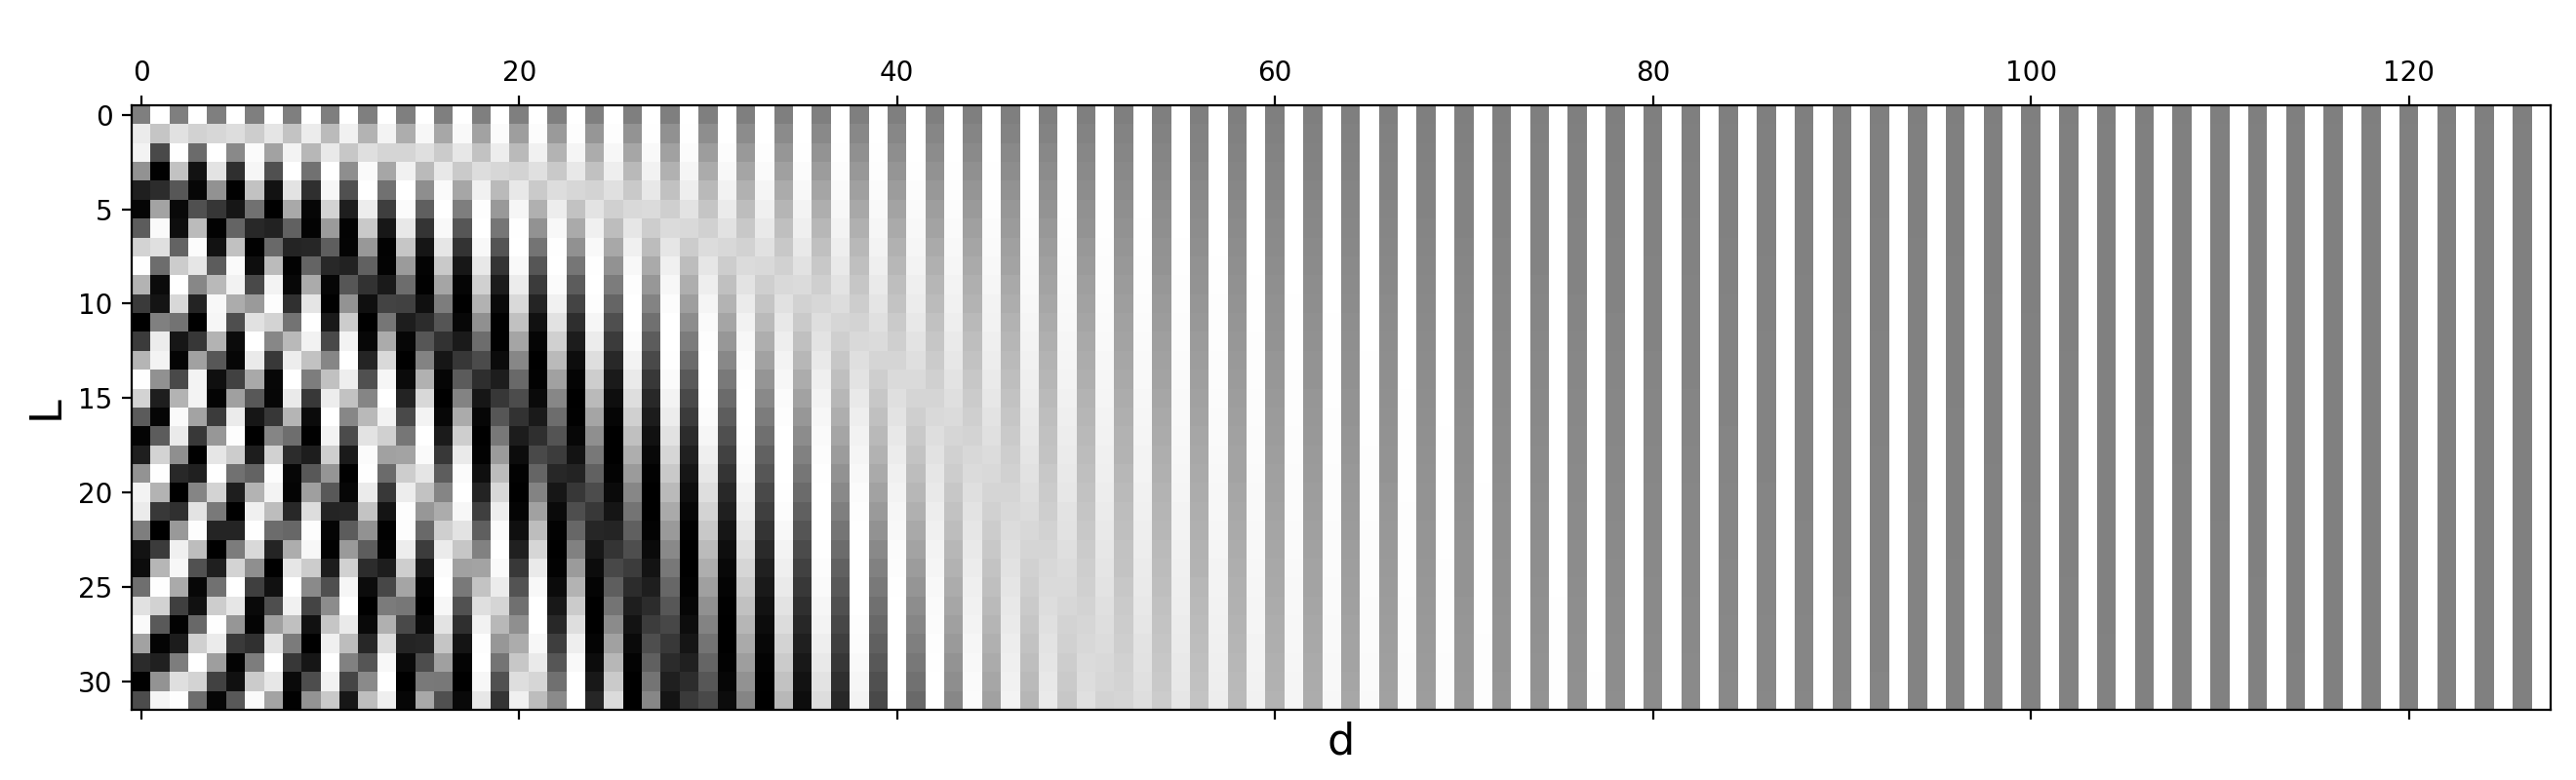
Fig. 2. 正弦位置编码在不同维度和位置上的取值。横轴是 embedding 维度,纵轴是序列位置;不同频率的正弦/余弦波共同提供位置信息。
这种做法简单直观:低维通道变化快,高维通道变化慢,不同频率共同编码位置。绝对位置编码的缺点也很明显:位置信息在输入端一次性注入,attention score 本身并不显式建模相对距离。
正弦位置编码还有一个重要性质:相对位移可以由线性变换表达。对同一频率 $\omega$,有:
$$ \begin{bmatrix}\sin((pos+k)\omega)\\ \cos((pos+k)\omega)\end{bmatrix} = \begin{bmatrix}\cos(k\omega)&\sin(k\omega)\\ -\sin(k\omega)&\cos(k\omega)\end{bmatrix}\begin{bmatrix}\sin(pos\omega)\\ \cos(pos\omega)\end{bmatrix}. $$也就是说,位置 $pos+k$ 的编码可以由位置 $pos$ 的编码通过一个只依赖 $k$ 的旋转矩阵得到。这是原始 Transformer 选择正弦/余弦的数学动机之一:模型有机会从绝对位置编码中推断相对位移。
现代 Decoder-only LLM 更常使用旋转位置编码(Rotary Position Embedding, RoPE)。RoPE 不把位置向量加到 $X$ 上,而是在计算 attention 之前旋转 $Q$ 和 $K$。
对每个 head 内相邻两维组成的二维向量 $(x_{2i},x_{2i+1})$,位置 $m$ 对应的旋转为:
$$ \begin{bmatrix} x'_{2i}\\ x'_{2i+1} \end{bmatrix} = \begin{bmatrix} \cos(m\theta_i)&-\sin(m\theta_i)\\ \sin(m\theta_i)&\cos(m\theta_i) \end{bmatrix} \begin{bmatrix} x_{2i}\\ x_{2i+1} \end{bmatrix}, \quad \theta_i = 10000^{-2i/d_k}. $$记二维旋转矩阵为 $R_\theta$,则:
$$ \hat{Q}_m=R_{m\theta}Q_m,\quad \hat{K}_n=R_{n\theta}K_n. $$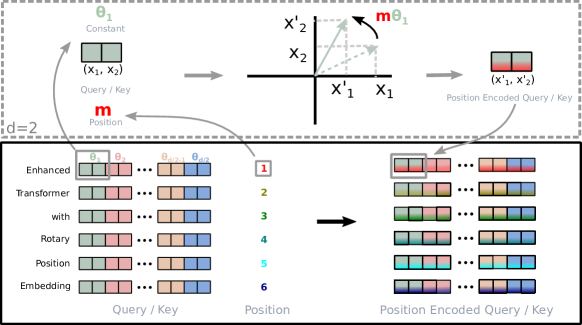
Fig. 3. RoFormer 论文中的 RoPE 实现示意图:通过对 $q$ 和 $k$ 的相邻维度施加正弦/余弦旋转,将位置信息注入 attention。 (Image source: Su et al., 2021)
RoPE 的关键性质来自旋转矩阵的组合:
$$ R_a^T R_b = R_{b-a}. $$因此 Query-Key 点积可以展开为:
$$ \begin{aligned} \hat{Q}_m^T\hat{K}_n &=(R_{m\theta}Q_m)^T(R_{n\theta}K_n)\\ &=Q_m^T R_{m\theta}^T R_{n\theta}K_n\\ &=Q_m^T R_{(n-m)\theta}K_n. \end{aligned} $$这说明 RoPE 分别用绝对位置 $m,n$ 旋转 $Q,K$,但 attention score 中出现的是相对位移 $n-m$。这也是 RoPE 适合自回归模型的原因:它把“内容相似度”和“相对距离”一起放进了点积结构。
RoPE 和正弦位置编码的频率形式很像,但注入位置的地方不同。正弦位置编码修改的是输入表示:
$$ X_i \leftarrow X_i + PE_i. $$RoPE 修改的是 attention 匹配过程:
$$ Q_i,K_j \leftarrow R_iQ_i,R_jK_j. $$因此 RoPE 更直接地作用在 $QK^T$ 上。对 Decoder-only LM 来说,模型每一步都在问“当前位置应该看历史哪些位置”,把相对位移放进 attention score 通常更自然。
Scaled Dot-Product Attention
Self-attention 的第一步是从输入表示中投影出 $Q,K,V$:
$$ Q=XW_q,\quad K=XW_k,\quad V=XW_v. $$其中:
$$ W_q,W_k,W_v\in\mathbb{R}^{d_{\text{model}}\times d_{\text{model}}}. $$如果使用 RoPE,则 attention 实际使用的是旋转后的 $\hat{Q},\hat{K}$:
$$ \hat{Q}=\text{RoPE}(Q),\quad \hat{K}=\text{RoPE}(K). $$对于第 $i$ 个 query 和第 $j$ 个 key,未归一化的 attention score 为:
$$ s_{ij} = \frac{\hat{Q}_i\hat{K}_j^T}{\sqrt{d_k}}. $$除以 $\sqrt{d_k}$ 是为了控制点积方差。若 $q,k$ 的每一维近似独立、均值为 0、方差为 1,则:
$$ \text{Var}(q^Tk) =\text{Var}\left(\sum_{\ell=1}^{d_k}q_\ell k_\ell\right) =d_k. $$随着 $d_k$ 增大,点积尺度会变大,softmax 更容易进入饱和区,梯度变小。缩放后:
$$ \text{Var}\left(\frac{q^Tk}{\sqrt{d_k}}\right)\approx 1. $$这就是 Scaled Dot-Product Attention 中 scale 的由来。
从矩阵形状看,单个 head 中:
$$ Q,K,V\in\mathbb{R}^{N\times d_k},\quad QK^T\in\mathbb{R}^{N\times N},\quad A V\in\mathbb{R}^{N\times d_k}. $$$N\times N$ 的 attention matrix 是 Transformer 的关键能力来源,也是长上下文成本的来源。第 $i$ 行表示第 $i$ 个 token 对所有 key 位置的注意力分布;第 $j$ 列表示其他 token 对第 $j$ 个 token 的读取强度。
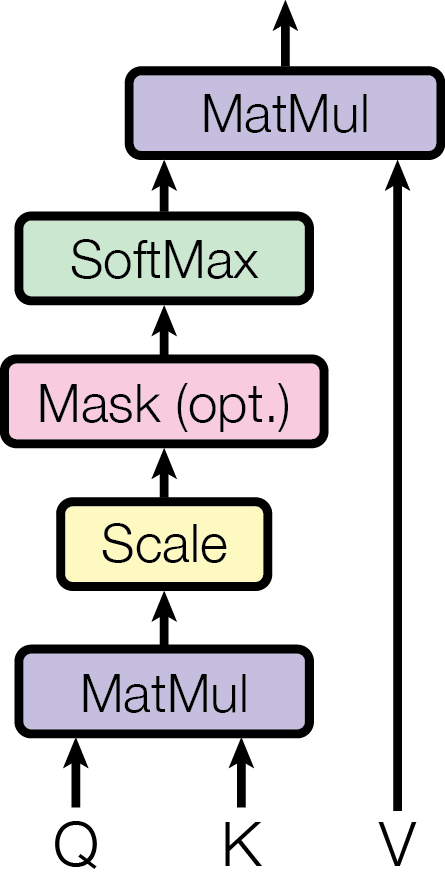
Fig. 4. Scaled Dot-Product Attention:先计算 $QK^T$,再 scale、mask、softmax,最后对 $V$ 加权求和。 (Image source: Vaswani et al., 2017)
Decoder-only 语言模型还需要 causal mask,禁止当前位置看到未来 token。对长度为 3 的序列,score 矩阵在 mask 后变为:
$$ S_{\text{causal}} = \begin{bmatrix} s_{00} & -\infty & -\infty\\ s_{10} & s_{11} & -\infty\\ s_{20} & s_{21} & s_{22} \end{bmatrix}. $$再对每一行做 softmax:
$$ A_{ij} = \frac{\exp(s_{ij}+M_{ij})} {\sum_{r=0}^{N-1}\exp(s_{ir}+M_{ir})}. $$其中:
$$ M_{ij} = \begin{cases} 0, & j\le i,\\ -\infty, & j>i. \end{cases} $$最终输出为:
$$ \text{Attention}(Q,K,V) = \text{softmax} \left( \frac{\hat{Q}\hat{K}^T}{\sqrt{d_k}}+M \right)V. $$直觉上,$Q$ 表示“我想找什么”,$K$ 表示“我能被什么匹配”,$V$ 表示“匹配成功后我贡献什么内容”。Attention weight $A_{ij}$ 越大,说明第 $i$ 个 token 越应该从第 $j$ 个 token 处读取信息。
注意 softmax 是逐行做的。对于 causal LM,第 $i$ 行只有 $j\le i$ 的位置有效,因此:
$$ \sum_{j=0}^{i}A_{ij}=1,\quad A_{ij}=0\text{ for }j>i. $$这保证了训练时虽然可以并行计算整段序列的所有位置,但每个位置的预测仍然只依赖历史 token,不会泄漏答案。
Multi-Head Attention
单个 attention head 只在一个子空间中建模 token 关系。如果只用一个 head,模型必须把所有关系都压进同一套 $Q,K,V$ 投影里:主谓关系、指代关系、局部修饰、长距离依赖、格式边界都会混在同一个 attention 分布中。Multi-Head Attention(MHA)的做法是把隐藏表示拆到多个子空间中,让每个 head 学习一套独立的匹配方式。
设输入 $X\in\mathbb{R}^{N\times d_{\text{model}}}$,head 数为 $h=n_{\text{head}}$,每个 head 维度为 $d_k=d_{\text{model}}/h$。第 $r$ 个 head 的投影矩阵为:
$$ W_q^{(r)},W_k^{(r)},W_v^{(r)}\in\mathbb{R}^{d_{\text{model}}\times d_k}. $$于是:
$$ \text{head}_h = \text{Attention}(XW_q^{(h)},XW_k^{(h)},XW_v^{(h)}), $$每个 head 的输出形状都是 $\mathbb{R}^{N\times d_k}$。把 $h$ 个 head 拼接后,维度回到 $\mathbb{R}^{N\times d_{\text{model}}}$:
$$ \text{MHA}(X) = \text{Concat}(\text{head}_1,\ldots,\text{head}_{n_{\text{head}}})W_o. $$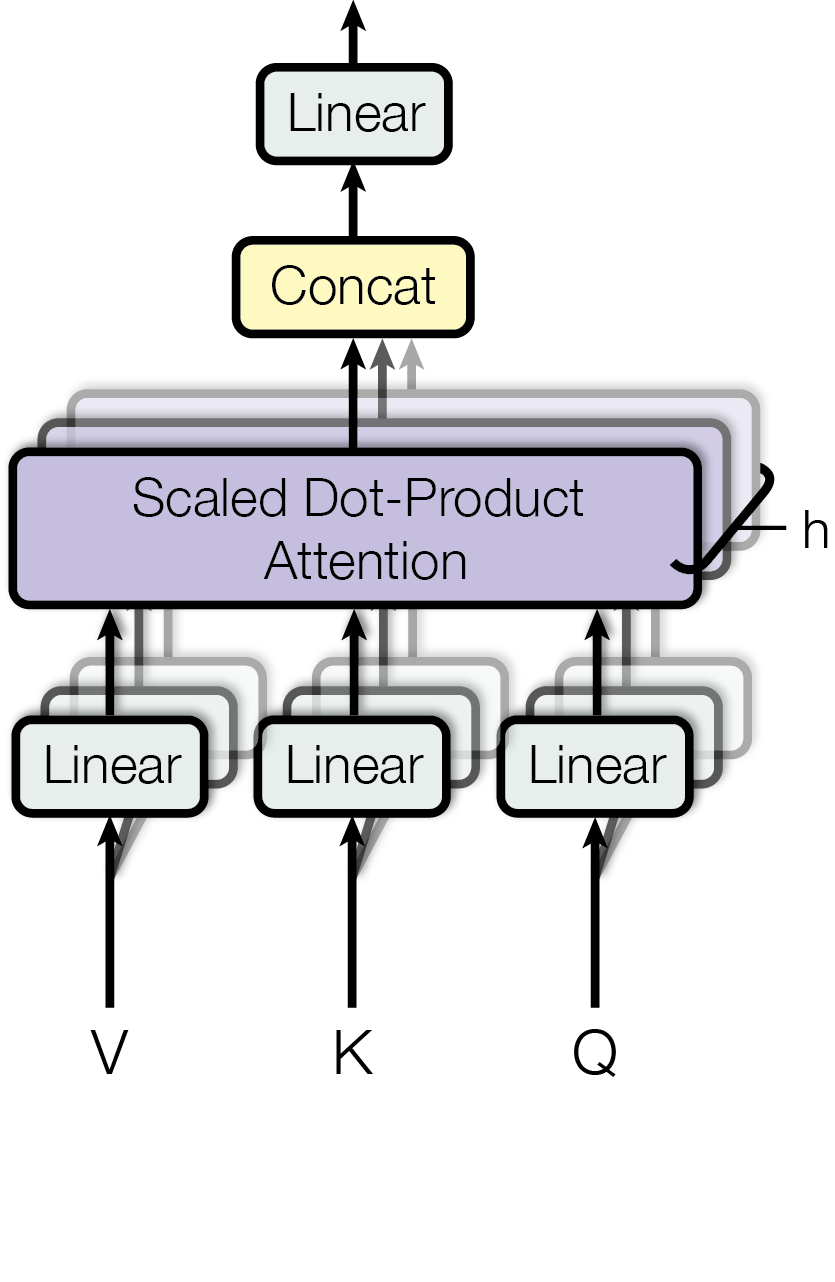
Fig. 5. Multi-Head Attention:多个 head 并行计算 Scaled Dot-Product Attention,再 concat 后经过线性投影。 (Image source: Vaswani et al., 2017)
如果 $d_{\text{model}}=12288$、$n_{\text{head}}=96$,则每个 head 的维度为:
$$ d_k = \frac{12288}{96}=128. $$这不是把 12288 维整体做一次 attention,而是让 96 个 head 分别在 128 维子空间中学习不同关系。有些 head 可能关注短距离修饰,有些可能关注长距离指代,有些可能关注格式、标点或结构边界。拼接之后的 $W_o$ 负责再次混合这些子空间,让不同 head 的信息发生交互。
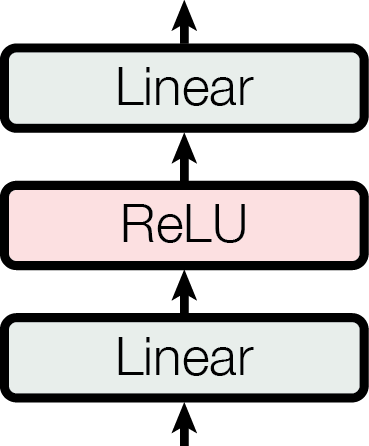
Fig. 6. 原论文中 Multi-Head Attention 的另一种画法:$Q,K,V$ 先经过线性投影并 split 到多个 head,再并行做 attention。 (Image source: Vaswani et al., 2017)
RoPE 通常在每个 head 内独立应用。也就是说,旋转发生在 $d_k$ 维子空间中,而不是先在完整 $d_{\text{model}}$ 上统一旋转再切分。
MHA、MQA 与 GQA
上面的标准 MHA 中,每个 query head 都有自己独立的 key head 和 value head。也就是说,query head 数、key head 数、value head 数相同:
$$ n_q=n_k=n_v=h. $$这在训练时很自然,但在自回归推理时会带来显存带宽压力。生成第 $t$ 个 token 时,模型只产生一个新的 query,却必须从 KV cache 中读取历史所有 token、所有层、所有 KV head 的 $K,V$。如果每个 query head 都有独立的 $K,V$,那么 KV cache 的规模与 $h$ 成正比。
忽略 batch 和层数,只看单层单请求,MHA 的 KV cache 大小近似为:
$$ M_{\text{KV}}^{\text{MHA}} \propto 2\cdot N\cdot h\cdot d_k. $$这里的 $2$ 来自 Key 和 Value。Multi-Query Attention(MQA)把所有 query heads 共享同一组 $K,V$,即:
$$ n_q=h,\quad n_k=n_v=1. $$此时每个 head 仍然有自己的 $Q^{(r)}$,但所有 head 使用相同的 $K,V$:
$$ \text{head}_r=\text{Attention}(XW_q^{(r)},XW_k,XW_v). $$MQA 的 KV cache 规模变为:
$$ M_{\text{KV}}^{\text{MQA}} \propto 2\cdot N\cdot 1\cdot d_k. $$因此相比 MHA,MQA 在 decode 阶段读取 KV cache 的带宽大约可以降低 $h$ 倍。代价是所有 query heads 共享同一套 key/value 表示,表达能力可能下降,尤其是大模型或复杂任务中,不同 head 失去了各自独立的 memory view。
Grouped-Query Attention(GQA)是 MHA 和 MQA 的折中。设 query head 数为 $h$,KV head 数为 $g$,满足:
$$ 1于是:
$$ \text{head}_r=\text{Attention}(XW_q^{(r)},XW_k^{(\text{group}(r))},XW_v^{(\text{group}(r))}). $$GQA 的 KV cache 规模为:
$$ M_{\text{KV}}^{\text{GQA}} \propto 2\cdot N\cdot g\cdot d_k. $$可以看到,三者构成一条连续谱:
$$ \text{MHA}:g=h,\quad \text{GQA}:1Decoder Block
原始 Transformer 采用 Post-LN,即先做子层,再 residual add,再 LayerNorm。现代大模型更常使用 Pre-LN:
$$ \begin{aligned} X' &= X + \text{MHA}(\text{LN}(X)),\\ Y &= X' + \text{MLP}(\text{LN}(X')). \end{aligned} $$Pre-LN 的训练稳定性更好,尤其适合堆叠很多层。注意这里的 residual connection 不是细节,而是深层 Transformer 能训练起来的关键之一:它为信息和梯度提供了一条近似恒等路径。
LayerNorm 对每个 token 的隐藏向量单独归一化。给定 $x\in\mathbb{R}^{d_{\text{model}}}$:
$$ \text{LN}(x)=\gamma\odot\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}+\beta,\quad \mu=\frac{1}{d_{\text{model}}}\sum_i x_i,\quad \sigma^2=\frac{1}{d_{\text{model}}}\sum_i(x_i-\mu)^2. $$它和 BatchNorm 不同,不依赖 batch 维度统计量,因此很适合变长序列和自回归推理。Pre-LN 把归一化放在子层之前,使残差路径更接近恒等映射;Post-LN 则把归一化放在残差之后,深层训练时更容易出现梯度传播问题。
把一个 Decoder Block 展开,可以写成:
$$ \begin{aligned} Z &= \text{LN}(X),\\ Q,K,V &= ZW_q, ZW_k, ZW_v,\\ \hat{Q},\hat{K} &= \text{RoPE}(Q),\text{RoPE}(K),\\ O &= \text{softmax}\left(\frac{\hat{Q}\hat{K}^T}{\sqrt{d_k}}+M\right)V W_o,\\ X' &= X + O,\\ Y &= X' + \text{MLP}(\text{LN}(X')). \end{aligned} $$其中 $M$ 是 causal mask。这个公式基本就是 Decoder-only Transformer 的核心计算。
需要注意的是,Decoder-only LLM 中没有 Encoder-Decoder Transformer 里的 cross-attention。原论文 decoder 有两层 attention:第一层 masked self-attention 看已生成的目标序列,第二层 cross-attention 看 encoder 输出。GPT 类模型只保留 masked self-attention,因为它的任务不是条件翻译,而是根据同一段上下文继续预测下一个 token。
Feed-Forward Network
Attention 解决的是“从哪些 token 读取信息”。读完之后,每个 token 还需要对自己的隐藏表示做非线性加工,这就是 FFN / MLP 的作用。
经典 Transformer FFN 为:
$$ \text{FFN}(x)=W_2\,\sigma(W_1x+b_1)+b_2. $$原论文使用 ReLU:
$$ \sigma(x)=\max(0,x). $$现代 LLM 常用 GELU、SwiGLU 或 GEGLU。以 SwiGLU 为例:
$$ \text{SwiGLU}(x) = (xW_1)\odot \text{SiLU}(xW_3), \quad \text{SiLU}(z)=z\cdot\sigma(z). $$FFN 对每个位置独立应用,不直接让 token 之间通信。换句话说,token 间通信主要发生在 attention 中;FFN 负责提升每个 token 表示的非线性表达能力。
FFN 通常会先升维再降维。原始 Transformer 使用 $d_{\text{ff}}=4d_{\text{model}}$:
$$ x\in\mathbb{R}^{d_{\text{model}}}\xrightarrow{W_1}\mathbb{R}^{d_{\text{ff}}}\xrightarrow{\sigma}\mathbb{R}^{d_{\text{ff}}}\xrightarrow{W_2}\mathbb{R}^{d_{\text{model}}}. $$这相当于给每个 token 一个更宽的非线性工作空间。Attention 决定信息从哪里来,FFN 决定这些信息在当前位置如何组合、筛选和变换。
从参数量看,经典 FFN 的两层矩阵大约有:
$$ d_{\text{model}}\cdot d_{\text{ff}}+d_{\text{ff}}\cdot d_{\text{model}}=2d_{\text{model}}d_{\text{ff}}. $$若 $d_{\text{ff}}=4d_{\text{model}}$,则单层 FFN 约为 $8d_{\text{model}}^2$ 参数,通常比 attention 投影更大。因此在很多 LLM 中,MLP/FFN 是参数量和计算量的重要来源。
多层堆叠
一个 Decoder Block 只完成一轮“通信 + 加工”。实际模型会堆叠 $L$ 层:
$$ H^{(0)}=X,\quad H^{(\ell)}=\text{DecoderBlock}^{(\ell)}(H^{(\ell-1)}), \quad \ell=1,\ldots,L. $$最后通常再做一次 LayerNorm:
$$ H_{\text{final}}=\text{LN}(H^{(L)}). $$每一层都会重新计算 attention,因此浅层可能更偏局部模式,深层更偏语义和任务相关表示。最终的 $H_{\text{final},i}$ 是第 $i$ 个位置在完整历史上下文中的表示。
堆叠的意义不只是“重复多次”。第一层 attention 只能基于原始 embedding 建立关系;第二层看到的是已经混合过上下文的信息;更深层可以在“关系的关系”上继续建模。比如浅层可能把形容词和名词绑定起来,中层建立指代关系,深层再把这些关系用于任务判断或下一 token 预测。
每一层都有自己的参数:
$$ \text{DecoderBlock}^{(1)},\text{DecoderBlock}^{(2)},\ldots,\text{DecoderBlock}^{(L)} $$通常不共享权重。也就是说,层数增加不仅增加计算深度,也增加模型容量。
预测下一个 Token
自回归语言模型训练和推理的目标都是预测下一个 token。把最终隐藏状态投影回词表空间:
$$ \text{logits}=H_{\text{final}}W_{\text{vocab}}, \quad W_{\text{vocab}}\in\mathbb{R}^{d_{\text{model}}\times V_{\text{vocab}}}. $$第 $i$ 个位置得到一个 $V_{\text{vocab}}$ 维向量:
$$ \text{logits}_i\in\mathbb{R}^{V_{\text{vocab}}}. $$Softmax 给出下一个 token 的概率:
$$ P(t_{i+1}=v\mid t_{\le i}) = \frac{\exp(\text{logits}_{i,v})} {\sum_{u=1}^{V_{\text{vocab}}}\exp(\text{logits}_{i,u})}. $$训练时,模型对每个位置都预测下一个 token,并用交叉熵优化:
$$ \mathcal{L} = -\sum_{i=1}^{N-1} \log P(t_{i+1}\mid t_{\le i}). $$推理时,只取最后一个位置的概率分布,采样或选择一个 token,追加到上下文后继续下一轮:
$$ t_{N+1}\sim P(\cdot\mid t_{\le N}). $$训练时通常使用 teacher forcing:输入是真实前缀 $t_{\le i}$,标签是真实下一个 token $t_{i+1}$。因此长度为 $N$ 的序列可以并行产生 $N-1$ 个监督信号。推理时则不同,模型生成的 token 会被追加回上下文,成为下一步输入的一部分:
$$ t_{N+2}\sim P(\cdot\mid t_{\le N},t_{N+1}). $$采样策略会明显影响输出风格。Greedy decoding 每次选择概率最大的 token;temperature 会改变分布尖锐程度:
$$ P_T(v)=\frac{\exp(\text{logits}_v/T)}{\sum_u\exp(\text{logits}_u/T)}. $$$T<1$ 会让分布更尖锐,输出更确定;$T>1$ 会让分布更平坦,输出更多样。Top-k 和 top-p 则是在采样前截断候选集合,减少低概率 token 带来的噪声。
总结
Decoder-only Transformer 的主线可以压缩成:
$$ \text{Token IDs} \xrightarrow{\text{Embedding}} X \xrightarrow{L\times\text{DecoderBlock}} H_{\text{final}} \xrightarrow{\text{LM Head}} \text{logits} \xrightarrow{\text{softmax}} P(\text{next token}). $$每个 Decoder Block 内部的核心是:
$$ \text{LN} \rightarrow Q/K/V \rightarrow \text{RoPE}(Q,K) \rightarrow \text{Causal Self-Attention} \rightarrow \text{Residual} \rightarrow \text{MLP} \rightarrow \text{Residual}. $$Transformer 的关键设计可以归纳为三点:
- Self-Attention 解决 token 间信息路由:每个 token 通过 $QK^T$ 判断应该从哪些历史 token 读取信息。
- RoPE 让 attention score 感知相对位置:位置不再简单加到 embedding 上,而是通过旋转 $Q,K$ 进入点积。
- FFN 对每个 token 做非线性加工:attention 负责通信,FFN 负责变换表示,二者交替堆叠形成深层语义建模能力。
参考文献
[1] Vaswani, Ashish, et al. “Attention is all you need.” Advances in Neural Information Processing Systems 30 (2017).
[2] Su, Jianlin, et al. “RoFormer: Enhanced Transformer with Rotary Position Embedding.” Neurocomputing 568 (2024): 127063.
[3] Shazeer, Noam. “GLU Variants Improve Transformer.” arXiv preprint arXiv:2002.05202 (2020).
[4] Shazeer, Noam. “Fast Transformer Decoding: One Write-Head is All You Need.” arXiv preprint arXiv:1911.02150 (2019).
[5] Ainslie, Joshua, et al. “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints.” arXiv preprint arXiv:2305.13245 (2023).