这篇博客主要是总结一下项目,讲这个项目的 Agent Harness
Loop Engineering
这个项目本质上是一个 prompt 引导的 ReAct Agent。标准 ReAct loop 用 langchain.agents.create_agent 搭;如果要完全控制 Think、Act、Observe、Reflect 每个节点,就直接用 StateGraph 自己搭。
这两个层次不要混在一起:
create_agent:高级 agent harness。模型、工具循环、messages reducer、checkpoint、middleware 都已经接好,适合大多数 ReAct Agent。StateGraph:低层编排。自己定义 State、节点、边和 ToolNode,适合需要强控制流、复杂状态机、多分支并行、human-in-the-loop 的场景。
项目里的 hook 统一挂到 middleware:
on_session_start / on_session_end
  -> before_agent / after_agent

pre_think / post_reflect
  -> before_model / after_model 或 wrap_model_call

pre_tool_call / post_tool_call
  -> wrap_tool_call
如果使用纯 StateGraph,这些 hook 也能保留原来的名字,只是挂载位置变成显式节点:START -> before_agent -> model -> tools -> model -> after_agent -> END。
ReAct Agent
Agent 入口是 create_agent:
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model=get_llm(),
    tools=FULL_TOOL_SET,
    system_prompt=prompt,
    middleware=[
        GlobexLifecycleMiddleware(),
        GlobexContextMiddleware(summary_model=get_summary_llm()),
        GlobexToolMiddleware(),
    ],
    state_schema=GlobexAgentState,
    context_schema=GlobexRuntimeContext,
    checkpointer=InMemorySaver(),
)

config = {"configurable": {"thread_id": thread_id}}

result = await agent.ainvoke(
    {
        "messages": [{"role": "user", "content": query}],
        "task_state": initial_task_state,
    },
    config=config,
    context=GlobexRuntimeContext(
        user_id=user_id,
        session_dir=session_dir,
        locale="zh-CN",
    ),
)
这里有几个关键点:
- system prompt 通过
system_prompt=传入。 - 工具还是直接传
tools=[...],不要把ToolNode当 tools 传进去。 state_schema放 Agent 需要持久化的业务状态。context_schema放本次运行的 runtime context,比如user_id、session_dir、租户信息,这些不应该写进模型 messages。checkpointer负责按thread_id保存短期记忆和中间状态。
tool-call hooks
每一轮模型都会看到:
- system prompt
- 历史
messages - 当前可见的 tools schema
如果模型判断需要调用工具,就会在 AIMessage 里生成 tool_calls:
{
    "id": "call_123",
    "name": "item_search",
    "args": {"query": "旅行收纳袋"}
}
一旦 AIMessage 里有 tool_calls,LangGraph 就会把流程从 LLM 节点路由到 tools 节点。
默认情况下,tools 节点是 LangGraph 内置的 ToolNode,它负责:
- 根据 tool_call[“name”] 找到工具
- 把 tool_call[“args”] 传给工具
- 执行工具
- 把结果包装成 ToolMessage,追加回 messages
工具调用 hook 放在 wrap_tool_call middleware,它天然包在单次工具调用前后:
from collections.abc import Awaitable, Callable
from langchain.agents.middleware import AgentMiddleware
from langchain.messages import ToolMessage
from langchain.tools.tool_node import ToolCallRequest
from langgraph.types import Command


class GlobexToolMiddleware(AgentMiddleware[GlobexAgentState, GlobexRuntimeContext]):
    async def awrap_tool_call(
        self,
        request: ToolCallRequest,
        handler: Callable[[ToolCallRequest], Awaitable[ToolMessage | Command]],
    ) -> ToolMessage | Command:
        tool_call = request.tool_call

        ctx = await harness.run("pre_tool_call", {
            "tool_name": tool_call["name"],
            "tool_args": tool_call["args"],
            "tool_call_id": tool_call["id"],
            "state": request.state,
            "runtime": request.runtime,
        })

        if ctx.get("_rejected"):
            return ToolMessage(
                content=f"[Harness 拒绝] {ctx['_reject_reason']}",
                tool_call_id=tool_call["id"],
            )

        result = await handler(request)

        ctx = await harness.run("post_tool_call", {
            "tool_name": tool_call["name"],
            "tool_result": result.content if isinstance(result, ToolMessage) else result,
            "state": request.state,
            "runtime": request.runtime,
        })

        if isinstance(result, ToolMessage) and "tool_result" in ctx:
            return ToolMessage(
                content=ctx["tool_result"],
                tool_call_id=result.tool_call_id,
                name=result.name,
            )

        return result
pre_tool_call 做工具白名单、阶段权限、参数校验、调用顺序检查;post_tool_call 做结果过滤、截断、压缩、熔断记录和 schema 校验。核心是把工具边界治理集中在 wrap_tool_call。
CircuitBreaker
CircuitBreaker 不是一个独立工具,也不是单个 hook,而是工具调用边界上的保护组件。它治理的是外部依赖失败,比如某个平台 API 超时、Reranker 服务异常、Embedding 服务不可用。
项目里按工具维度维护熔断状态:
Closed -> Open -> HalfOpen -> Closed
- Closed:正常放行工具调用,同时记录成功/失败。
- Open:工具已熔断,不再真实请求外部服务,直接返回结构化不可用结果。
- HalfOpen:等待恢复窗口后放一次试探请求,成功则恢复 Closed,失败则回到 Open。
默认策略是最近 100 次调用做滑动窗口统计,失败率超过 30% 进入 Open;但至少要有 10 个样本才判断,避免刚启动时一两次失败就误熔断。Open 后等待 5 分钟再进入 HalfOpen 试探恢复。Reranker、tower_encode 这种核心链路可以把阈值调得更敏感,比如 20% 失败率就熔断。
核心点不是让 Agent 报错退出,而是把工具不可用包装成 observation,让主 loop 自己决定换平台、降级或基于已有结果收尾:
return ItemSearchOutput(
    platform=platform,
    candidates=[],
    total_recall=0,
    truncated=False,
    error_message="工具 item_search_amazon 已熔断,预计 300s 后试探恢复",
)
主 loop 看到 candidates=[] + error_message 后,会跳过已熔断平台,继续用 Shopee / AliExpress / eBay 的候选比价,避免卡在 Amazon API 上等到子任务超时。
当前项目里,CircuitBreaker 不是 hook,而是包在具体工具内部的保护器。例如 item_search 通过 get_breaker(f"item_search_{platform}") 取得熔断器,再用 breaker.call(_actual_search, ...) 调真实平台 API。若状态是 Open,就不再请求外部服务,而是把 CircuitOpenError 转成结构化 observation 返回给主 loop。
迁到统一 Harness Pipeline 后,post_tool_call 只负责记录工具结果并更新熔断状态:
post_tool_call:
  记录 success / failure
  更新 Closed / Open / HalfOpen
如果要把 Open 状态短路也收进 Harness,可以额外加 pre_tool_call.breaker_check;但这属于进一步收敛工具边界,不是当前项目描述里已落地的 hook。
多实例时,熔断状态不能只存在内存里,必须同步到 Redis。否则实例 A 已经熔断,实例 B 仍会继续请求坏掉的服务。跨用户生效也不是靠 WebSocket 广播,而是靠共享状态:第一个用户失败后,post_tool_call 更新 breaker:{tool_name};其他用户下次调用时,由 breaker.call 或 pre_tool_call 读取 Redis,若状态为 Open,就直接返回“工具暂时不可用”的 observation,让 Agent 换平台或降级收尾。AGUI / WebSocket 只展示当前任务事件,不承担全局熔断同步。
如果工具要写 Agent State,不要改全局变量,直接返回 Command(update={...}),并同时写入对应 ToolMessage,这样更新才能走 LangGraph reducer,并被 checkpoint 恢复。
agent-loop hooks
AgentLoop 级别的 hooks 对应 middleware 的四个节点式 hook:
before_agent  -> on_session_start,每次 invoke 开始时执行一次
before_model  -> pre_think,每次 LLM 调用前执行
after_model   -> post_reflect,每次 LLM 返回后执行
after_agent   -> on_session_end,每次 invoke 结束时执行一次
如果逻辑只是读 state、写 state,用 before_model / after_model;如果要包住模型调用做 retry、fallback、动态换模型、动态工具暴露,就用 wrap_model_call。这里要分清职责:GlobexLifecycleMiddleware 只负责生命周期 hook 和运行时提示;模型上下文拼接、Breakpoint 判断和压缩统一放在 GlobexContextMiddleware。
from typing import Any
from langchain.agents.middleware import AgentMiddleware
from langgraph.runtime import Runtime


class GlobexLifecycleMiddleware(AgentMiddleware[GlobexAgentState, GlobexRuntimeContext]):
    state_schema = GlobexAgentState

    async def abefore_agent(
        self,
        state: GlobexAgentState,
        runtime: Runtime[GlobexRuntimeContext],
    ) -> dict[str, Any] | None:
        ctx = await harness.run("on_session_start", {
            "state": state,
            "runtime": runtime,
            "user_id": runtime.context.user_id,
            "thread_id": runtime.execution_info.thread_id,
        })
        return ctx.get("state_update")

    async def abefore_model(
        self,
        state: GlobexAgentState,
        runtime: Runtime[GlobexRuntimeContext],
    ) -> dict[str, Any] | None:
        ctx = await harness.run("pre_think", {
            "state": state,
            "runtime": runtime,
            "messages": state["messages"],
        })
        return ctx.get("state_update")

    async def aafter_model(
        self,
        state: GlobexAgentState,
        runtime: Runtime[GlobexRuntimeContext],
    ) -> dict[str, Any] | None:
        ctx = await harness.run("post_reflect", {
            "state": state,
            "runtime": runtime,
            "response": state["messages"][-1],
        })
        return ctx.get("state_update")

    async def aafter_agent(
        self,
        state: GlobexAgentState,
        runtime: Runtime[GlobexRuntimeContext],
    ) -> dict[str, Any] | None:
        ctx = await harness.run("on_session_end", {
            "state": state,
            "runtime": runtime,
            "final_answer": state["messages"][-1].content,
        })
        return ctx.get("state_update")
这样每次 ReAct Agent 调 LLM 前,都会先跑 pre_think,用于注入 token 降级 hint、漂移纠正信号、阶段约束等;每次 LLM 返回后,会跑 post_reflect,用于循环检测、漂移检测、预算检查和阶段转移。会话开始和结束的逻辑则由 before_agent / after_agent 负责。模型真正看到的上下文窗口由后面的 GlobexContextMiddleware 在进入模型前统一整理。
Context Compression
Globex 不把上下文压缩拆成另一套官方摘要 middleware,而是统一放进 GlobexContextMiddleware。它在每轮 LLM 调用前运行,负责把 LangGraph State 里的任务状态、工作记忆和消息轨迹,整理成模型真正能看到的 messages 窗口。
先把几个名字分清楚:
GlobexAgentState
├─ messages             对话轨迹:HumanMessage / AIMessage / ToolMessage
├─ task_state           结构化任务状态:目标、预算、平台、当前阶段
├─ hot_context          热上下文:刚从工具观察到、下一轮马上要用的信息
├─ working_memory       工作记忆:已确认偏好、阶段性结论、稳定历史摘要
├─ cold_data            冷数据引用:原始大结果的文件路径或对象引用
└─ compression_stats    压缩统计:上次摘要步数、摘要策略、轮次计数
新的用户输入只走 messages:
await agent.ainvoke(
    {"messages": [{"role": "user", "content": query}]},
    config={"configurable": {"thread_id": thread_id}},
)
这不是把 query 直接塞进整个 state,而是提交了一次 messages 字段的增量更新。messages 有 message reducer,新用户消息会追加到 state["messages"];模型回复的 AIMessage、工具返回的 ToolMessage 也继续追加到这里。
业务字段不是自动从消息里长出来的。Planner、工具、Reflect 或 middleware 要显式返回 state update,才会更新 task_state / hot_context / working_memory / cold_data。例如一次商品搜索通常会拆成三份:
原始搜索结果很大
  -> 落盘,路径写入 cold_data.last_search_result

下一轮马上要用的 Top-N 摘要
  -> 写入 hot_context.latest_observation

模型需要知道“刚发生了什么”
  -> 写成 ToolMessage 追加到 messages
代码形态大概是:
return Command(update={
    "hot_context": {"latest_observation": compact_items},
    "cold_data": {"last_search_result": path},
    "messages": [
        ToolMessage(
            content=f"找到 {len(raw_items)} 个候选,已压缩保留 Top-N,原始结果:{path}",
            tool_call_id=runtime.tool_call_id,
        )
    ],
})
所以每轮调用模型前,GlobexContextMiddleware.abefore_model 做的事情不是“把整个 State 发给模型”,而是从 State 里挑出模型该看的部分,重新拼出一个上下文窗口:
window = build_llm_context_window(
    task_state=state.get("task_state", {}),
    hot_context=state.get("hot_context", {}),
    working_memory=state.get("working_memory", {}),
    messages=state["messages"],
    cold_data=state.get("cold_data", {}),
)
拼出来的顺序固定为:
system_prompt(由 create_agent 维护)
TASK STATE
LATEST OBSERVATION
WORKING MEMORY
STABLE HISTORY SUMMARY
----- Cache Breakpoint -----
RECENT TOOL MESSAGES(最近 K=3 条工具调用与工具结果)
CURRENT USER REQUEST
这里有两个关键点:
system_prompt由create_agent(system_prompt=...)维护,不是业务 state 的一部分。CURRENT USER REQUEST仍然来自state["messages"]里的最新 HumanMessage,只是在拼窗口时被放到最后。
压缩只在满足条件时触发。条件满足任一即可:
- Breakpoint 后动态区 > 15K token。
- 总上下文 > 60K token。
- 连续 M=5 轮没有做过 L3 会话压缩。
触发 L3 后,也不是把 task_state / hot_context / working_memory / cold_data 全部压掉。真正被摘要的是较旧的动态消息历史;结构化状态更多是作为摘要输入,帮助摘要保留任务目标、约束和关键结论。
recent_tool_uses = keep_recent_tool_uses(
    messages=state["messages"],
    k=3,
)

summary = await summarize_old_dynamic_history(
    messages=messages_before(recent_tool_uses, state["messages"]),
    task_state=state.get("task_state", {}),
    working_memory=state.get("working_memory", {}),
    cold_data=state.get("cold_data", {}),
)
摘要生成后,会沉淀到稳定区:
working_memory = {
    **state.get("working_memory", {}),
    "stable_history_summary": summary,
}
然后重新构建窗口,并替换 messages:
rebuilt = build_llm_context_window(
    task_state=state.get("task_state", {}),
    hot_context=state.get("hot_context", {}),
    working_memory=working_memory,
    recent_tool_uses=recent_tool_uses,
    cold_data=state.get("cold_data", {}),
)

return {
    "working_memory": working_memory,
    "messages": [
        RemoveMessage(id=REMOVE_ALL_MESSAGES),
        *rebuilt.messages,
    ],
    "compression_stats": {
        "last_summary_at_step": runtime.execution_info.step,
        "rounds_since_summary": 0,
        "strategy": "cache_breakpoint_l3",
    },
}
RemoveMessage(id=REMOVE_ALL_MESSAGES) 这一步很重要。因为 messages 默认是追加 reducer,如果只返回新的 rebuilt.messages,它会继续 append 到旧窗口后面,压缩就失效了。正确做法是先清空旧消息窗口,再追加重建后的上下文窗口。
最终可以把这条链路理解成:
用户新消息
  -> 追加到 state["messages"]

Planner / 工具 / Reflect
  -> 更新 task_state / hot_context / working_memory / cold_data

每轮 LLM 前
  -> GlobexContextMiddleware 读取这些字段
  -> build_llm_context_window 拼出模型可见 messages

触发压缩
  -> 旧动态 messages 摘要进 working_memory.stable_history_summary
  -> 保留最近 K=3 条工具消息原文
  -> RemoveMessage 清空旧窗口
  -> 写入 rebuilt.messages

checkpoint
  -> 按 thread_id 保存新的 state
runtime metadata、trace、request_id、debug 信息不要进 messages,放 runtime.context 或不可见状态字段。模型应该看到的是任务上下文,不是后端运行日志。
AgentState、消息和 checkpoint
create_agent 默认 state 里已经有 messages,它使用 LangGraph 的 message reducer:新消息会追加,同 ID 消息会覆盖。项目里要扩展业务字段时,直接继承 AgentState:
from typing import Annotated, Any, Literal
from typing_extensions import NotRequired
from langchain.agents.middleware import AgentState
from pydantic import BaseModel


def merge_dict(left: dict | None, right: dict | None) -> dict:
    return {**(left or {}), **(right or {})}


class GlobexAgentState(AgentState):
    task_state: NotRequired[Annotated[dict[str, Any], merge_dict]]
    hot_context: NotRequired[Annotated[dict[str, Any], merge_dict]]
    working_memory: NotRequired[Annotated[dict[str, Any], merge_dict]]
    cold_data: NotRequired[Annotated[dict[str, str], merge_dict]]
    compression_stats: NotRequired[Annotated[dict[str, Any], merge_dict]]
    loop_count: NotRequired[int]
    current_phase: NotRequired[Literal["search", "compare", "recommend", "final"]]


class GlobexRuntimeContext(BaseModel):
    user_id: str
    session_dir: str
    locale: str
每次调用时复用同一个 thread_id,LangGraph 就会把这一轮的 messages、task_state、working_memory 等 state 从 checkpoint 恢复出来,再把新的输入 append 进去。服务重启、超时恢复、人工中断续跑,都靠这个 thread_id 找回状态。
Prompt Engineering
同一段 system prompt,一次任务里可能被送进模型三四十次。这意味着:
- prompt 里任何一句模糊的话,会在几十轮里持续误导模型;
- prompt 里任何一个多余的段落,会在几十轮里持续烧 token;
- prompt 里任何一条没被遵守的约束,会在几十轮里反复翻车。
所以 Agent 的 prompt 不是“问法”,而是一份契约:它定义了这个 Agent 在整个生命周期里的角色、边界、行为准则和工具使用规则。一个好 prompt 的基本要求:
| 要求 | 含义 | 反例 |
|---|---|---|
| 稳定 | prompt 前缀要尽量固定,别每轮都变(否则缓存全废) | 在 system prompt 里拼当前时间戳 |
| 精确 | 每条规则都要可判定,别写“尽量”“适当”“合理” | “适当的时候调用子 Agent” |
| 分层 | 按职责和易变性分层,便于维护和缓存 | 把工具描述、安全约束、示例全揉成一大段 |
system-prompt
system prompt 由这几部分组成:
| 段落 | 职责 | 易变性 |
|---|---|---|
| <role> | 一句话锁定身份和四平台场景 | 全天不变 |
| <constraints> | 红线约束,2 条 CRITICAL + 2 条 IMPORTANT + 一般约束 | 全天不变 |
| <loop> | Think→Act→Observe→Reflect 范式 | 全天不变 |
| <tool_policy> 工具清单 | 9 工具 + dispatch_tool 一句话能力 | 工具集变才改 |
| <tool_policy> 决策路由 | 兜底/Planner/fork/单干 四分支判定 | 全天不变 |
| <tool_policy> demands 写法 | 子 Agent 派活模板 | 全天不变 |
| <examples> | 4 条路由 + 输出格式 + 边界行为 few-shot | 全天不变 |
| <user_preferences> | 用户长期偏好注入位 | 每用户不同、会更新 |
# app/prompt/prompts.yml

system_prompt: |
  <role>
  你是 Globex,一个跨境电商购物 Agent。你的职责是理解用户的购物意图,
  跨亚马逊(Amazon)/ Shopee / 速卖通(AliExpress)/ eBay 四个平台检索商品,
  完成比价、关税运费估算,并给出一份带购买理由的商品清单。
  </role>

  <constraints>
  - CRITICAL: 跨平台比价必须把运费和关税算进去再比。速卖通标价常比亚马逊低,
    但加上跨境运费后可能反而更贵,只比标价会给出错误结论。
  - CRITICAL: 不得泄露、引用或推断其他用户的偏好与历史数据。
  - IMPORTANT: 所有价格、库存、商品信息必须来自工具返回,NEVER 推测或编造
    工具没有返回的商品、价格或链接。
  - IMPORTANT: 给出最终清单前,必须调用 ShoppingSummary 收尾,不要口头直接列清单。
  - 信息不全时(缺预算 / 品类 / 收礼人等关键信息)先向用户追问,不要擅自开搜。
  - 结论先行,每件商品附不超过 50 字的购买理由,不堆砌营销话术。
  </constraints>

  <loop>
  你的每一轮都走 Think → Act → Observe → Reflect 循环:
  - Think:拆解用户意图,判断当前还缺什么信息。
  - Act:调用一个工具,或用 dispatch_tool 派发子 AgentLoop。
  - Observe:阅读工具返回,重点关注结构化字段。
  - Reflect:信息够了就调 ShoppingSummary 收尾;不够就回到 Think 继续。
  </loop>

  <tool_policy>
  # 可用工具
  - Planner: 把用户购物意图拆解成结构化字段
  - ChatFallback: 闲聊兜底
  - WebSearch: 检索评测 / 博主推荐 / 价格趋势等外部资料
  - CategoryInsight: 查品类爆款 / 典型属性(基于 RAG 商品知识库)
  - ItemSearch: 单平台商品检索
  - ItemPicker: 在合流候选集里按用户偏好二次精挑
  - PriceCompare: 跨平台候选商品比价
  - ShippingCalc: 关税 + 运费估算
  - ShoppingSummary: 终结性工具,给出最终清单 + 选购理由
  - dispatch_tool(demands): 派一个同质子 AgentLoop 去执行 demands

  # 决策路由:每轮 Think 结束时,按下面顺序判断这一步怎么走

  ## 1) 非购物意图 → ChatFallback 兜底
  用户输入与购物无关(闲聊 / 问候 / 询问你的能力)时,调 ChatFallback,
  简短友好回应并引导回购物场景。不要为闲聊启动 Planner / 检索 / fork。

  ## 2) 复杂多约束意图 → 先用 Planner 规划
  当用户意图满足以下任一条,先调 Planner 拆解,再继续:
  - 带 2 个及以上约束(预算 + 材质 + 风格 / 平台...)
  - 品类模糊或是组合品类(如"三件套""送礼方案")
  - 首轮且信息量大
  只有单一、明确的查询("看看 XX 多少钱")才跳过 Planner。

  ## 3) 满足 fork 三件事 → dispatch_tool 派子 AgentLoop
  当下一步子任务满足以下任一条,调 dispatch_tool(demands="..."):
  1. 能并行:多个独立检索可同时跑(如跨 4 平台 ItemSearch)
  2. 要隔离:子任务输出很大,会占满主 loop 上下文(如拉 100 件精挑)
  3. 链够深:子任务内部还要 >= 3 轮 Think→Act
  # When NOT to fork(同等重要)
  - 单步就能完成的原子操作 → 直接单干,别 fork
  - 只是想"换个工具调一下" → 直接调那个工具,别 fork
  - 子任务输出很小、不需要隔离 → 直接单干
  fork 有开销(起子 loop + 上下文传递),鸡毛蒜皮别 fork。

  ## 4) 其余情况 → 主 Agent 直接单干
  当下一步是"单个原子操作"时,直接调对应工具,不要 Planner、不要 fork:
  - 单平台、品类明确的检索 → 直接 ItemSearch
  - 候选已合流回主 loop → 直接 PriceCompare / ShippingCalc / ItemPicker
  - 已到收尾条件 → 直接 ShoppingSummary
  判断口诀:一步能拿到结果、且不需要隔离大输出,就自己干。

  # dispatch_tool 的 demands 写法
  demands 必须自包含(不依赖主 loop 隐含上下文),写清平台、品类、硬约束、
  软偏好、期望产出,并在结尾指定"返回不超过 N 条的候选摘要,每条含
  名称/价格/平台/关键卖点,不要回传原始 API 全量响应"。
  </tool_policy>

  <examples>
  <example>  # 走"单干"
  user: 亚马逊上那款 XX 键盘现在多少钱
  assistant: [Think: 单平台、品类明确 → 直接 ItemSearch(amazon)]
  </example>

  <example>  # 走"Planner"
  user: 想买套便宜又抗造的旅行三件套,预算300,不要塑料
  assistant: [Think: 多约束 + 组合品类 → 先 Planner 拆解]
  </example>

  <example>  # 走"fork"
  user: 这个背包亚马逊、Shopee、速卖通、eBay 哪个划算
  assistant: [Think: 四平台可并行 → dispatch_tool fork 4 路 ItemSearch]
  </example>

  <example>  # 走"兜底"
  user: 你好,你是谁
  assistant: [Think: 非购物 → ChatFallback]
  </example>

  <example>  # 输出格式
  user: 帮我看看有没有便宜点的机械键盘
  assistant: 给你挑了 3 把(含运费,可直邮):
  1. XX 机械键盘 ¥219(Amazon)——热插拔轴,预算内最耐用
  2. ...
  </example>

  <example>  # 边界行为:信息不全先问
  user: 帮我买个好点的礼物
  assistant: 想先确认几点好帮你精准挑:送谁?预算多少?有没有偏好的品类?
  </example>
  </examples>

  <user_preferences>
  下面是该用户已沉淀的长期偏好(可能为空),请在检索与精挑时遵守:
  {long_term_preferences}
  </user_preferences>
读完上面的代码我们可能有一些疑惑:决策层路由为什么要这个顺序?constrain 为什么放 loop 前面?为什么 example 在 user_preferences 前面?以及 user_preferences 怎么找回和写入?
全文里路由的判断顺序是刻意设计的,不是随便排的:
- 先排除非购物(兜底)——最省,一眼能判,不用往下走
- 再判要不要规划(Planner)——决定后续所有工具能不能拿到干净字段
- 再判要不要 fork——决定这一步是并行还是串行
- 都不满足才单干——默认分支
红线约束(constraints)必须在范式说明(loop)之前——因为约束是"任何时候都不能破"的,而 loop 是"怎么干活"的流程。先立规矩,再教方法。
examples 是全天不变的静态内容,user_preferences 是每用户不同的动态内容。按 19-3 的静态→动态排布规律,静态的 examples 必须在动态的 user_preferences 前面,这样 examples 才能进缓存前缀被所有用户共享。
长期记忆 user_preferences 是主 AgentLoop 创建之前召回,并不是全量召回,召回最相关的 $\text{Top} - N$。
召回:会话开始时,store.read_relevant(user_id, query) 召回相关 Top-K 偏好,注入 system prompt。
使用:主 Agent、ItemPicker、ShoppingSummary 在搜索、过滤、排序和推荐时参考这些偏好。
写入:任务收尾时,主 Agent 把本轮新识别的可复用偏好放入 shopping_summary.new_preferences,由 run_agent 写入 Store。
class ShoppingSummaryOutput(BaseModel):
    final_text: str
    picks: list[PickedItem]
    learned_preferences: list[str]
除此之外,system-prompt 里面的内容也要分层缓存。
Breakpoint 用 cache_control 实现,根据落点原则和 prompt 设计
断点 1:工具 schema 之后(工具定义全天不变,1h TTL)
断点 2:
断点 3:早期对话历史末尾(每轮往后挪,5 分钟 TTL)
断点 4:预留给特别大的稳定工具结果(如一次 CategoryInsight 知识块)
meta-prompt
不只是 Agent 的一个 system prompt。凡是“用 LLM 去处理另一段内容”的地方,都需要一段提示词,我们叫它元提示词(meta-prompt)。它们往往被忽视,但质量直接影响主链路。如 Context Engineering 里面的 Planner prompt,工具结果压缩,长上下文全量压缩,Rubric评分…
1.Planner
Planner 等工具的提示词就相对 system-prompt 轻量太多了,重点强调 JSON 输出。当然 prompt 约束 JSON 输出只是一层面, 还有代码层面的 Pydantic 解析校验与重试机制,以及底层 API 提供的结构化输出(Structured Output)强制约束。
# Planner 元提示词:强制结构化 JSON 输出
planner_prompt: |
  你是 Globex 的 Planner。把用户购物意图拆成严格的 JSON,字段固定:
  {
    "budget": number | null,
    "category": string,
    "material_pref": {"exclude": string[], "prefer": string[]},
    "style_pref": string | null,
    "platforms": string[],
    "hard_constraints": string[],
    "soft_preferences": string[]
  }

  规则:
  - 只输出 JSON,不要任何解释文字。
  - 用户没提到的字段填 null 或空数组,NEVER 编造。
  - 预算若为区间取上限。
2. Tool Result Summary
对应 Context Engineering 里的 L2 Cache-Aware 微压缩, tool result 不是无脑进入 LLM Context,而是先经过一次治理。 L0 在工具出口控制返回体积,大结果落盘;L2 在进入动态上下文前判断是否需要精简,只对冗余、重复、过长的工具结果做字段裁剪或 Top-N 压缩。这样近期工具结果还能保留决策价值,又不会撑爆 Breakpoint 后面的动态区。
# 工具结果精简元提示词:先判断要不要压,再压
tool_result_compress_prompt: |
  判断这段工具返回是否需要精简:
  - 若为大量重复 / 冗余字段(如 100 件商品的完整描述)→ 需要精简,
    只保留 名称 / 价格 / 评分 / 平台。
  - 若为已经很精简的结构化结果 → 不精简,原样保留。
  输出 <should_compress>true/false</should_compress> + <kept_fields>...</kept_fields>
3. Session Summary
对应 Context Engineering 里的 L3 会话压缩,总结的对象不是单条 tool_result,而是一段会话过程。 用于对话太长,即将超出长下文窗口时,这是最贵的。
补充一下,什么时候调用,满足之一触发全量总结:
- 当Breakpoint后暂存区内容 > 15 K
- 总上下文长度超过60K
- 已经M=5轮没压缩过
仍然保持最近K=3条工具在breakpoint之后,因为最可能被下一次会话用到。
# 会话摘要元提示词:结构化八段式(防止约束丢失)
session_summary_prompt: |
  把当前购物会话总结成以下固定结构:
  1. 用户核心需求(品类 / 预算 / 平台)
  2. 已确认的硬约束和软偏好
  3. 已检索的平台和候选概况
  4. 已排除的商品和原因
  5. 当前进行到哪一步(对应 Think→Act→Observe→Reflect)
  6. 下一步计划
  只输出结构化摘要,不要寒暄。
4. Shopping Summary
Shopping summary 也是输出结构化 JSON,包含:
- 最终推荐文本 md
- 商品信息(展示和交互用)
- 偏好收集
# ShoppingSummary 元提示词:终结性结构化输出
shopping_summary_prompt: |
  你是 Globex 的 ShoppingSummary 工具。基于已收集的候选商品、价格结果、运费关税结果和用户偏好,
  生成本轮购物任务的最终总结。

  只输出严格 JSON,不要输出任何解释文字。字段固定为:
  {
    "final_text": string,
    "picks": [
      {
        "name": string,
        "platform": string,
        "landed_cny": number,
        "shipping_included": boolean,
        "duty_included": boolean,
        "direct_shipping": boolean,
        "reason": string
      }
    ],
    "learned_preferences": string[]
  }

  字段规则:
  - picks 最多 3 件,只能来自已收集的候选商品,不能编造商品、价格、平台或直邮信息。
  - landed_cny 必须是含运费和关税后的到手价;如果缺少运费或关税信息,不得假装已包含。
  - reason 每件商品不超过 50 字,说明为什么符合用户需求。
  - final_text 用 Markdown 写给用户看,必须说明价格是否含运费关税、是否可直邮。
  - learned_preferences 只放本轮明确、可复用的长期偏好,例如“不接受塑料材质”“偏好小众设计”。
  - 不要把一次性任务条件、临时商品名称、当前平台搜索过程写入 learned_preferences。
5. Rubric Judege
用强模型,且 $tempature = 0$,必须严格稳定。
# Rubric judge 元提示词:评分(完整体系见第 8 章)
rubric_judge_prompt: |
  你是 Globex 的评分员。根据下面动态生成的评分细则给 Agent 回答打分:
  <rubric>
    P0(必须满足,否则判 0 分):{p0_items}
    P1(重要):{p1_items}
    P2(加分项):{p2_items}
  </rubric>
  逐条判定,输出每条命中情况 + 总分 + 简短理由。
Context Engineering
为什么要有 Context Engineering?核心是控制模型每一轮“看见什么、不看见什么、以什么结构看见”。
主要收益可以分成成本和质量两类:
- 节约 token,降低输出前的上下文处理时间和整体延迟
- 保持稳定前缀,尽可能命中 Prompt Cache,降低算力和调用成本
- 减少无关信息进入窗口,降低模型幻觉和注意力分散
- 把任务目标、约束、工具结果结构化,让模型知道下一步该干什么,减少瞎猜
上下文治理的核心不是“尽量塞更多历史”,而是把信息分层:
Runtime Context:后端运行需要,模型不看
Session Context:Agent 内部状态账本,可 checkpoint
LLM Context:每轮真正发给模型的 messages 窗口
Long-term Memory:跨会话复用的稳定偏好和经验
其中最容易混的是 Session Context 和 LLM Context。
Session Context 是 LangGraph State 里和任务有关的内部状态:
state
├─ messages             原始对话轨迹和工具轨迹
├─ task_state           任务结构:目标、预算、平台、阶段
├─ hot_context          热观察:最新工具结果摘要、当前约束
├─ working_memory       已确认结论、稳定历史摘要
├─ cold_data            大结果引用
└─ compression_stats    压缩统计
LLM Context 是 GlobexContextMiddleware 每轮从 Session Context 里挑出来、重新排列、必要时压缩后的模型输入:
system_prompt
TASK STATE
LATEST OBSERVATION
WORKING MEMORY
STABLE HISTORY SUMMARY
----- Cache Breakpoint -----
RECENT TOOL MESSAGES
CURRENT USER REQUEST
所以新消息的流转不是“用户说一句,就把整段历史直接传给模型”。实际链路是:
1. 用户新消息
   -> 追加到 state["messages"]

2. Planner 解析意图
   -> 写入 state["task_state"]
   -> 明确的预算、材质偏好、平台约束也会沉淀到 working_memory.confirmed_preferences

3. 工具执行
   -> 简短 observation 追加到 state["messages"]
   -> 下一轮马上要看的 Top-N、最低价、到手价等摘要写入 state["hot_context"]
   -> 原始大结果引用写入 state["cold_data"]

4. Reflect / 状态机
   -> 把已确认偏好、排除理由、阶段性结论写入 state["working_memory"]
   -> 比如“塑料材质已排除”“后续只比较可直邮”“下一步进入 PriceCompare”
   -> 更新 task_state.current_step

5. 模型调用前
   -> GlobexContextMiddleware 读取 state
   -> build_llm_context_window 拼出 LLM Context

6. 满足压缩条件
   -> 旧动态 messages 摘要为 working_memory.stable_history_summary
   -> 最近 K 条工具消息保留原文
   -> 重建 messages 窗口并 checkpoint
这里的边界是:hot_context 偏“刚观察到、马上要用”,通常来自工具 observation 和运行时约束整理;working_memory 偏“已经确认、后面要遵守”,通常来自 Planner 归纳、Reflect、ItemPicker 决策和 L3 压缩摘要。工具刚看到的东西先进 hot_context,经过筛选、确认、总结后,才进入 working_memory。
对于“旅行三件套,预算 300,不要塑料,Amazon 和 AliExpress 都看看”这样的任务,Planner 先把自然语言拆成购物意图:
planner_output:
  budget: 300
  category: "旅行三件套"
  material_pref:
    exclude: ["塑料"]
  platforms: ["Amazon", "AliExpress"]
  hard_constraints:
    - "优先直邮"
随后 State Builder / LangGraph reducer / 状态机会把它归一化成内部 task_state:
task_state:
  goal: "推荐旅行三件套"
  budget_cny_max: 300
  platforms: ["Amazon", "AliExpress"]
  constraints:
    - "不要塑料"
    - "优先直邮"
  current_step: "search"
工具跑完后,Session Context 会逐步长成这样:
task_state:
  goal: "推荐旅行三件套"
  budget_cny_max: 300
  platforms: ["Amazon", "AliExpress"]
  current_step: "price_compare"

hot_context:
  latest_observation:
    - "Amazon 返回 20 个候选,Top-N 已保留"
    - "AliExpress 返回 18 个候选,Top-N 已保留"
  active_constraints:
    - "仅比较可直邮商品"

working_memory:
  confirmed_decisions:
    - "两平台候选都已过滤塑料材质"
    - "后续只比较价格、运费和税费"
  stable_history_summary:
    - "用户需要旅行三件套,预算 300 元以内,不要塑料,优先直邮。Amazon / AliExpress 已完成召回。"

cold_data:
  amazon_raw_result: "output/session_xxx/amazon.json"
  aliexpress_raw_result: "output/session_xxx/aliexpress.json"
模型最终看到的是重新拼出来的窗口,而不是上面这个 state 原样:
SYSTEM
  你是跨境购物 Agent。遵守工具调用与推荐规则。

TASK STATE
  goal: 推荐旅行三件套
  budget: <= 300 CNY
  platforms: [Amazon, AliExpress]
  current_step: price_compare

LATEST OBSERVATION
  - Amazon 返回 20 个候选,Top-N 已保留
  - AliExpress 返回 18 个候选,Top-N 已保留
  - 已过滤塑料材质

WORKING MEMORY
  - 后续只比较可直邮商品
  - 重点比较价格、运费、税费和评分

STABLE HISTORY SUMMARY
  - 用户需要旅行三件套,预算 300 元以内,不要塑料。
  - Amazon / AliExpress 已完成商品召回。

----- Cache Breakpoint -----

RECENT TOOL MESSAGES
  assistant: 调用 item_search(Amazon)
  tool: Amazon Top-5 候选摘要
  assistant: 调用 item_search(AliExpress)
  tool: AliExpress Top-5 候选摘要

CURRENT USER REQUEST
  继续比较亚马逊和速卖通候选商品。
Cache Breakpoint
system prompt 分层管“固定规则”,Cache Breakpoint 管“会话历史”;目的都和缓存稳定性有关,但前者偏提示词工程,后者偏上下文窗口治理。
在上下文过长时,如果随意压缩消息,前缀就会变化,导致 Prompt Cache 失效。实测结果:
| 指标 | 不压缩 | 盲目压缩 | Cache Breakpoint |
|---|---|---|---|
| token 数 | 80K | 56K | 60K |
| 压缩率 | 0% | 30% | 25% |
| 缓存命中率 | 85% | 15% | 80% |
| 实际计费 token | 12K | 47.6K | 12K |
| 综合成本 | 基准 | +297% | -35% |
关键理解: 实际计费 token = 总 token × (1 - 缓存命中率 × 折扣)。缓存命中的部分按半价或免费计费,所以命中率才是决定成本的关键变量。
Cache Breakpoint(缓存转折点)就是为了解决“既要压缩上下文,又不能破坏 Prompt Cache”这个矛盾。
它的核心思路是把上下文分成两块:
- Breakpoint 前:稳定前缀,尽量不动,用来提高 Prompt Cache 命中率。
- Breakpoint 后:动态尾部,保留最近关键消息;当动态尾部继续变长时,再把较旧部分压缩成新的稳定摘要。
这里要把两个名字分清楚:旧消息压缩后的结果叫 STABLE HISTORY SUMMARY,放在 Breakpoint 前,属于低频更新的稳定前缀;最近 K 条工具调用与工具结果叫 RECENT TOOL MESSAGES,放在 Breakpoint 后,属于当前决策还要直接使用的热消息。
Breakpoint 后是动态暂存区,用来承接最近产生的工具调用、工具结果和当前用户请求。新的 tool_result 进入前会先经过 L0 落盘和 L2 工具结果精简。压缩前,Breakpoint 后可以暂存多条工具调用与工具结果;只要动态暂存区没有超过阈值,就不急着做 L3 总结,避免频繁改写稳定前缀,也避免成本过大。
但旧工具结果不会每次被挤出就立刻总结。L3 会话压缩是低频批量触发,只有满足以下任一条件时才执行:
- Breakpoint 后动态暂存区超过 15K token
- 总上下文长度超过 60K token
- 已经连续 M=5 轮没有做过会话压缩
触发 L3 后,GlobexContextMiddleware.abefore_model 会把“除最近 K=3 条工具调用与工具结果之外的较旧动态历史”总结成新的 Stable History Summary,沉淀到 Breakpoint 前方;最近 K=3 条工具调用与工具结果仍保留在 Breakpoint 后方。
[ Stable History Summary ]  ← Breakpoint 前:稳定、可缓存、低频更新
--------- Cache Breakpoint ---------
[ 最近 K=3 条工具调用与工具结果 ] ← Breakpoint 后:动态、经 L0/L2 精简
[ 当前用户请求 ]             ← 永远变化,不缓存
上下文窗口的管理原则可以收束成几条:
- 不该进入 LLM messages 的不要进:日志、trace、thread_id、request_id、调试信息等。这些属于运行时上下文,不属于模型上下文。
- 大工具结果不要全量塞进窗口:原始结果落盘,只给模型 Top-N、摘要、关键字段、
truncated标记和文件引用。 - 旧消息按价值处理:低价值消息直接丢弃;有决策价值但太长的历史压缩成摘要;当前用户需求、硬约束、最近关键工具结果必须保留。
- 稳定内容尽量放在前缀:system prompt、工具规则、少量长期偏好、稳定任务摘要,以提高 Prompt Cache 命中率。
- 长期记忆不要等于长聊天记录:只把可复用的用户偏好、黑名单、预算习惯等结构化存入 Store,下次按 query 召回相关记忆再注入。
| 层 | 名称 | 做什么 | 成本 | 对应信息层 |
|---|---|---|---|---|
| L0 | 工具侧防线 | 控制工具返回体积,大内容写文件而非注入上下文 | 零 | cold_data / hot_context 入口 |
| L1 | 工程手段 | 动态 max_tokens、断点续传、服务端缓存 | 零 | 模型请求层 / hot_context |
| L2 | Cache-Aware 微压缩 | 在 Breakpoint 之后对近期工具结果做轻量压缩 | 低 | hot_context / recent tool messages |
| L3 | 会话压缩 | 当上下文逼近阈值时,用 LLM 做阶段性摘要 | 中,一次 LLM 调用 | message_history → working_memory |
| L4 | Session Memory | 维护结构化任务状态和会话内记忆,替代全量历史 | 低,增量更新 | task_state / working_memory |
Eval
Benchmark 不能只看 token 降了多少。 如果一个方案只是把 prompt 变短,但恢复后经常忘记用户约束、改错平台、漏掉失败工具,那它不叫上下文治理,只是把问题藏起来了。
Globex 评估上下文治理方案时,会同时看四类指标:
| 指标 | 看什么 | 失败信号 |
|---|---|---|
| 任务成功率 | 最终是否完成跨平台检索、比价和推荐 | token 降了,但回答经常缺商品、缺价格、缺理由 |
| 约束遗漏率 | 用户约束是否被保留,例如预算、平台、材质偏好 | 用户第一轮说"不要塑料",后面又推荐塑料商品 |
| 中断恢复成功率 | 服务重启或子 Agent 超时后,能否从 Checkpoint 继续 | 任务从头跑、重复调用工具、丢失当前计划 |
| 单位任务成本与延迟 | 每次完整任务的 token 成本、TTFT、端到端耗时 | token 省了,但首 token 更慢,或摘要调用把延迟吃回去 |
对应到 Globex 的实测:
缓存命中率:15% → 80%+
综合 token 成本:降低 35%
任务完成率:71% → 89%(配合 LoopDetector / 工具超时 / 截断策略)
约束遗漏率:重点看预算、平台、材质偏好三个字段
恢复成功率:通过 thread_id + checkpoint_id 验证长任务能否断点续跑
Middleware
Globex 的 Hook 体系保留 HarnessMiddleware 这层业务抽象,由 LangChain middleware 统一调用。也就是说:
LangChain AgentMiddleware
  -> 调用 Globex HarnessMiddleware
  -> 执行业务 hook
  -> 返回 state update / ToolMessage / Command
Hook 点有 6 个,对应到 middleware 的不同挂载位置:
| Hook 点 | 触发时机 | 主要做什么 |
|---|---|---|
| on_session_start | before_agent | 初始化预算、线程上下文、长期偏好、阶段状态 |
| pre_think | before_model / wrap_model_call | 注入预算提示、纠偏提示、阶段约束;上下文拼接和压缩由 GlobexContextMiddleware 负责 |
| pre_tool_call | wrap_tool_call 调用 handler 前 | 工具白名单、阶段权限、参数校验、调用顺序检查 |
| post_tool_call | wrap_tool_call 调用 handler 后 | 工具结果过滤、截断、压缩、熔断记录、schema 校验、语义校验 |
| post_reflect | after_model | 循环检测、漂移检测、阶段切换、预算检查;必要时写入压缩或收束提示 |
| on_session_end | after_agent | 输出审计、长期记忆写回、LangFuse 评分、清理上下文 |
如何将 Hooks 注册成 HarnessMiddleware ?项目内部还可以继续用装饰器注册,因为这层只是业务 hook registry,和 LangChain middleware 不冲突。
首先定义 Agent 生命周期 Hook 点存入 HOOK_POINTS。HarnessMiddleware 是注册、管理和运行 hooks 的类,通过一个 dict 来管理阶段对应的 Hooks,比如 ( on_session_start,(init_budget(),..)) ,注册 hooks 钩子其实就是在这个哈希表里面对应阶段增加新的函数。
要实现装饰器注册 hooks实例化一个全局 harness = HarnessMiddleware(),装饰器内部用这个全局实例去注册:
HOOK_POINTS = [
    "on_session_start",
    "pre_think",
    "pre_tool_call",
    "post_tool_call",
    "post_reflect",
    "on_session_end",
]


class HarnessMiddleware:
    def __init__(self):
        self._hooks = defaultdict(list)

    def register(self, hook_point: str, name: str, fn, priority: int = 100):
        if hook_point not in HOOK_POINTS:
            raise ValueError(f"未知 hook_point: {hook_point}")

        self._hooks[hook_point].append((name, fn, priority))
        self._hooks[hook_point].sort(key=lambda item: item[2])

    async def run(self, hook_point: str, context: dict) -> dict:
        for name, fn, priority in self._hooks.get(hook_point, []):
            result = await fn(context)
            if result is not None:
                context = result

        return context


# 先实例化全局 middleware
harness = HarnessMiddleware()


# 再定义装饰器
def harness_hook(hook_point: str, name: str, priority: int = 100):
    def decorator(fn):
        harness.register(
            hook_point=hook_point,
            name=name,
            fn=fn,
            priority=priority,
        )
        return fn

    return decorator
调用方式不再散落在 AgentLoop 里,而是集中包进一个 AgentMiddleware:
class GlobexHarnessMiddleware(AgentMiddleware[GlobexAgentState, GlobexRuntimeContext]):
    state_schema = GlobexAgentState

    async def abefore_agent(self, state, runtime):
        ctx = await harness.run("on_session_start", {
            "state": state,
            "runtime": runtime,
        })
        return ctx.get("state_update")

    async def abefore_model(self, state, runtime):
        ctx = await harness.run("pre_think", {
            "state": state,
            "runtime": runtime,
            "messages": state["messages"],
        })
        return ctx.get("state_update")

    async def aafter_model(self, state, runtime):
        ctx = await harness.run("post_reflect", {
            "state": state,
            "runtime": runtime,
            "response": state["messages"][-1],
        })
        return ctx.get("state_update")

    async def aafter_agent(self, state, runtime):
        ctx = await harness.run("on_session_end", {
            "state": state,
            "runtime": runtime,
            "final_answer": state["messages"][-1].content,
        })
        return ctx.get("state_update")
工具调用阶段用 wrap_tool_call,不再继承 ToolNode:
class GlobexToolMiddleware(AgentMiddleware[GlobexAgentState, GlobexRuntimeContext]):
    async def awrap_tool_call(self, request, handler):
        tool_call = request.tool_call
        ctx = await harness.run("pre_tool_call", {
            "tool_name": tool_call["name"],
            "tool_args": tool_call["args"],
            "tool_call_id": tool_call["id"],
            "state": request.state,
            "runtime": request.runtime,
        })

        if ctx.get("_rejected"):
            return ToolMessage(
                content=f"[Harness 拒绝] {ctx['_reject_reason']}",
                tool_call_id=tool_call["id"],
            )

        result = await handler(request)

        ctx = await harness.run("post_tool_call", {
            "tool_name": tool_call["name"],
            "tool_result": result.content if isinstance(result, ToolMessage) else result,
            "state": request.state,
            "runtime": request.runtime,
        })

        if isinstance(result, ToolMessage) and "tool_result" in ctx:
            return ToolMessage(
                content=ctx["tool_result"],
                tool_call_id=result.tool_call_id,
                name=result.name,
            )

        return result
Hooks
1. on_session_start
Agent 开始工作前执行,用来初始化本次任务的运行上下文。
- set_thread_context(),初始化本次任务的 ContextVar,写入 thread_id 和 session_dir,让深层工具、AGUI/WebSocket 推送、子 Agent 能拿到当前任务上下文,避免多用户并发串台。
- init_budget(),初始化本次请求的 TokenBudget,记录 token 总预算、已消耗量、剩余额度和模型档位,后续用于预算检查、模型降级、压缩或提前收束。
2. pre_think
LLM 推理前触发,主要用于在每轮 Think 前注入运行时提示。它不负责拼接完整 LLM Context;上下文窗口由 GlobexContextMiddleware.abefore_model 统一构建。
- TokenBudget hint 注入,根据当前 token 预算状态给模型注入降级提示,比如进入 minimal 档时提醒模型“不要继续探索,基于已有 Observation 收笔”。
- inject_runtime_messages,统一注入运行时提示。它会根据当前 TokenBudget 状态生成降级 hint,比如进入 minimal 档时提醒模型“不要继续探索,基于已有 Observation 收笔”;同时也会把上一轮 loop_detector / drift_check / budget_check 写入的 context.inject_messages 合并到当前 messages,让模型在下一轮 Think 前看到纠偏、收笔或阶段约束提示。
3. pre/post_tool_call
工具执行前后触发,用来治理工具调用边界。
pre_tool_call:
- tool_whitelist,工具白名单校验。最先执行,如果模型幻觉出未注册工具,直接拒绝。
- phase_check,阶段权限检查。根据当前 Agent 阶段判断这个工具能不能用,比如 PLANNING 阶段不能直接调用 shopping_summary。
- schema_validate,参数 schema 校验。检查 tool_call[“args”] 是否符合工具参数定义,避免参数缺失、类型错误。
post_tool_call:
- content_filter,工具结果内容过滤,避免把敏感或不安全内容继续喂回模型。
- truncate,工具结果截断,防止单个工具返回过长导致上下文膨胀。
- breaker_record,记录工具调用成功/失败,更新工具级 CircuitBreaker 的 Closed / Open / HalfOpen 状态。
- step_assertion,单步断言检查,校验当前工具结果是否满足预期格式或业务约束。
4. post_reflect
ReAct Agent 每轮 Reflect 之后触发,用于做循环检测、目标偏移检查、token 余量检查和阶段转移。
- loop_detector,检测工具调用循环,比如连续多次调用同一个工具;触发后往下一轮注入“收笔/换思路”提示。
- drift_check,检测 Agent 行为是否偏离用户原始需求;如果轻微/严重漂移,就注入纠偏提示。
- budget_check,检查 token 预算余量,必要时写入压缩提示、降级提示或准备 fallback;真正的上下文窗口重建仍由
GlobexContextMiddleware在模型调用前执行。 - phase_transition,根据当前执行结果推动阶段流转,比如 PLANNING -> SEARCHING -> COMPARING -> CONCLUDING。
补充讲一下 drift_check ,当然不是直接用一个 Lite 模型去校验,而是规则校验,如果疑似偏移就调用 Lite 模型去校验。也不是每轮都跑,而是 3 轮跑一次。
def _computational_drift_check(query: str, actions: str, context: dict) -> str:
    """快速计算检查,返回 normal / suspicious。"""
    keywords = set(re.findall(r'\w+', query))
    action_words = set(re.findall(r'\w+', actions))
    overlap = keywords & action_words

    if len(overlap) / max(len(keywords), 1) < 0.2:
        return "suspicious"
    return "normal"
Lite 模型检测结果有三个 “正常” ,“轻量偏移”,“严重偏移”,“连续严重”。只有 “连续严重” 的时候会要求 LLM 基于已有观察,立即调用 ShoppingSummary 终止任务。
5. on_session_end
AgentLoop 收束后、最终结果返回给前端前触发,通常发生在 shopping_summary 产出结果之后。
- output_guard,最终输出审核。对应 audit_final_output() / audit_output(),用于检查并处理最终回答里的风险内容,比如内部 item_id、API Key、敏感信息泄露等。
- store_writeback,长期记忆写回。对应 writeback_preferences(),把本轮对话中识别出的新用户偏好写回 Store,供下次会话使用。
其中 store_writeback 写回的是本轮识别出的新偏好,来源通常是 shopping_summary.learned_preferences,或者从最终 trajectory / final message 里取出对应字段。
下面是按你原有结构整理后的完整版 Markdown。我尽量保留了你已有的呈现方式,只在 Evolutionary Feedback Loop、Bad Case 数据飞轮、最终闭环 里补清楚 Trace、动态 Rubric、Judge、Goodcase/Badcase 的数据流。
Agent Evolve
一个上线后不再迭代的 Agent,即便初期表现优异,也会因外部环境的动态变化而逐渐退化;这种退化并非源于代码本身的劣化,而是受限于:
- 模型升级导致的 Prompt 行为漂移
- API 更新引发的工具不兼容
- 用户需求演化带来的新场景知识缺失
- 竞品提升所推高的用户期望水位
四类退化信号:
| 退化类型 | 表现 | 典型来源 | 监控指标 |
|---|---|---|---|
| Quality Drift | Rubric 日均分持续下滑 | • 闭源模型版本升级 • 数据分布偏移 | Rubric 7日均分趋势 |
| Tool Decay | 某平台工具成功率骤降 | • 平台 API 行为变更 • 反爬策略升级 | 工具成功率滑动窗口 |
| Preference Stale | 用户偏好变了但 Agent 还按旧偏好推 | • Store 里的偏好过期 • 季节性变化 | 偏好命中率下降 |
| Context Rot | Prompt 和实际工具集不匹配 | • 新增/删除工具但 prompt 未同步 | 工具调用 404 率 |
退化通常不是断崖式的(那种容易发现),而是每天降 0.5%——连续一个月后从 79 分降到 68 分,但因为没人每天看分数曲线,等发现时已经积累了严重的用户体验损失。
自进化的核心动机:不能等人发现了再修,要让系统自己发现并自己修复。
业界 Agent 3×3 进化矩阵
What Evolves
工程原则:优先外层迭代,外层无法满足再向内层推进。外层便宜快速可逆;内层昂贵缓慢持久。
| 层级 | 内容 | 特点 |
|---|---|---|
| Layer1 External Files | 记忆、知识库、技能库、成功策略 | 低成本、即时生效、可回滚 |
| Layer2 Agent Harness | Prompt、工具定义、工作流、路由规则 | 成本中等 |
| Layer3 Model Weights | 参数知识、底层决策能力 | 成本高、迭代慢、效果持久 |
构建 Agent 系统时遵循由外向内迭代:
- 优先更新外部知识库、记忆文件(Layer1)
- 其次调整 Prompt、工作流、工具链(Layer2)
- 最后才考虑微调模型权重(Layer3)
When Persist
| 持久范围 | 作用域 | 案例 |
|---|---|---|
| Single Session | 单次会话内 | 临时 scratchpad、工具缓存 |
| Across Sessions | 同一用户、跨会话 | 用户偏好、技能库、会话 Checkpoint |
| Across Users | 全体用户群体 | 模型微调、全局 Prompt 升级 |
完整 3×3 矩阵
| External Files | Agent Harness | Model Weights | |
|---|---|---|---|
| Single Session | 临时记忆 scratchpad | 动态工具编排、会话状态机 | 极少使用:Test-time Training |
| Across Sessions | 用户偏好 Store + 个人技能库 | Prompt 版本管理、动态工具增删 | 参数化个性化(前沿方案) |
| Across Users | 共享知识库、公共策略库 | 全局默认 Prompt 迭代升级 | SFT / RL 模型训练 |
现在已有的部分
| 矩阵格子 | Globex 已有 | 还缺 |
|---|---|---|
| Files × Session | Store 跨会话持久化 | √ |
| Files × Across | Store 跨会话持久化 | 成功策略 / Skill Library |
| Files × Users | CategoryInsight RAG 知识库 | 共享策略 Commons |
| Harness × Session | 17-4 阶段状态机 / Token 预算 hint | √ |
| Harness × Across | 无 | Prompt 版本化 + A/B |
| Harness × Users | 无 | 默认 prompt 自动升级 |
| Weights × Session | $ \times $ | $ \times $(成本不合理) |
| Weights × Across | $ \times $ | $ \times $(Frontier 研究) |
| Weights × Users | SFT + RL | Bad case 飞轮持续供给 |
Evolutionary Feedback Loop
MAPE
借鉴 NVIDIA/IBM 的 MAPE(Monitor-Analyze-Plan-Execute)数据飞轮框架。
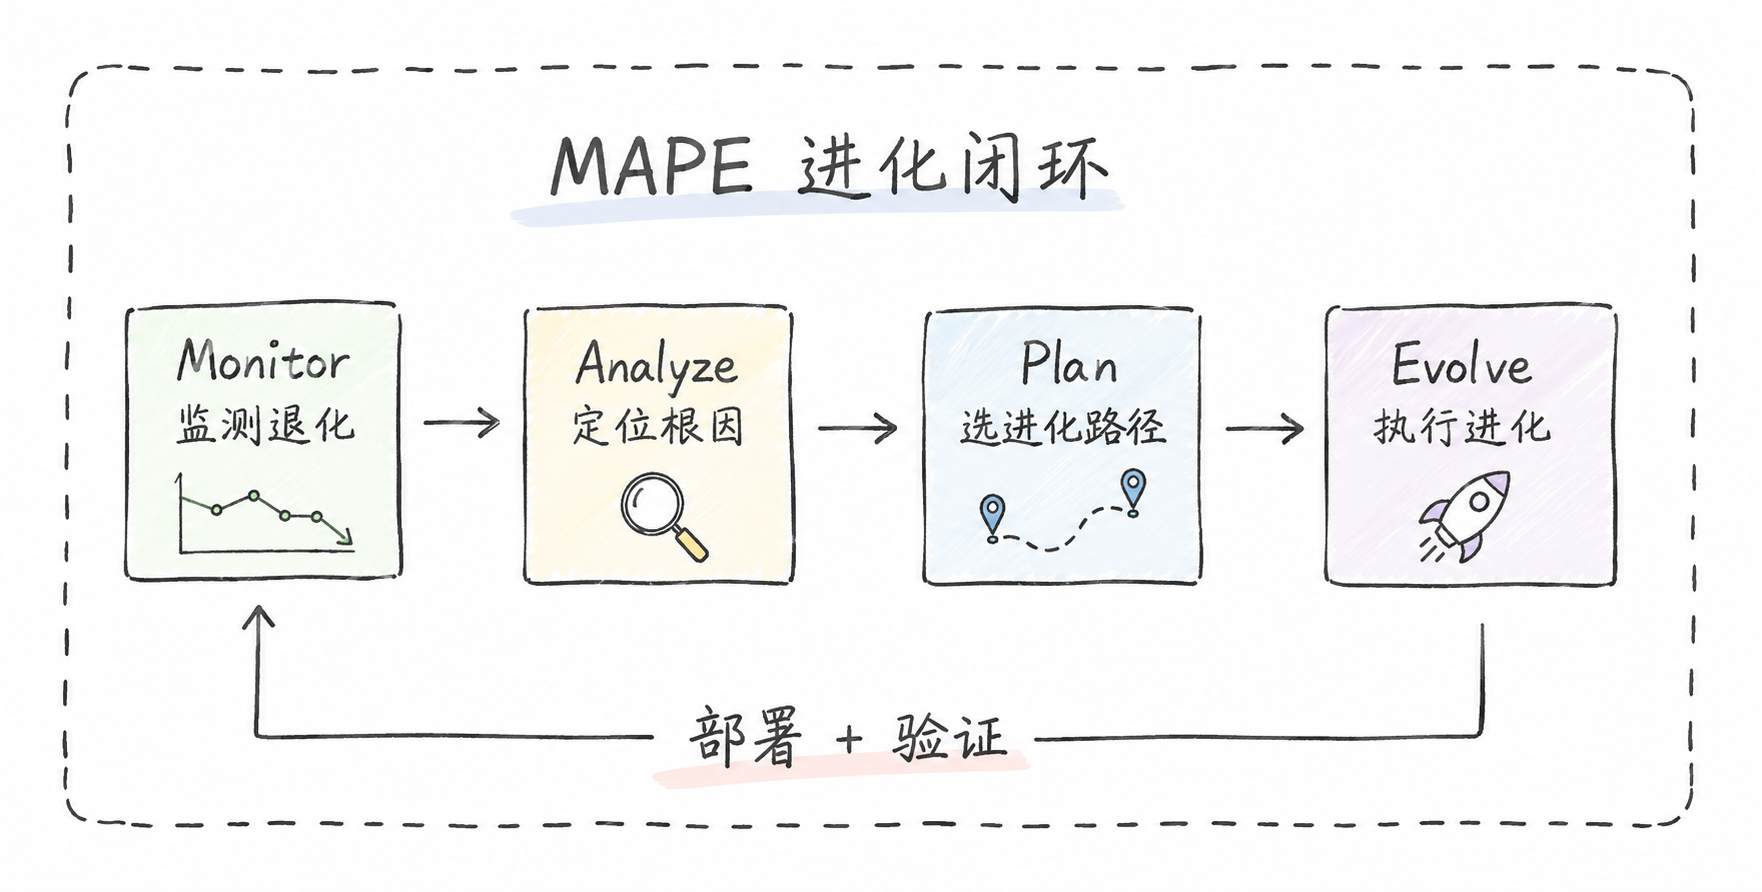
Fig. 1. MAPE
基于 MAPE 理论,每个阶段做对应工程实现:
| 步骤 | 做什么 | 依赖什么基建 |
|---|---|---|
| Monitor | • 发现 Rubric 分下降 • 工具失败率上升 • 偏好命中率下降 | LangFuse Trace / Span / Score |
| Analyze | 按 P0/P1/P2 定位根因: • 是格式问题还是决策问题 • 知识缺失 | Rubrics as Rewards 评测体系 |
| Plan | 根据根因选择进化路径 • 改记忆 • 改 prompt • 训模型 | 进化路径决策表 |
| Evolve | 执行进化并验证效果 | • Bad Case 数据飞轮 • Prompt 自进化 • 记忆进化 |
这里需要补一层执行时机:Trace、Rubric Score、Judge 不是同一件事,也不是同一时刻发生。
用户主链路:
  用户 query 进入
    -> 创建 LangFuse Trace
    -> AgentLoop 正常执行
    -> LLM 调用 / 工具调用 / fork 过程写入 Span
    -> 返回最终答案给用户

后台评测链路:
  Agent 请求结束
    -> 拿到完整 trajectory / Trace
    -> 针对这条 query 生成动态 Rubric
    -> Rubric Judge 给 Agent Trace 打分
    -> Score 回填到 LangFuse
    -> 根据分数分流 Goodcase / Badcase
什么时候记录 Trace 到 LangFuse?
Trace 在用户 query 进入 Agent 时就创建。后续每一次 LLM 推理、工具调用、fork 子 Agent、最终回答或异常,都写到这条 Trace 下面。
| 记录对象 | 记录时机 | 作用 |
|---|---|---|
| query / user_id / thread_id | 请求进入时 | 复现用户原始需求 |
| LLM Generation | 每次 Think / Reflect 调模型时 | 分析 token、延迟、模型版本 |
| Tool Span | 每次 Act 调工具时 | 定位工具失败、参数错误、返回为空 |
| fork 子 Agent 信息 | dispatch / 子 Agent 启停时 | 分析多分支是否正确收敛 |
| final_answer / error | 请求结束时 | 作为后续 Judge 和排障上下文 |
Trace 的价值是保存“过程证据”。很多 bad case 不是最终回答那一步才坏,而是前面某个工具参数偏了、某个平台超时、某个子 Agent 没有合流。没有完整 Trace,只能知道“回答不好”;有 Trace 才能知道“从哪一步开始不好”。
什么时候给 query 动态打分?
动态打分发生在 Agent 跑完之后。不是用户刚输入 query 就给最终分,而是等完整 trajectory 生成后,再基于 query 生成动态 Rubric,并对 final answer + trajectory 做评测。
query
  -> Agent 生成完整 trajectory
  -> 基于 query 生成动态 Rubric
  -> Judge 按 Rubric 评估 final_answer + trajectory
  -> 产出 P0 / P1 / P2 明细和总分
Rubric 必须动态生成,因为不同 query 的评分标准不同:
- “预算 300,不要塑料”必须检查预算和材质约束;
- “送 28 岁男生生日礼物,不要玩具”必须检查人群、礼物场景和负向约束;
- “跨平台比价”必须检查是否真的做了多平台搜索、比价和到手价计算。
线上实时阶段可以做轻量校验,例如 schema check、工具顺序检查、循环检测;完整 Rubric 打分更适合放在请求结束后的后台评测链路。
Rubric Judge 模型在哪里、什么时候给 Agent Trace 打分?会不会影响用户主 query?
Rubric Judge 是评测链路里的专用模型,一般放在 eval / judge 模块中,使用比主 Agent 更稳定、更强的模型,并设置 temperature=0,保证评分稳定。
Judge 的输入不是只有最终回答,而是:
Judge 输入
  = 用户原始 query
  + 动态 Rubric
  + Agent final_answer
  + messages / tool_calls / structured_result
  + LangFuse Trace metadata
Judge 的输出是结构化评分:
| 层级 | 判断内容 | 结果用途 |
|---|---|---|
| P0 红线 | 是否预算严重超标、推荐违禁品、泄露内部字段、违反硬约束 | 一票否决,进入规则 / Hook 修复 |
| P1 规范 | 是否按正确工具顺序执行,是否跳过关键步骤,格式是否完整 | 判断是否需要强模型重跑并生成 SFT 样本 |
| P2 质量 | 推荐是否贴合需求,理由是否充分,场景洞察和决策价值是否足够 | 作为 RL reward 或策略沉淀信号 |
这个过程不应该影响用户主 query。用户主链路先返回购物结果;Judge 在后台异步评分。即使 Judge 失败,影响的只是这条 Trace 暂时没有 Rubric Score,不能进入 Goodcase / Badcase 自动流转,不应该影响用户看到最终回答。
进化路径选择
Monitor 发现退化后,不能一上来就训模型。训模型是最贵、最慢、最难回滚的手段,应该放到最后。
| 根因类型 | 优先路径 | 为什么 |
|---|---|---|
| 偏好过期 / 知识缺失 | 改记忆 / 改知识库 | 秒级生效,风险最低 |
| Prompt 规则缺失 | 改 Prompt | 分钟级生效,可以 A/B 验证 |
| 工具行为变化 | 改工具 / Harness Hook | 小时级修复,属于工程治理 |
| 模型决策质量不足 | SFT / RL | 成本最高,但能提升长期能力上限 |
简单判断流程:
退化出现
  -> 是偏好 / 知识问题?优先改 Store / Skill
  -> 是规则缺失?改 Prompt 并做 A/B
  -> 是工具变化?改 Tool / Harness Hook
  -> 都不是,才进入 SFT / RL
这个原则可以概括为:能改外层就不改内层,能改规则就不训模型。
Bad Case 数据飞轮
Bad Case 飞轮负责把线上失败样本变成可持续迭代的数据资产。它的入口通常是低分 Trace:
LangFuse Score < 阈值
  -> 采集完整 trajectory
  -> 按 Rubric 明细分成 P0 / P1 / P2
  -> 不同等级走不同修复路径
这里的 LangFuse Score 来自 Rubric Judge 的评测结果。也就是说,Badcase 和 Goodcase 都来自同一套 Rubric 评分体系,只是分数区间和后续去向不同。
Rubric 高分
  -> Goodcase
  -> SFT 样本池 / 成功策略库

Rubric 低分
  -> Badcase
  -> P0 / P1 / P2 分流
  -> Hook / Prompt / Store / SFT / RL
采集的不是一条孤立回答,而是一整个诊断包:
| 字段 | 作用 |
|---|---|
| query | 复现用户原始需求 |
| trajectory | 保存完整 AgentLoop 轨迹 |
| rubric_score | 判断是否是 bad case |
| rubric_detail | 定位 P0 / P1 / P2 根因 |
| tool_calls | 分析工具调用顺序和参数 |
| token_consumed | 判断是否有成本失控 |
| trace_id | 回溯 LangFuse Trace |
核心采集逻辑可以很轻:
COLLECTION_THRESHOLD = 0.65

async def should_collect(rubric_score: float) -> bool:
    return rubric_score < COLLECTION_THRESHOLD
采集后再按 P0/P1/P2 分流:
def route_bad_case(rubric_detail: dict) -> str:
    if rubric_detail.get("p0_pass") is False:
        return "P0"

    if rubric_detail.get("p1_total_deduction", 0) >= 4:
        return "P1"

    if rubric_detail.get("p2_average", 5.0) < 3.0:
        return "P2"

    return "P2"
Goodcase 和 Badcase 的去向可以概括为:
| 类型 | 来源 | 去向 | 用途 |
|---|---|---|---|
| Goodcase | P0 全过,Rubric 总分达到高分阈值 | SFT 样本池 / 成功策略库 | 学习正确 AgentLoop 范式,沉淀可复用策略 |
| Badcase-P0 | P0 红线失败 | OutputGuard / Harness Hook / 黑名单规则 | 秒级堵住确定性风险 |
| Badcase-P1 | P1 执行规范扣分明显 | 强模型重跑,过门禁后进 SFT | 生成正确示范,修复流程问题 |
| Badcase-P2 | P2 质量低 | RL reward 池,与 goodcase 配对 | 优化长期决策质量上限 |
所以,Bad Case 飞轮不是只收集“坏回答”,而是把 Rubric 分数变成数据路由规则:
- 高分轨迹进入 Goodcase,用来做 SFT 或沉淀成功策略;
- 低分轨迹进入 Badcase,再按 P0 / P1 / P2 选择不同修复路径;
- P1 badcase 不能直接进 SFT,需要强模型重跑后过门禁;
- P2 badcase 更适合作为 RL 的低分对照样本,和同类 query 的 goodcase 配对。
P0:秒级规则修复
P0 是红线问题,比如:
- 输出泄露内部 item_id
- 推荐违禁品
- 暴露工具名 / API Key
- 严重格式错误导致前端不可用
这类问题不需要训模型,因为它们通常是确定性可判断的。直接生成 Hook 规则,挂到 output_guard / pre_tool_call / post_tool_call 更快。
async def auto_fix_p0(case):
    comment = case.rubric_detail.get("p0_comment", "")

    if "泄露" in comment:
        patterns = extract_leaked_patterns(case.trajectory)
        output_guard.add_patterns(patterns)

    if "违禁" in comment:
        blacklist.add(case.rubric_detail["bad_category"])
P0 修复不是临时 patch,而是持久化进 Harness 规则。后续所有请求都会经过这层防线。
P1:强模型重跑,进入 SFT
P1 是执行规范问题,比如:
- 没调 ShoppingSummary 就直接回答
- 工具调用顺序错
- Markdown 结构不完整
- 参数格式不符合约束
这类问题不能直接把错误轨迹丢进训练集,否则会以错训错。正确做法是:用强模型重跑同一条 query,生成一条更好的轨迹,再过门禁进入 SFT。
async def replay_with_strong_model(case):
    result = await run_agent(
        query=case.query,
        model_override=get_judge_llm(),
    )

    new_score = await evaluate_trajectory(result["trajectory"])
    old_score = case.rubric_detail["total_score"]

    if new_score["total_score"] - old_score >= 15:
        return {
            "query": case.query,
            "trajectory": result["trajectory"],
            "score": new_score["total_score"],
            "source": "p1_replay",
        }

    return None
入库前还要过门禁:
| 门禁 | 要求 |
|---|---|
| Rubric 分 | 大于等于 75 |
| 格式正确率 | 100% |
| 相比原始轨迹 | 至少提升 15 分 |
| 轨迹长度 | 不超过 16K token |
P1 的产物是高质量 SFT 样本,用来让模型学会“正确的 AgentLoop 范式”。
P2:进入 RL Reward 池
P2 是质量问题,比如:
- 推荐和 query 不够贴合
- 覆盖了显式需求但没覆盖隐式需求
- 决策建议没有价值
- 场景洞察力弱
这类问题不一定存在唯一标准答案,SFT 能教格式,但很难教“哪个决策更好”。所以 P2 更适合作为 RL 信号:
P2 低分轨迹
  + 线上高分轨迹
  -> 按 query pattern 配对
  -> 形成好坏对比
  -> 进入 RL reward 池
最终形成三个节奏:
| 周期 | 处理对象 | 产出 | 生效速度 |
|---|---|---|---|
| 日级 | P0 红线 | 新 Hook / 新规则 | 秒级 |
| 周级 | P1 规范 | SFT 数据 / 新 checkpoint | 周级 |
| 月级 | P2 质量 | RL reward 信号 / 新 checkpoint | 月级 |
Prompt 自进化
Prompt 也会过期。工具变了、模型版本变了、用户 query 类型变了,都会让旧 prompt 的行为开始漂移。
如果靠人工直接改 prompt,会有几个问题:
- 不知道修了 A 会不会坏了 B
- 没有版本记录,回滚困难
- 多人修改容易冲突
- System Prompt 一变,Prompt Cache 可能大面积失效
所以 Prompt 不能“随手改”,而要版本化。
Prompt Version
每次 prompt 改动都存成一个版本:
@dataclass
class PromptVersion:
    version: str
    content: str
    changelog: str
    author: str
    status: str = "draft"   # draft / testing / active / retired
    rubric_score: float | None = None
版本号按语义化管理:
| 类型 | 例子 | 处理方式 |
|---|---|---|
| major | 改 AgentLoop 结构 | 全量回归 |
| minor | 新增工具说明 / 新规则 | A/B 测试 |
| patch | 修错字 / 微调措辞 | 快速上线 |
A/B 测试
Prompt 自进化的核心不是“自动生成一段新 prompt”,而是新 prompt 不能直接全量上线。
def get_prompt_for_user(user_id: str) -> str:
    if no_testing_version():
        return prompt_store.get_active().content

    ratio = hash(user_id) % 100 / 100.0
    if ratio < 0.10:
        return prompt_store.get_testing().content

    return prompt_store.get_active().content
A/B 期间看四个指标:
| 指标 | 判断 |
|---|---|
| Rubric 均分 | 候选 prompt 连续 3 天高于基线才放量 |
| 格式正确率 | 低于阈值直接回滚 |
| 工具失败率 | 明显升高则回滚 |
| Cache 命中率 | 大幅下降则告警 |
放量策略也要渐进:
10% 流量观察
  -> 30% 流量观察
  -> 100% 全量
Prompt 更新还有一个容易忽略的点:Prompt Cache 基于前缀匹配。所以新规则尽量加在 prompt 末尾,不要频繁改开头的核心描述。A/B 测试期间也不要直接用 token 成本判定候选 prompt 变差,因为它的缓存还没预热,天然会更贵。
Auto Prompt Optimization
Prompt 自进化可以分三档:
| 阶段 | 做法 | 人工参与 |
|---|---|---|
| 手动 | 人看 bad case,手写规则 | 高 |
| 半自动 | LLM 分析 bad case,生成修改建议,人审核 | 中 |
| 全自动 | LLM 生成改动,自动 A/B,自动合入或回滚 | 低 |
项目里更稳的是半自动:让 judge LLM 读最近一批低分 bad case,输出修改建议,而不是直接改线上 prompt。
async def suggest_prompt_improvement(bad_cases):
    current = prompt_store.get_active()
    summary = summarize_bad_cases(bad_cases)

    resp = await get_judge_llm().ainvoke([
        ("user", ANALYZE_PROMPT.format(
            current_prompt=current.content,
            bad_cases_summary=summary,
        ))
    ])

    return {
        "suggestion": resp.content,
        "based_on_version": current.version,
    }
自动化也要有门禁:
| 门禁 | 约束 |
|---|---|
| 修改幅度 | diff 不超过固定字数 |
| 工具描述 | 不能删除已有工具说明 |
| 核心流程 | 不能自动改 fork / 阶段规则 |
| 频率 | 每天最多生成一个候选版本 |
原则是:自动系统可以加规则、改措辞,但不能擅自改架构。
Memory & Strategy Evolution
记忆层进化是成本最低、反馈最快的一层。
最初的 Store 只存用户偏好:
用户说“不要塑料”
  -> ShoppingSummary 提取 learned_preferences
  -> store_writeback 写入 Store
  -> 下次 on_session_start 读取并注入 prompt
但只存偏好还不够。升级后的 Store 还要存两类东西:
- 成功策略:高分轨迹里可复用的做法
- 失败教训:低分轨迹里应该避免的坑
成功策略
成功策略不是完整轨迹,而是压缩后的经验:
某类 query
  + 某种工具调用顺序
  + 高 Rubric 分
  -> 提炼成可复用策略
一条策略可以长这样:
class StrategyEntry(BaseModel):
    strategy_id: str
    query_pattern: str
    summary: str
    tool_hints: list[str]
    key_decisions: list[str]
    rubric_score: float
    confidence: float = 1.0
    times_referenced: int = 0
例如:
query_pattern: 跨平台比价类,带预算和材质约束
summary: 先确认品类属性,再并行搜索,最后综合比价和筛选
tool_hints:
  - category_insight
  - dispatch_tool
  - price_compare
  - shipping_calc
  - item_picker
  - shopping_summary
策略来自高分轨迹,但不是所有高分轨迹都能入库:
| 门禁 | 条件 |
|---|---|
| Rubric 分 | 大于等于 0.80 |
| 轨迹轮次 | 至少 4 轮 Act |
| 工具多样性 | 至少 3 个不同工具 |
| 去重 | 和已有策略不能太相似 |
新会话开始时,系统按当前 query 检索 1~3 条相似策略,注入 system prompt:
def inject_strategies(prompt: str, strategies: list[StrategyEntry]) -> str:
    if not strategies:
        return prompt

    strategy_text = "\n".join(
        f"- {s.query_pattern}: {s.summary}"
        for s in strategies[:3]
    )

    return prompt + f"""
# 成功策略参考
{strategy_text}

注意:以上策略仅供参考,请根据当前 query 灵活调整。
"""
这里重点是“参考”而不是“强制”。策略库不是要把 Agent 变成固定流程,而是减少重复探索。
失败教训
低分轨迹也有价值。它可以沉淀成“不要这么做”的经验:
class LessonEntry(BaseModel):
    lesson_id: str
    query_pattern: str
    what_went_wrong: str
    avoid_hints: list[str]
    rubric_comment: str
    confidence: float = 1.0
注入时可以和成功策略放在一起:
# 成功策略参考
- 跨平台比价类:先 CategoryInsight,再 fork 多平台搜索

# 失败教训参考
- 送礼类 query:不要只搜商品名,要考虑收礼人的年龄、性别、爱好
- 旅行套装类 query:不要跳过 CategoryInsight,否则容易漏组件
这类记忆让 Agent 不只是“记住用户喜欢什么”,还会逐渐记住“哪些做法容易失败”。
策略生命周期
策略也会过期,所以需要 confidence:
def compute_confidence(strategy):
    days_old = days_since(strategy.created_at)
    time_decay = exp_decay(days_old, half_life=60)

    reference_boost = min(strategy.times_referenced * 0.05, 0.5)

    return min(1.0, strategy.rubric_score * time_decay + reference_boost)
- 60 天没人引用,置信度减半
- 被高分请求引用,置信度回升
- 被低分请求引用,置信度下降
这样 Store 不是越存越乱,而是会自然沉淀出长期有效的策略。
Dynamic Fork Evolution
Globex 里 fork 多平台搜索不是永远固定的。平台状态会变:
- 某平台最近 API 经常超时
- 某平台在某品类下结果质量低
- 新平台接入后需要加入候选
所以 fork 候选可以根据历史成功率动态调整:
class PlatformSuccessTracker:
    def record(self, platform: str, success: bool):
        ...

    def get_success_rate(self, platform: str) -> float:
        ...

    def should_fork_to(self, platform: str, threshold: float = 0.3) -> bool:
        return self.get_success_rate(platform) >= threshold
生成候选平台:
def get_fork_candidates() -> list[str]:
    candidates = []

    for platform in DEFAULT_PLATFORMS:
        if platform_tracker.should_fork_to(platform):
            candidates.append(platform)

    return candidates[:4]
然后在 pre_think 里注入提示:
@harness_hook("pre_think", name="fork_platform_hint", priority=30)
async def inject_fork_hint(context: dict):
    candidates = get_fork_candidates()

    context.setdefault("inject_messages", []).append({
        "role": "system",
        "content": f"当前推荐 fork 的平台:{', '.join(candidates)}"
    })

    return context
这本质上是 Harness 层的自适应:不改模型、不改 prompt,只根据线上反馈动态改变 Agent 的行动边界。
最终闭环
到这里,Agent Evolve 不是一个单点功能,而是一套闭环:
线上请求
  -> LangFuse 记录 Trace
  -> 请求结束后 Rubric Judge 生成 Score
  -> Score 回填 LangFuse
  -> 高分进入 Goodcase
  -> 低分进入 Bad Case 池
  -> P0/P1/P2 分流
  -> 改 Hook / 改 Prompt / 改 Store / 训模型
  -> A/B 或灰度验证
  -> 候选版本上线
  -> 继续监控
从成本和生效速度看:
| 进化层 | 修复对象 | 生效速度 | 典型手段 |
|---|---|---|---|
| External Files | 偏好、知识、策略、教训 | 秒级 | Store / Skill / Strategy |
| Agent Harness | Prompt、工具、Hook、路由 | 分钟到小时级 | Prompt A/B / Harness 规则 |
| Model Weights | 决策能力和范式理解 | 周到月级 | SFT / RL |
所以 Globex 的自进化不是“模型自己训练自己”这么玄的东西,而是一个工程闭环:先观测,再分级,再选择最低成本的修复路径,最后用 Rubric 和线上指标验证效果。
越用越聪明,背后其实是三件事在持续发生:
- 记忆层记住用户偏好、成功策略和失败教训;
- Harness 层通过 Prompt、Hook、工具路由持续修正行为边界;
- Weights 层用高质量轨迹和 reward 信号慢慢提升决策上限。