Why not ReAct?
传统 RAG 通常只在生成前检索一次,检索内容主要由原始问题决定。因此,在多跳问答或复杂推理任务中,它很容易遇到信息不足、检索偏差或上下文不完整的问题。
ReAct、IRCoT 等方法在此基础上加入了“推理—检索—再推理”的过程,使模型能够根据中间结果继续搜索。不过,这类方法仍然较依赖提示词设计和模型原有的工具调用能力。当问题较复杂、检索结果存在噪声,或中间推理方向出现偏差时,模型可能会重复搜索、生成无效查询,甚至在证据不足时提前作答。
Agentic RL 的不同之处在于,它不只是规定模型“应该如何搜索”,而是直接对完整的推理与检索过程进行训练。模型在与搜索引擎交互的过程中,根据最终答案获得奖励,并逐渐学习何时搜索、如何拆解问题、怎样调整查询,以及什么时候停止。这种方式比手工设计固定流程更灵活,也减少了对人工编写推理轨迹的依赖。
当然,强化学习并不能完全解决检索质量和错误信息带来的问题,其效果仍会受到奖励设计、训练稳定性和搜索环境质量的影响。但它为 Agentic RAG 提供了一条更自然的改进路径:提示词负责规定基本交互形式,强化学习则帮助模型从实际反馈中学会更有效的搜索与推理策略。
Search-R1
在 Agentic RL 范式下,Search-R1 进一步探索了强化学习驱动的搜索增强推理能力。它将搜索引擎建模为强化学习环境的一部分,使 LLM 的内部推理过程与外部知识检索过程交织进行。这样,模型不再依赖人工设计的固定搜索流程,而是通过 PPO、GRPO 等强化学习算法,优化“思考—行动—反馈”的决策策略。
为实现结构化的多轮交互,Search-R1 引入了特殊标记机制:
- <think> 用于表示模型的内部推理过程,使模型能够逐步分析当前问题;
- <search> 用于触发搜索工具调用,使模型自主决定何时、如何获取外部信息;
- <information> 用于承载搜索引擎返回的检索内容,使外部知识能够融入后续推理;
- <answer> 用于标记最终输出结果,表示模型完成推理与检索后的答案生成阶段。
基于这种机制,模型可以形成“推理 → 检索 → 观察 → 再推理 → 回答”的循环决策模式。Search-R1 采用基于最终结果的奖励函数,仅根据答案正确性优化模型行为,避免了复杂过程奖励设计带来的额外成本。因此,它可以被视为 DeepSeek-R1 Zero 在工具增强场景下的扩展:强化学习不只用于提升模型内部推理能力,也进一步用于优化模型的搜索调用、信息利用和任务完成策略。
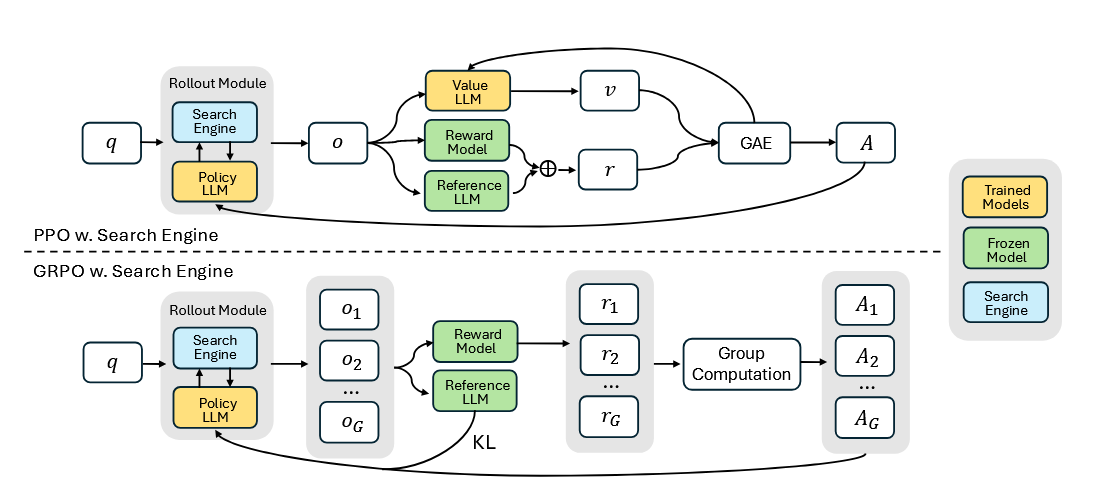
Fig. 1. SEARCH-R1 框架下 PPO 与 GRPO 训练过程演示。在模型推演(rollout)阶段,大语言模型(LLMs)能够与搜索引擎进行多轮交互。 (Image source: Search-R1, 2025)
Multi-turn Search Rollout
在生成阶段,Search-R1 并不是一次性完成回答,而是采用多轮搜索调用的 rollout 过程。模型会在生成文本的同时,根据当前推理状态按需调用外部搜索引擎,可以理解为:
$$y\sim\pi(\cdot\mid x;\boldsymbol{\theta},\mathcal{R})=\pi(\cdot\mid x;\boldsymbol{\theta})\otimes\mathcal{R}$$具体来说,当模型认为需要外部知识时,会生成 <search> query </search>。系统检测到该标记后,会抽取 query,调用搜索引擎 $\mathcal{R}$,并将返回结果封装为 <information> retrieved content </information> 追加到当前上下文中。随后,模型继续基于这些外部信息进行下一步 <think> 推理。
这一过程会持续进行,直到满足两个停止条件之一:一是达到最大搜索动作预算 $B$;二是模型生成 <answer> final answer </answer>。因此,Search-R1 的生成轨迹可以看作一个动态循环:先思考,必要时搜索,再将检索结果纳入上下文继续推理,最后给出答案。
训练时,Search-R1 使用了一个简洁的 template 来约束输出格式。这个模板只规定模型应使用 <think>、<search>、<information> 和 <answer> 组织推理、检索和回答,并不强行规定具体推理方式或搜索策略。因此,强化学习可以更自然地观察和优化模型自身形成的搜索行为。Train Template:
Answer the given question. You must conduct reasoning inside <think> and </think> first every time you get new information. After reasoning, if you find you lack some knowledge, you can call a search engine by <search> query </search>, and it will return the top searched results between <information> and </information>. You can search as many times as you want. If you find no further external knowledge needed, you can directly provide the answer inside <answer> and </answer> without detailed illustrations. For example, <answer> xxx </answer>. Question: question.
Objective Function
Search-R1 的核心目标函数为:
$$\max_{\boldsymbol{\theta}}\ \mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi(\cdot\mid x;\boldsymbol{\theta},\mathcal{R})}\left[r_\phi(x,y)\right]-\lambda_{\mathrm{KL}} D_{\mathrm{KL}}\left[\pi(\cdot\mid x;\boldsymbol{\theta},\mathcal{R})\parallel\pi_{\mathrm{ref}}(\cdot\mid x;\mathcal{R})\right]$$其中,策略模型 $\pi(\cdot;\boldsymbol{\theta})$ 在搜索引擎 $\mathcal{R}$ 的辅助下生成包含“推理—检索”的轨迹,并通过奖励函数 $r_\phi$ 提高任务表现;$\lambda_{\mathrm{KL}}$ 是 KL 正则项系数,用于限制策略模型不要过度偏离参考模型 $\pi_{\mathrm{ref}}$。与传统仅依赖模型自身生成的 RL 方法相比,Search-R1 显式引入外部检索信息,并基于 PPO 或 GRPO 优化检索增强推理能力。
在训练细节上,Search-R1 对检索返回的 token 使用 loss masking。一次 rollout 中既包含模型生成的 token,也包含搜索引擎返回的检索 token。如果对整段序列都计算损失,模型可能会错误地学习外部文本本身,而不是学习如何搜索和利用信息。因此,Search-R1 只对 LLM 生成的 token 计算策略梯度,并将检索 token 从优化目标中屏蔽掉。
为了和前一篇强化学习博客的符号保持一致,记第 $t$ 步状态为 $s_t=(x,y_{\lt t};\mathcal{R})$,当前位置 token 记为动作 $a_t=y_t$。令 $I(a_t)$ 表示 token-level mask:当 $a_t$ 是模型生成 token 时,$I(a_t)=1$;当 $a_t$ 是检索返回 token 时,$I(a_t)=0$。
在 PPO 设置下,Search-R1 的核心目标可以写为:
$$\mathcal{J}_{\mathrm{PPO}}(\boldsymbol{\theta})=\mathbb{E}\left[\frac{1}{\sum_{t=1}^{|y|}I(a_t)}\sum_{t=1}^{|y|}I(a_t)\left(\min\left(r_t(\boldsymbol{\theta})\hat{A}_t,\mathrm{clip}(r_t(\boldsymbol{\theta}),1-\epsilon,1+\epsilon)\hat{A}_t\right)-\lambda_{\mathrm{KL}} D_{\mathrm{KL}}\left[\pi(\cdot\mid s_t;\boldsymbol{\theta})\parallel\pi_{\mathrm{ref}}(\cdot\mid s_t)\right]\right)\right]$$其中:
$$r_t(\boldsymbol{\theta})=\frac{\pi(a_t\mid s_t;\boldsymbol{\theta})}{\pi(a_t\mid s_t;\boldsymbol{\theta}_{\mathrm{old}})}$$这里 $\hat{A}_t$ 通常由 GAE 结合未来奖励和价值网络 $v(s_t;\mathbf{w})$ 估计得到。PPO 通过 clip 机制限制策略更新幅度,而 mask 项 $I(a_t)$ 确保只有模型生成内容参与优化。
GRPO 则不依赖额外的 value model,而是对同一问题采样一组回答,并用组内相对奖励估计优势。其核心目标可写为:
$$\mathcal{J}_{\mathrm{GRPO}}(\boldsymbol{\theta})=\mathbb{E}\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{\sum_{t=1}^{|y_i|}I(a_{i,t})}\sum_{t=1}^{|y_i|}I(a_{i,t})\left(\min\left(r_{i,t}(\boldsymbol{\theta})\hat{A}_{i,t},\mathrm{clip}(r_{i,t}(\boldsymbol{\theta}),1-\epsilon,1+\epsilon)\hat{A}_{i,t}\right)-\lambda_{\mathrm{KL}} D_{\mathrm{KL}}\left[\pi(\cdot\mid s_{i,t};\boldsymbol{\theta})\parallel\pi_{\mathrm{ref}}(\cdot\mid s_{i,t})\right]\right)\right]$$其中:
$$ r_{i,t}(\boldsymbol{\theta})=\frac{\pi(a_{i,t}\mid s_{i,t};\boldsymbol{\theta})}{\pi(a_{i,t}\mid s_{i,t};\boldsymbol{\theta}_{\mathrm{old}})} $$其中 $s_{i,t}=(x,y_{i,\lt t};\mathcal{R})$,$a_{i,t}=y_{i,t}$,$\hat{A}_{i,t}$ 来自同一组回答内部的相对奖励。相比 PPO,GRPO 省去了价值函数估计,用组内 baseline 来稳定训练;同时,KL 散度作为正则项直接加入损失,用于限制当前策略不要过度偏离参考策略。
Reward Modeling
Search-R1 的奖励设计较为直接,主要采用 rule-based final outcome reward,即只根据最终答案是否正确来给奖励,而不额外设计复杂的过程奖励。其奖励函数可以表示为:
$$r_\phi(x,y)=\mathrm{EM}(a_{\mathrm{pred}},a_{\mathrm{gold}})$$其中,$a_{\mathrm{pred}}$ 是从模型最终响应 $y$ 中抽取出的答案,$a_{\mathrm{gold}}$ 是标准答案,$\mathrm{EM}$ 表示 exact match。换句话说,只要最终答案匹配标准答案,模型就获得正奖励;否则奖励较低或为零。
这种设计的优点是简单、稳定,并且避免了人为规定“正确推理过程”带来的偏置。Search-R1 没有额外加入 format reward,因为模型在模板约束下已经能够较好遵守 <think>、<search>、<information> 和 <answer> 的结构。这样,训练信号主要集中在最终任务表现上,让模型自己学习更有效的搜索与推理策略。
整体来看,Search-R1 的关键不只是“让模型能搜索”,而是把搜索行为本身纳入强化学习优化过程。模型不再被动接收一次性检索结果,而是在多轮交互中学习如何提出查询、何时停止搜索,以及如何将外部信息整合进最终回答。