原文:Harness Engineering for Self-Improvement,作者 Lilian Weng。
递归式自我改进(recursive self-improvement, RSI) 的概念可以追溯到 I. J. Good (1965)。他把“超智能机器”定义为一个能够在所有智力活动上超越人类,并能设计出更好机器来改进自身的系统。Yudkowsky (2008) 用“递归式自我改进”这个说法描述一个特定反馈环:AI 使用当前智能来改进产生其智能的认知机器。
在现代 AI 里,这个反馈环可以指模型直接重写自己的权重;也可以更宽泛地指模型改进训练流水线和部署系统,后者再产生一个性能更强、能更好完成经济价值任务的后继模型。前沿实验室中的 AI 研究开发速度已经被证明出现了显著加速(Anthropic;OpenAI)。
我特意提到**“部署系统”**,是因为位于原始模型和真实世界上下文之间的这一层,似乎和模型的原始智能同样重要,也就是预训练后立即测得的 eval 能力。Claude Code 和 Codex 这类成功的 coding agent 产品表明,harness 是 AI 部署中的重要组件。Harness 是包围基础模型的系统:它编排执行流程,决定模型如何思考和规划、调用工具和行动、感知并管理上下文、存储产物,以及评估结果。
本文关注 harness 工程相关研究,以及它如何贡献于 RSI。近期关于自动研究、自我改进 agent、演化式程序搜索的大量工作,都可以围绕这个问题来组织。模型 self-play、合成数据、测试时训练以及更广义的持续学习也符合 RSI 愿景(例如 Yuan et al. 2024、Chen et al. 2024、Zhao et al. 2025、Choi et al. 2026),但它们不是本文重点。
Harness 设计模式
相比早期 agent 框架中的“agent = LLM + memory + tools + planning + action”,harness 工程还包含工作流设计(例如 loop engineering)、评估、权限控制和持久状态管理。它不再只是 prompt template,而更接近运行时和软件系统设计:模型如何观察、行动、记忆、自检和改进。
设计应该有意保持简单和通用,以支持泛化;同时应参考既有软件工程实践,让预训练知识可以发挥作用。操作系统和 harness 之间也有很强的类比关系。类似 OS,harness 应该封装复杂逻辑,同时保持接口简单。与此同时,配置、工具接口和其他协议可能会在行业内逐渐标准化。
模式 1:工作流自动化
定义一个让模型可以操作、测试和迭代的工作流,是自动化的关键设计。Karpathy 的 autoresearch 仓库(https://github.com/karpathy/autoresearch)是构建这类工作流的清晰例子。常见工作流遵循一个面向目标的循环:计划、执行、观察/测试、改进、再次执行,直到目标达成。过程中也可能主动向用户请求澄清任务规格或执行偏好。
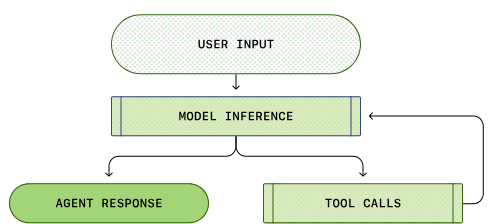
一个简化的 Codex agent loop:agent 调用工具,工具响应会影响模型的下一次生成。Image source: OpenAI codex agent post.
这个工作流图也强调:模型会分析自己的轨迹和失败案例,然后通过一个“agent runtime”继续迭代,而不是只依赖静态 prompt template。
模式 2:把文件系统作为持久记忆
长周期 agent 系统中反复出现的一个模式,是用简单控制方式管理丰富的状态和产物。Harness 不应该把整个工作流和所有日志都放进上下文里,而应该把持久状态保存在文件中。在长周期 agent rollout 中,实验日志、代码 diff、论文摘要、错误 trace 和过去 rollout 轨迹等产物,通常会远远超过模型训练时见过的上下文窗口长度。
学习如何读、写、编辑文件系统,通常通过 bash 命令完成,是 LLM 的基础能力。因此,用文件这种简单形式管理持久记忆,会自然受益于核心模型能力的提升。
模式 3:Sub-agent 和后台任务
Harness 可以启动多个 subagent 并行执行,并监控后台任务。当主 agent 需要搜索多个假设、并发运行实验,或把隔离子任务委托出去而不污染主上下文时,这很有用。父 agent 于是需要一个小型进程管理器:启动任务、查看日志、取消失败运行,并把结果合并回主 agent 线程。
关键设计选择是让并行性显式且可检查。如果 subagent 输出只存在于临时聊天上下文里,它们很快会过期并隐藏起来。如果它们被存成文件、日志和状态记录,模型就能在中断后恢复,并基于自己的执行历史进行推理。
案例研究:Coding Agent Harness
主流 coding agent 的核心接口已经在 Claude Code、Codex、OpenCode 和 Cursor 风格 agent 之间趋于稳定。它们通常使用如下循环:
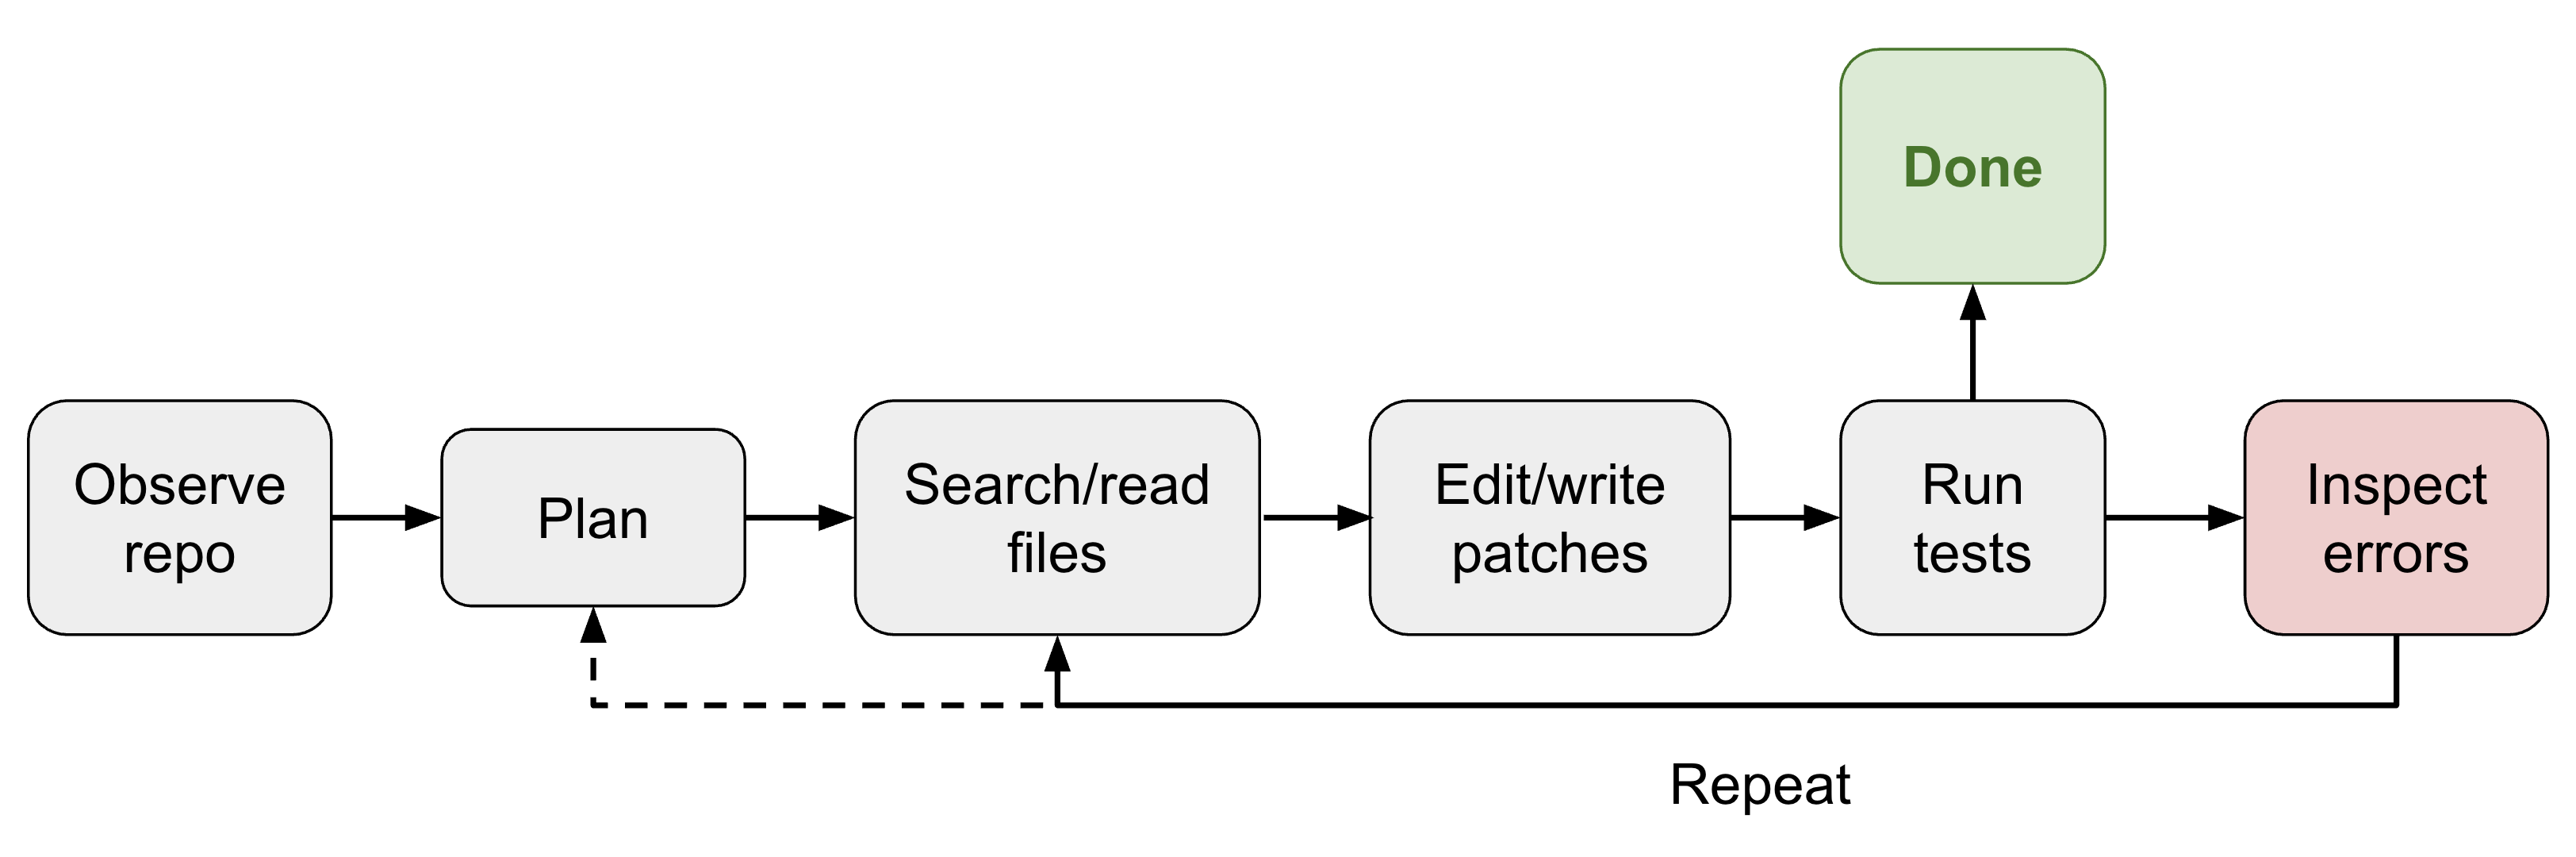
有了一组工具后,coding agent 就可以在给定仓库中开发并调试问题,类似人类开发者配备 IDE。
下面不是完整清单,只用于示意。感兴趣可阅读这里。
| 分组 | 工具定义 |
|---|---|
| 文件系统 | 文件发现:glob、grep、ls文件读取: read、read_many文件修改: write(完整写入新文件)、edit(精确字符串替换)、multi_edit、apply_patch(应用结构化 patch/diff) |
| Shell 执行 | 运行命令:bash、PowerShell |
| IO | lsp,以及 git_status、git_diff、git_commit 等 git 工具 |
| 外部上下文 | MCP tools、Skills |
| Web 搜索 | web_search、web_fetch、browser tools |
| Artifacts | 读取文档和图像;生成 HTML、图像 |
| 后台进程 | 例如 CronCreate、CronDelete、CronList |
| Agent 委托 | 例如 spawn_agent、resume_agent、wait_agent、list_agents、close_agent、interrupt_agent 等 |
Harness 层还是核心智能?
很难预测 RSI 的未来会在多大程度上依赖 harness 工程,但近期路径不太可能从模型直接重写自身权重开始。我对近期可行路径的预测是:
- Harness 工程会朝着 meta-methodology 的方向演化,也就是改进获得更好答案的机器,而不只是改进答案本身。Harness 系统本身会成为优化对象,启发式规则会减少,通用机制会增加。
- 成熟的 harness 会反过来支持模型自我改进循环中的自动研究;更聪明的模型又会防止 harness 被过度工程化,让系统保持可持续。
最终,许多 harness 改进可能会被内化到核心模型行为中,但外部上下文和工具接口仍然应该保留。我们已经在 prompt engineering 中看到过更温和的类似模式:随着 instruction tuning 和模型推理能力提升,手工 prompt 技巧不再那么核心,但指定目标、约束、上下文和评估的需求并没有消失。
Harness 优化
Harness 系统中被优化对象的大致演进路径是:instruction prompts -> structured context -> workflow -> harness code -> optimizer code。随着模型越来越智能、越来越强大,我们会走向更复杂的目标和更通用的方法。
上下文工程
随着 agentic 任务周期显著拉长,把所有工具响应和模型生成结果简单追加进上下文,很快就会失控。上下文管理是一层用于为 LLM 构造更结构化、更简洁上下文并管理持久状态的系统。长期上下文研究毫无疑问会继续进展,但当前长上下文智能和上下文工程有时是交织在一起的。
Agentic Context Engineering(ACE;Zhang et al. 2025)把上下文视为一个持续演化的 playbook,而不是越来越长的 prompt。它有三个组件,用来维护一个由 bullet point 组成的上下文 playbook,每条都有标识符和描述。
- Generator:参考 bullet point 产生任务轨迹。
- Reflector:从成功和失败轨迹中提炼洞见。
- Curator:用增量的、条目化的 entry 更新结构化上下文。
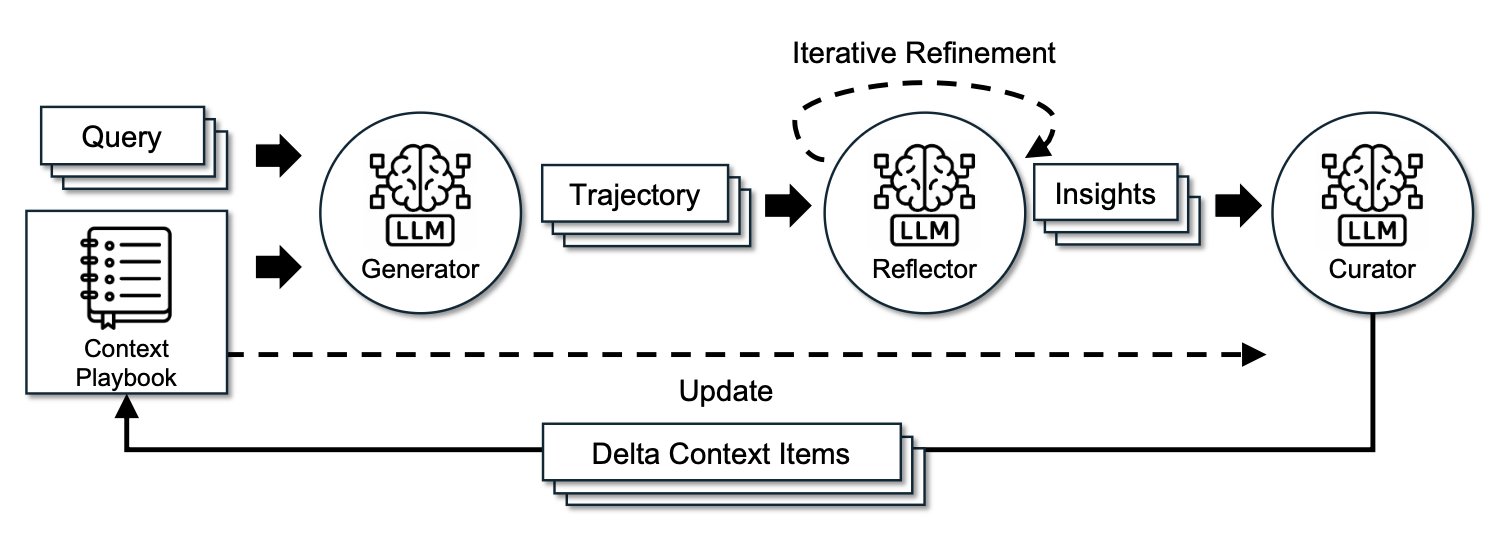
Agentic Context Engineering (ACE) 框架。Image source: Zhang et al. 2025.
为了在迭代重写中防止上下文坍缩和简短偏置,ACE 的一个关键设计选择是 curator 不重写完整 prompt blob。它输出一组结构化、条目化的 bullet,形式为 (identifier, description),再通过确定性逻辑合并进结构化上下文日志簿。上下文条目会周期性地精炼和去重。
ACE 从 rollout 中学习洞见这一点,帮助我们走向自管理记忆;但它的更新规则和整体工作流仍然是手写的。为了走向更自我改进的循环,Meta Context Engineering(MCE;Ye et al. 2026)把机制(如何管理上下文)与 artifact 内容(上下文里有什么)分开:在 meta-optimization 层运行 skill evolution,在 base 层运行 context optimization。
一个 MCE skill $s \in \mathcal{S}$ 定义上下文函数 $c_s=(\rho_s,F_s)$,并把输入 $x$ 映射到上下文 $c = F_s(x;\rho_s)$,其中:
- $\rho_s = \{\rho_1,\dots,\rho_m\}$ 是静态组件(prompts、knowledge bases、code libraries)。
- $F_s = \{F_1,\dots,F_k\}$ 是动态算子(search、selection、filtering、formatting)。
双层优化是在训练数据上给定 skill $s$ 找到最佳上下文 $c_s^*$,同时外层循环寻找能在验证集上获得最佳性能的最优 skill:
$$ \text{Inner: }c_s^*=\arg\max_{c_s}J_\text{train}(c_s;s)\quad \text{Outer: }s^*=\arg\max_{s\in\mathcal{S}}J_\text{val}(c_s^*) $$Skill 数据库会跟踪此前 skill、context function 和 eval metric 的历史:$\mathcal{H}_{k-1} = \{(s_i,c_i,J_i^\text{train}, J_i^\text{val})\}_{i=1}^{k-1}$。一个 meta-level agent 会对先前 skills 执行 agentic crossover,为任务 $\tau$ 创建新 skill:$s_k=\text{crossover}(\tau,\mathcal{H}_{k-1})$。
随后,base-level context engineer 执行 skill $s_k$,并在当前 skill 指导下从 rollout 反馈 $\mathcal{R}_k$ 中学习上下文函数:$c_k=\text{engineer}(\tau,s_k;c_{k-1}^*,\mathcal{R}_k)$。
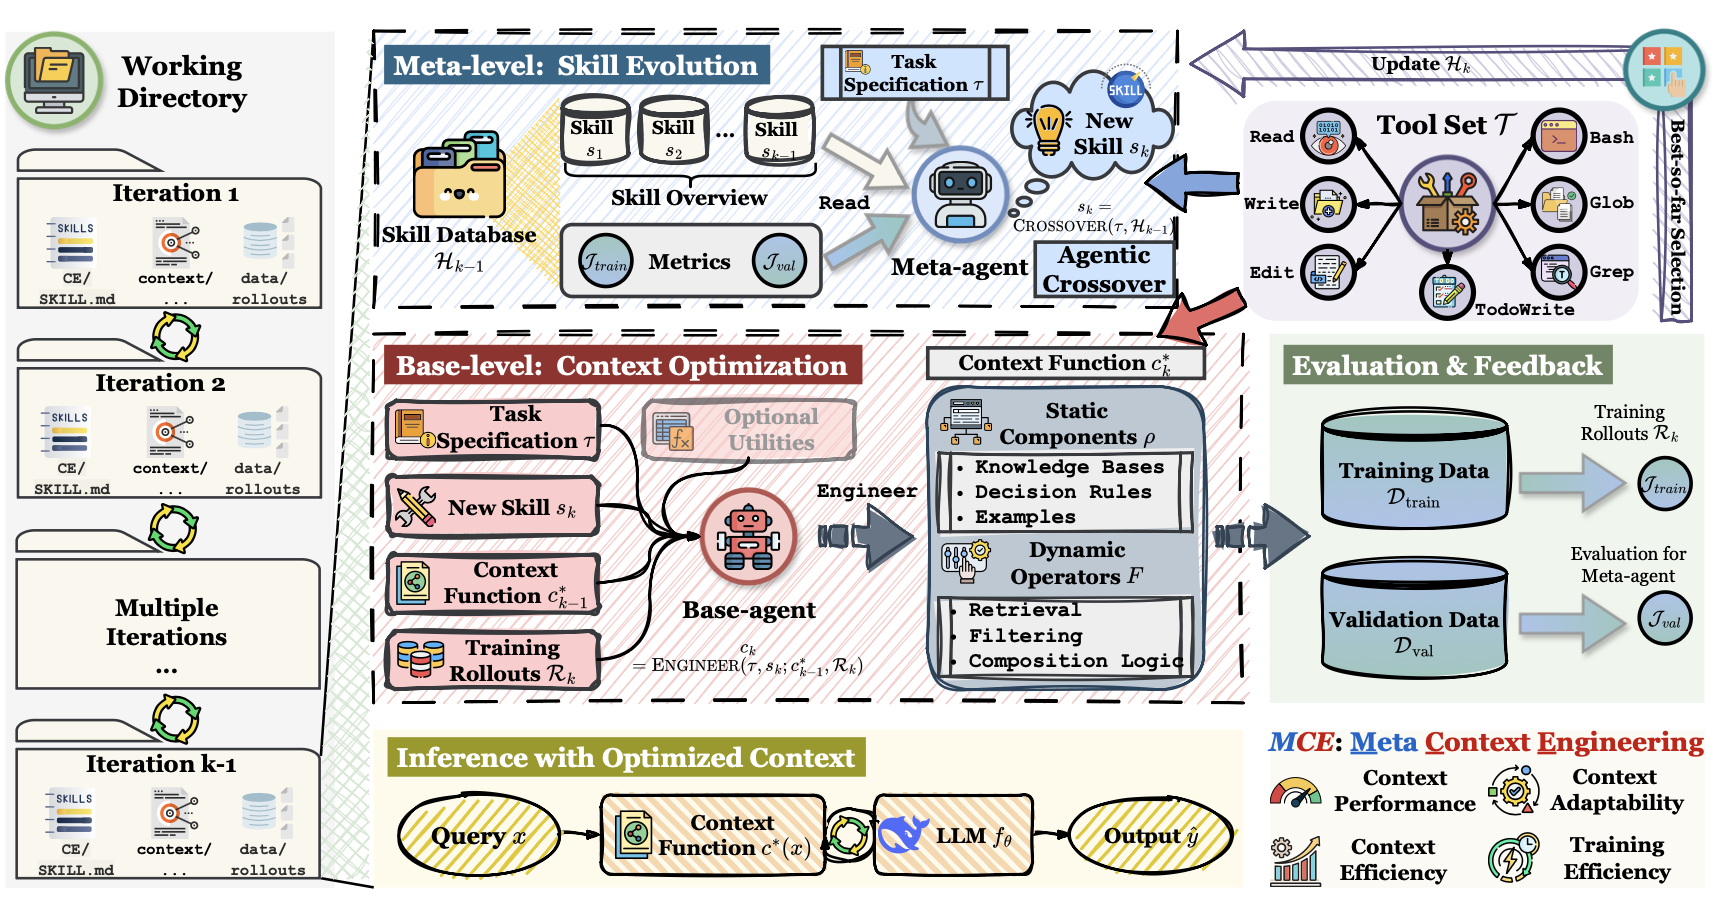
Meta Context Engineering (MCE) 框架:meta-level skill evolution 搜索上下文管理机制,base level 优化任务上下文。Image source: Ye et al. 2026.
MCE 不像 ACE 那样强制规定如何组织上下文的启发式规则。它使用自由形式 skill 来存储任务中最重要的知识,并让 skill 和以 skill 为条件的上下文一起迭代演化。实现上,上下文函数 $c$ 被实例化为专用目录中的一组文件,既包括静态组件(skill.md),也包括动态组件(context 和 data rollouts)。Meta-level 和 base-level 优化都在具备标准工具集的 agentic coding 环境中执行:
Meta-Harness(Lee et al. 2026)又向下推进一层:被优化对象是决定并优化“应该存储、检索和呈现哪些信息给模型”的代码。名字里的“Meta-”表示它是一个用来优化 harness 的 harness。
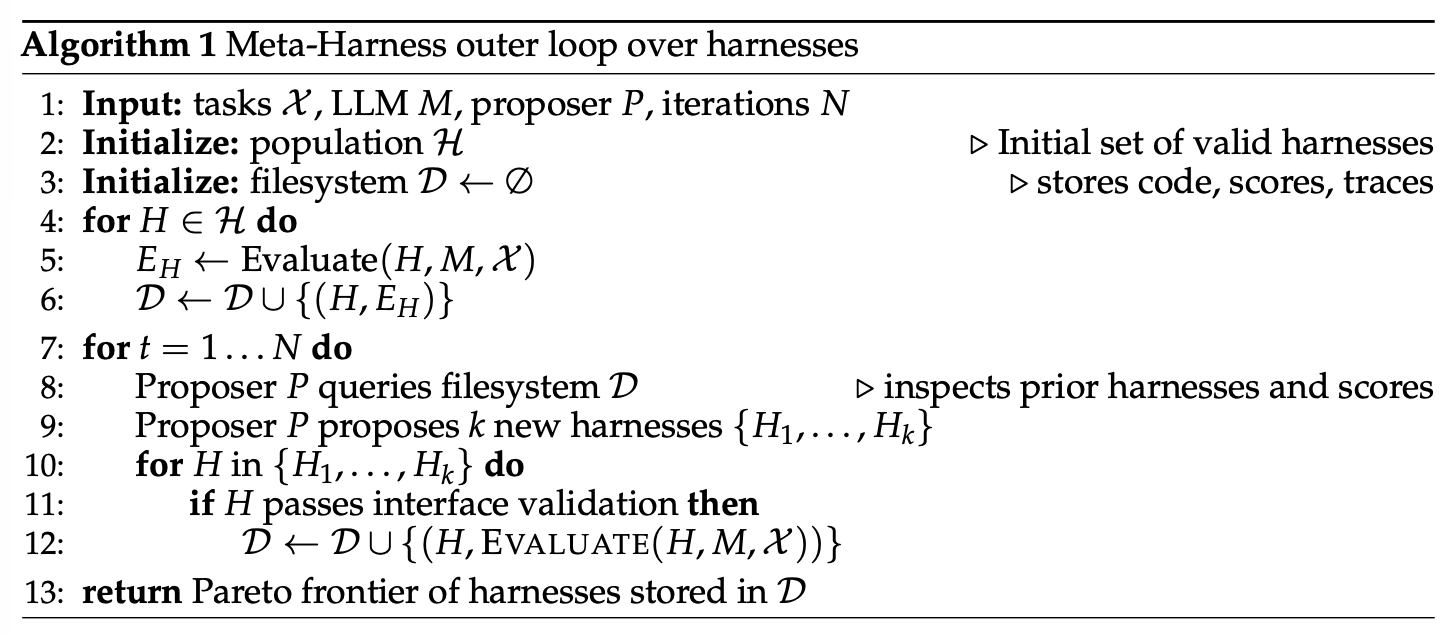
Meta-Harness 外层循环优化算法。Image source: Lee et al. 2026.
用于创建新 harness 的 proposer 本身就是一个 coding agent,最终输出是在 Pareto frontier 上的一组 harness candidates。
- 完整执行历史可以通过文件系统访问,因此 coding agent 会用
grep或cat这类命令读取历史,而不是把所有内容塞进一个 prompt 上下文。 - 提出的 harness 是文件系统中的一个目录,里面包含自身源代码、分数、rollout 轨迹和状态更新。
- meta-harness loop 会迭代创建新 harness,并只保留合格的候选。
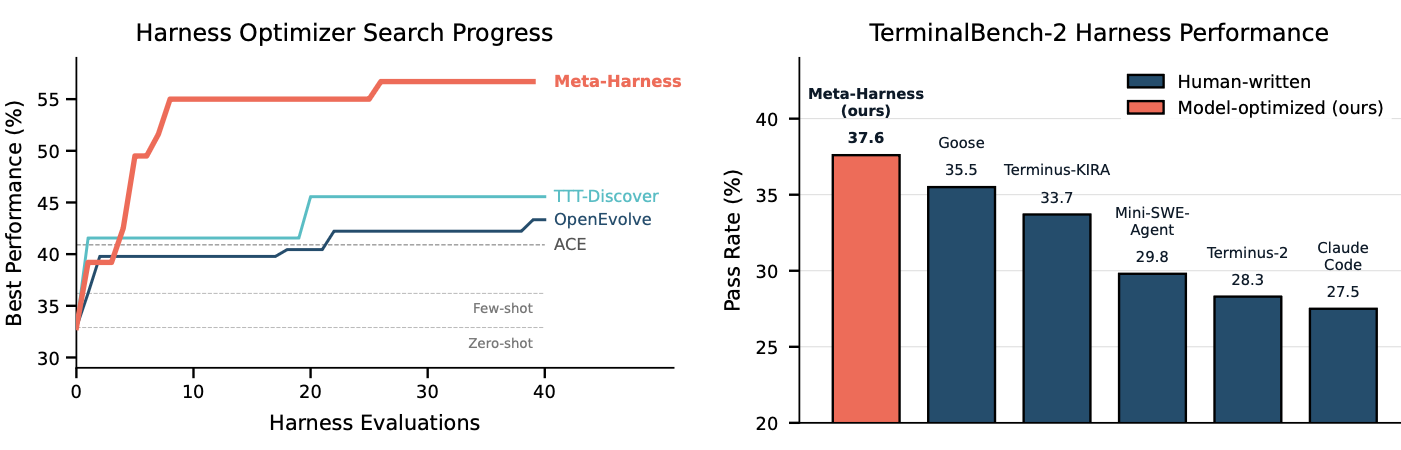
Meta-Harness 在文本分类和 TerminalBench-2 上的表现。注意 TerminalBench-2 实验的搜索初始化来自 Terminus-KIRA 和 Terminus-2 这两个很强的 harness。Image source: Lee et al. 2026.
重要教训很清楚:一旦 harness 设计变成可执行搜索空间,强 coding agent 就能利用人类工程师也在使用的同一设计空间。
工作流设计
Harness 工程中的工作流设计可以由领域专家手工完成。以自动研究为例,已有多个框架被提出并测试。AI Scientist 系统(Lu et al. 2026)构建了一条流水线:提出研究想法、编写代码、运行实验、分析结果、撰写论文并进行 peer review。Meng et al. (2026) 在 ScientistOne 中把可验证性作为核心设计约束:每个 claim(引用、数值、方法、结论)都必须追溯到证据来源,并通过 Chain-of-Evidence 检查审计。
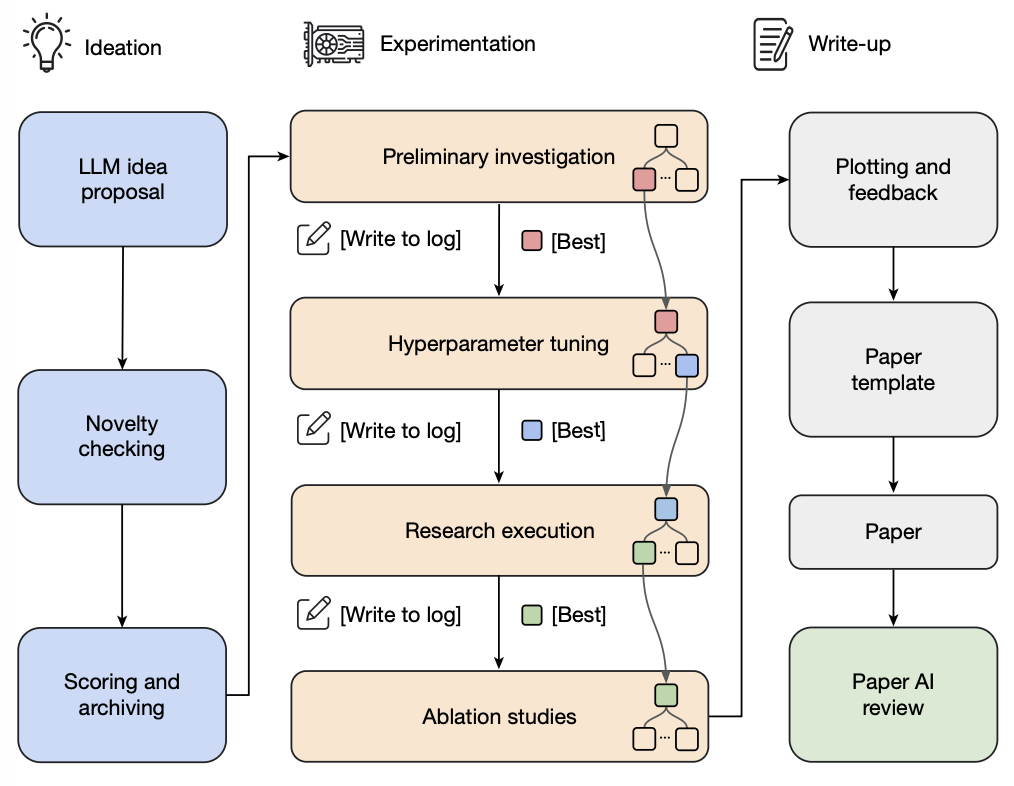
AI Scientist 用于 idea generation、实验、论文写作和 review 的流水线。Image source: Lu et al. 2026.
Autodata agent(Kulikov et al. 2026)被设计为一个用于生成训练和评估数据的数据科学家。主 agent 管理一个提出问题的 challenger、一个 weak solver、一个 strong solver 和一个 verifier/judge,目标是合成“刚刚好”难度的数据,也就是 strong solver 能成功而 weak solver 会失败。
在 Autodata 中,challenger prompt 会根据 solver 和 verifier 的反馈迭代更新。这里的局限在于,合成任务用于微调 weak solver,而不是 strong solver;如果这个循环不能迭代地改进 strong model,它就更像是对生成 prompt 分布的间接蒸馏,RSI 味道会弱一些。
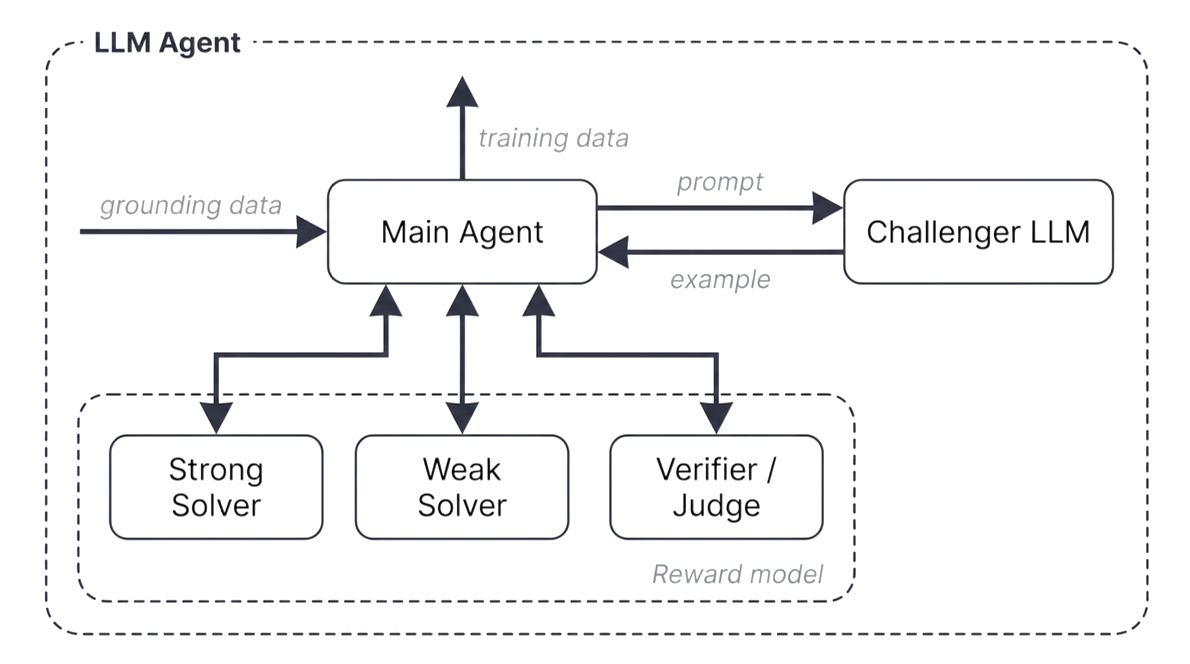
Autodata 围绕 challenger、solver 和 verifier 角色生成合成训练与评估数据的 agentic workflow 设计。Image source: Kulikov et al. 2026.
工作流设计空间巨大。我们自然可以把工作流设计看成一个搜索问题,因此应该可以通过算法找到好解,而不仅靠手工构造。沿着这个方向,Automated Design of Agentic Systems(ADAS;Hu et al. 2025)把 agent 设计本身表述为一个优化问题,即“meta-agent search”,其中 meta-agent 会提出新的 agentic workflow 设计。
- 用 CoT 和 self-refine 等简单 agent 初始化一个 agentic workflow archive。
- 要求 meta-agent 参考 archive 中既有解,用代码编写新 agent。
- Meta-agent 先生成新 workflow 的高层描述,再用代码实现它。
- Draft program 随后由 meta-agent 经过两轮 self-refine,也就是要求模型提供反馈,再要求同一个模型根据反馈改进之前生成的输出(Madaan et al. 2023),用于检查新颖性。
- 评估每个新候选,并把成功候选加入 archive。
- 重复第 2-5 步,直到达到最大迭代次数。
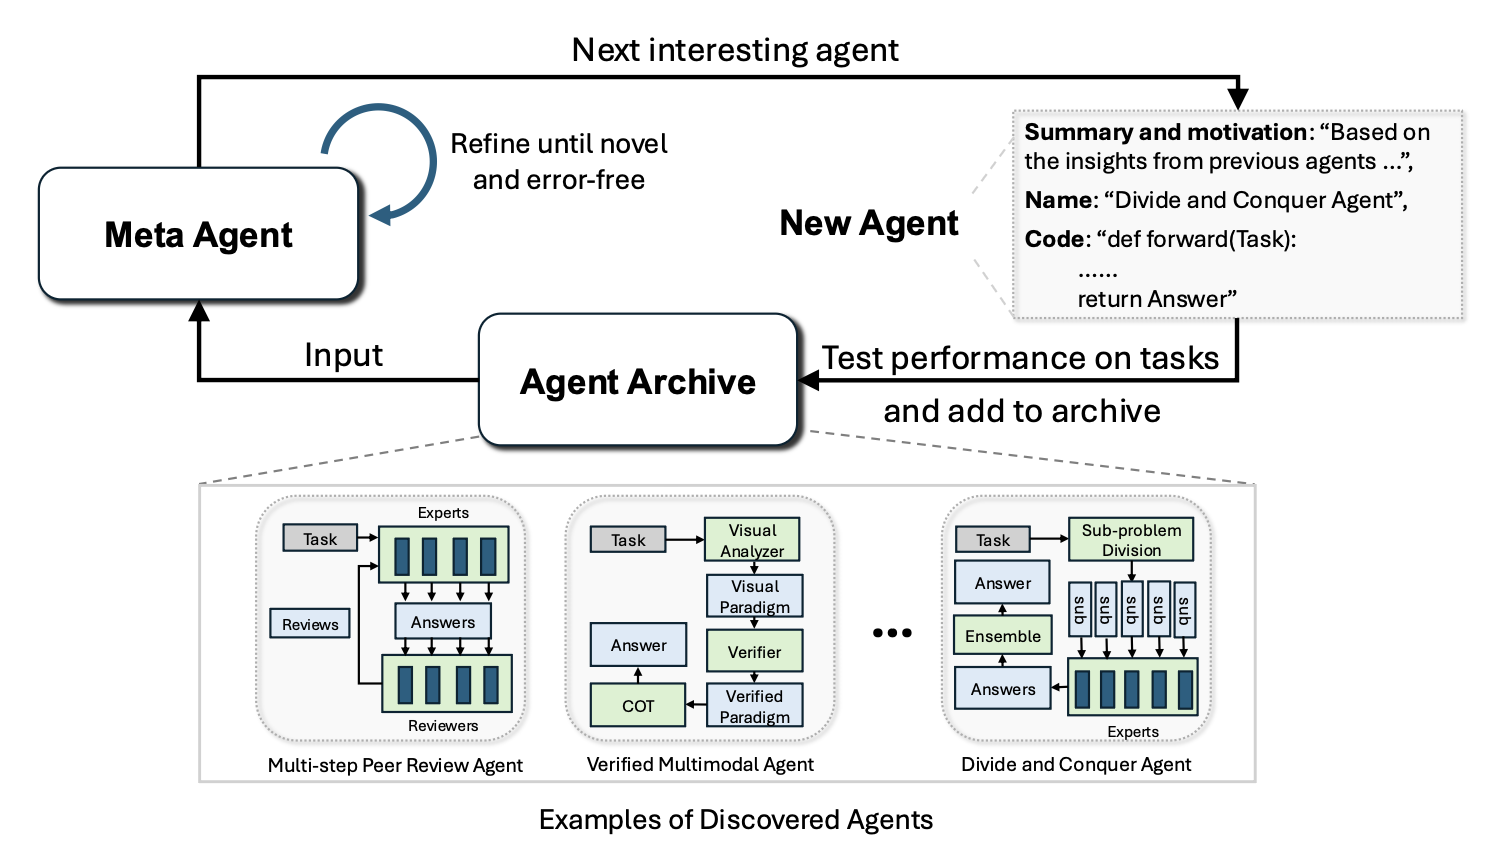
Automated Design of Agentic Systems (ADAS) 示意图。Image source: Hu et al. 2025.
AFlow(Zhang et al. 2025)把 agentic workflow 表示为图,其中节点表示调用 LLM 的动作,边用代码实现逻辑操作。工作流优化依赖 MCTS(Monte Carlo Tree Search):
- 用模板在树中初始化起始 workflow $W_0$。
- 用分数和均匀探索的 soft mixture 选择一个 workflow node。
- 要求 LLM 基于评估表现生成一个修改后的 workflow,从而扩展该节点。
- 执行并评估新 workflow。
- 如果新 workflow 在 $N$ 轮预算内显示出改进,就把它加入树。
- 重复第 2-5 步,当 top-$k$ 平均分进入平台期或预算耗尽时停止。
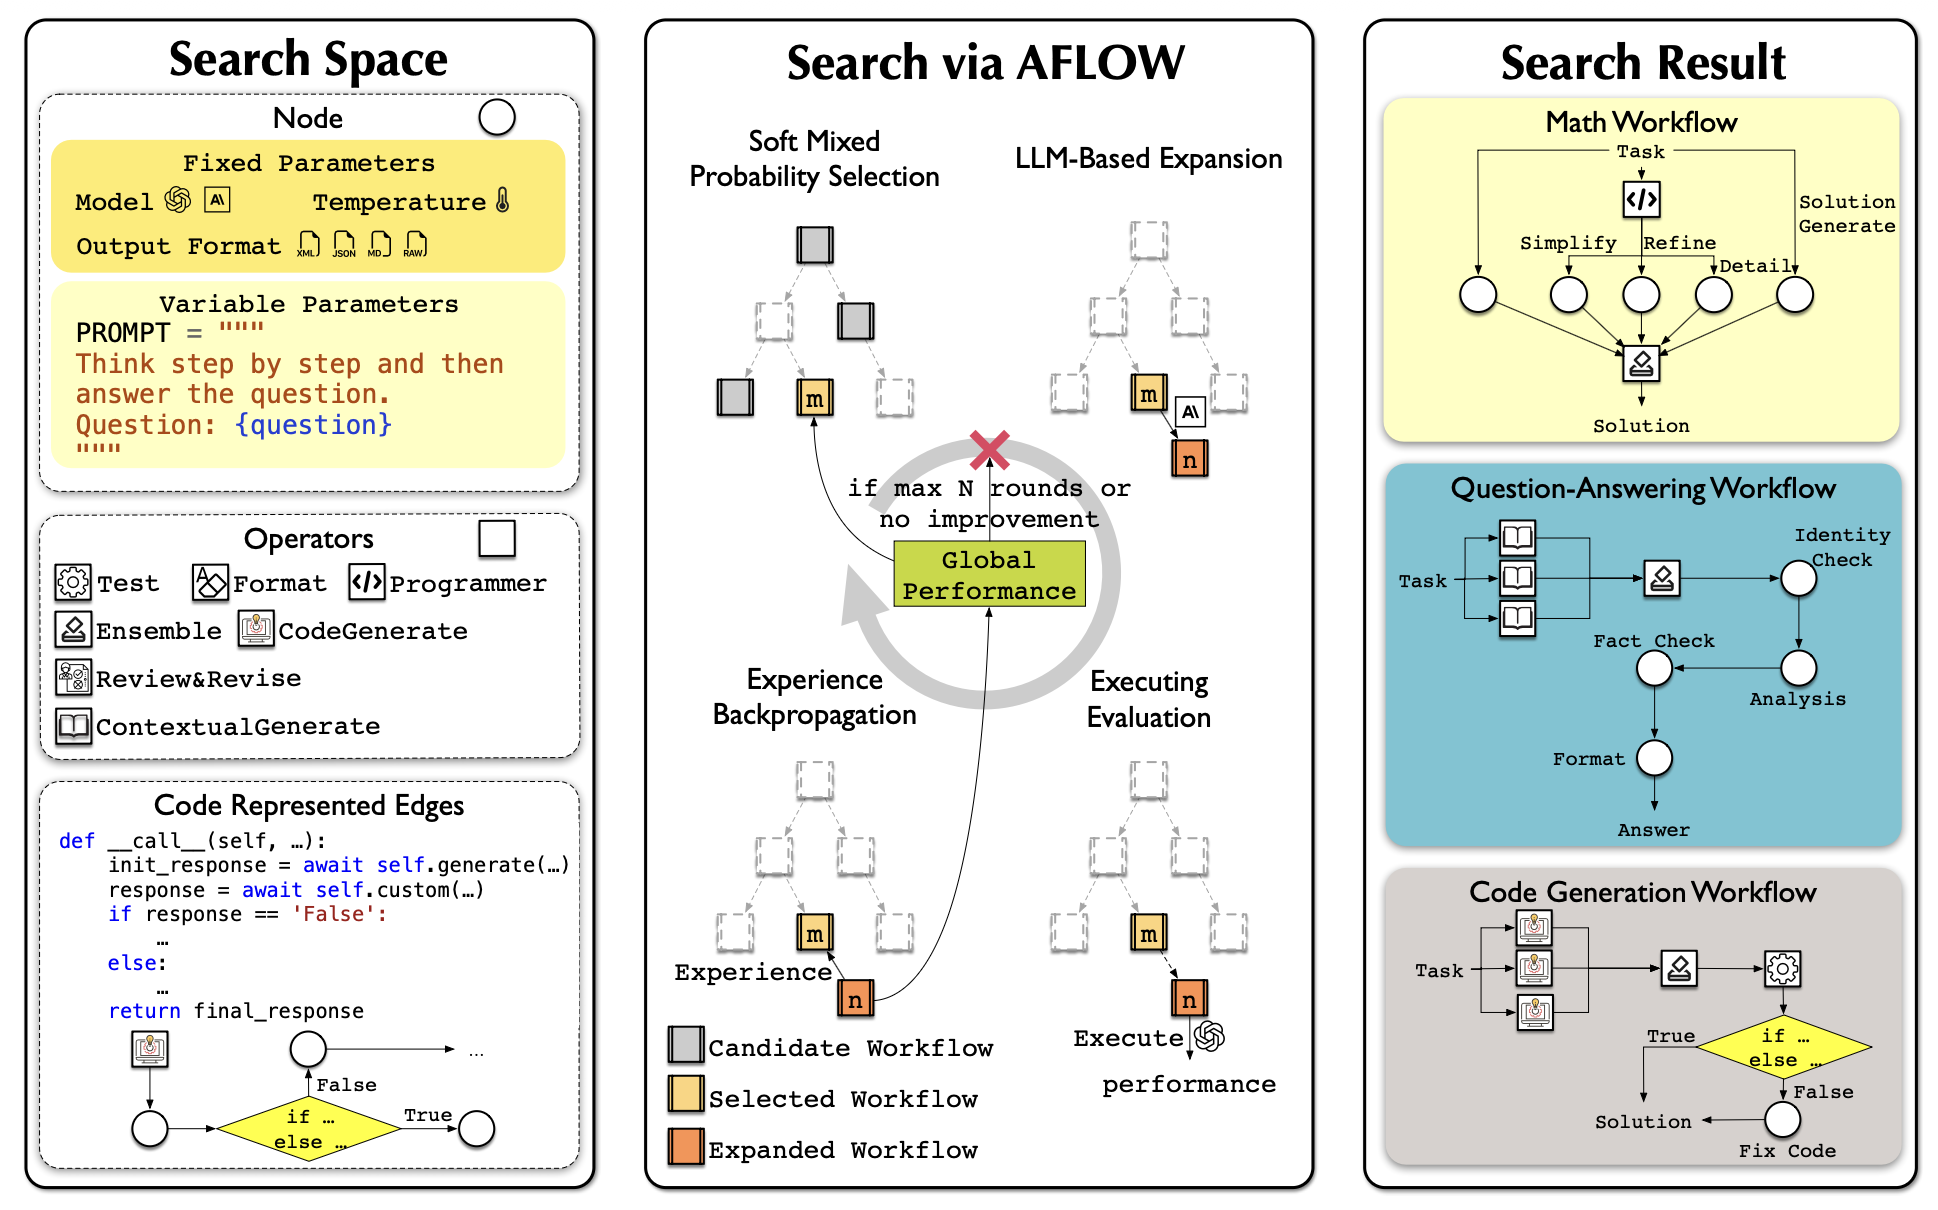
AFlow 在 workflow 候选树上的优化过程。Image source: Zhang et al. 2025.
AFlow 在 QA、代码和数学任务中的实验表明,相比手工设计工作流和 ADAS,它有不错的改进。
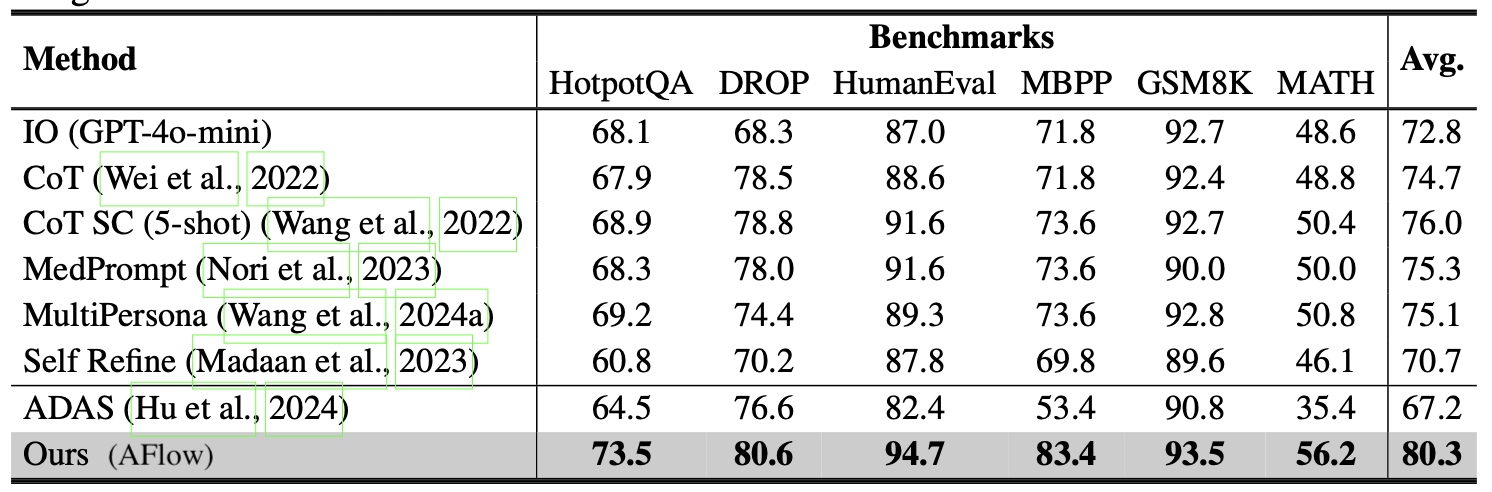
AFlow 与手工方法和 ADAS 的实验对比。Image source: Zhang et al. 2025.
自我改进 Harness
上下文工程或工作流设计都只是 harness 的一部分。我们需要在完整设计空间中搜索,并共同优化上下文管理逻辑、工作流、权限和其他许多 harness 组件。正如 Meta-Harness、ADAS 和 AFlow 这类工作所展示的,代码是定义程序和系统的通用语言。简单说,harness 就是用代码编程,决定 prompts、tool calls、subagents、control flow、memory 和 workflow logic 如何协同工作。如果 LLM 能优化执行 agent 的代码,它能访问的设计空间会比手写 prompts 大得多。
Self-Taught Optimizer(STOP;Zelikman et al. 2023)是递归式 scaffolding improvement 的早期例子之一。一个 seed improver $I_0$ 在第 $t=0$ 步接受初始解 $s$、效用函数 $u$ 和黑盒语言模型 $M$,并返回一个改进后的解 $s'$,即 $s' = I(u, s; M)$。STOP 的目标不是直接改进 $s$,而是改进 improver $I$ 本身。
先定义 meta-utility:给定 improver function $I$ 在一组下游任务 $\mathcal{D}$ 上的平均效用:
$$ \hat{u}(I) \triangleq \frac{1}{\vert\mathcal{D}\vert}\mathbb{E}_{(u,s)\sim \mathcal{D}}[u(I(u,s; M))] $$由于改进 improver function 本身也是一个优化问题,我们可以基于 $I_{t-1}$ 通过 meta-utility 衡量的表现,递归地产生新版本 $I_t$:
$$ I_t=I_{t-1}(\hat{u},I_{t-1};M) $$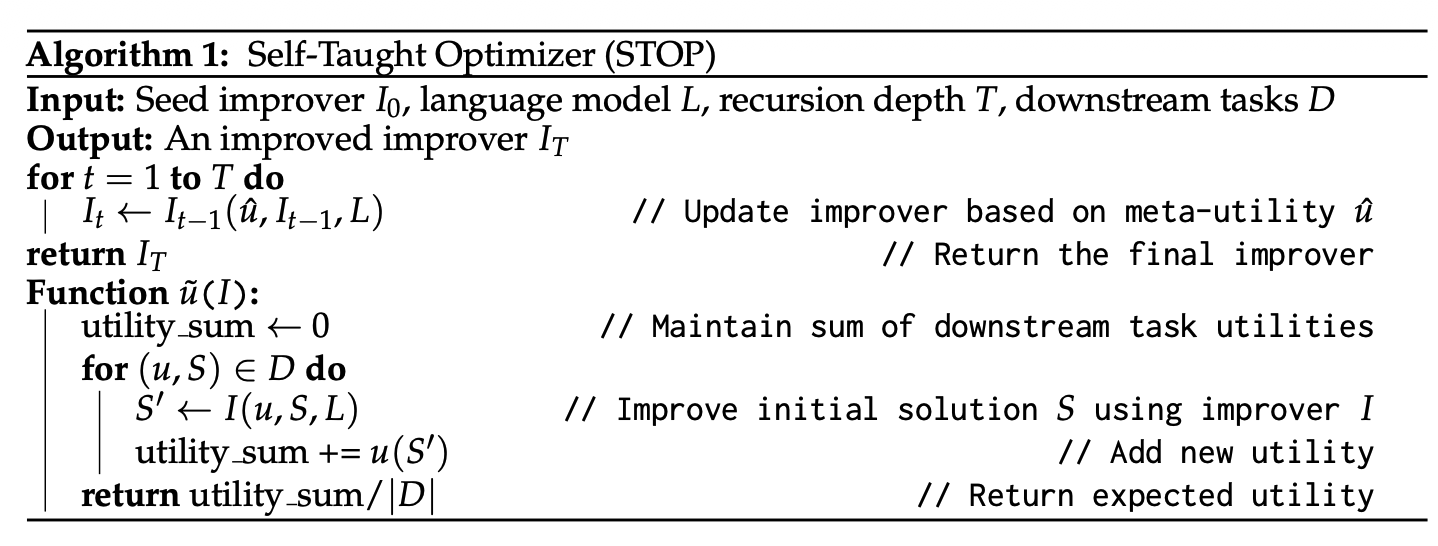
Self-Taught Optimizer (STOP) 算法。Image source: Zelikman et al. 2023.
在实验中,改进后的 improver 发现了多种策略,例如遗传算法、分解并改进局部、多臂 prompt bandits、模拟退火、改变 temperature,以及 beam/tree search。这类似于把 harness workflow 表示成可优化对象。
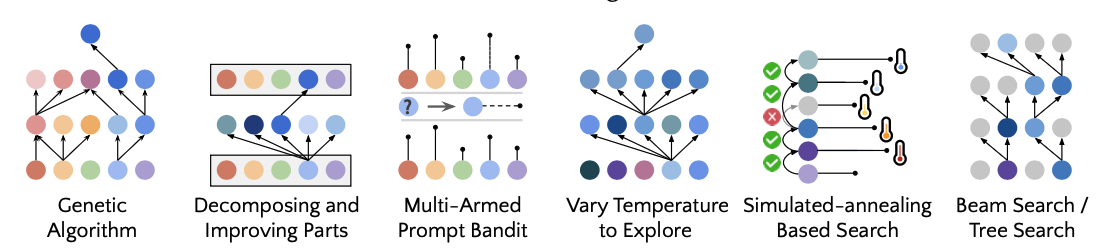
STOP 发现的自我改进策略示例。Image source: Zelikman et al. 2023.
Zelikman et al. (2023) 的一个警示性结果是:STOP 在 GPT-4 上能随着迭代提升下游平均表现,但在 GPT-3.5 和 Mixtral 等较弱模型上会退化。递归结构本身还不够。基础模型必须足够有能力,才能改进机制。这意味着 harness 改进能够让模型部署得更好,但智能仍然是核心。
Lin et al. (2026) 更详细地研究了 harness evolution 对模型能力的依赖。他们拆分出两个轴:(1)harness-updating 指产生有用 harness edits 的能力;(2)harness-benefit 指利用已更新 harness 来更好解决任务的能力。有趣的是,在他们的实验中,从 Qwen3.5-9B 到 Claude Opus 4.6,不同大小和核心智能的模型表现出相似的 harness updating capability;9B harness proposer/evolver 能写出与 Opus 在过程上同构的 skill。为了最好地利用 harness,模型需要正确且及时地调用 skills/tools,并擅长长周期指令遵循。
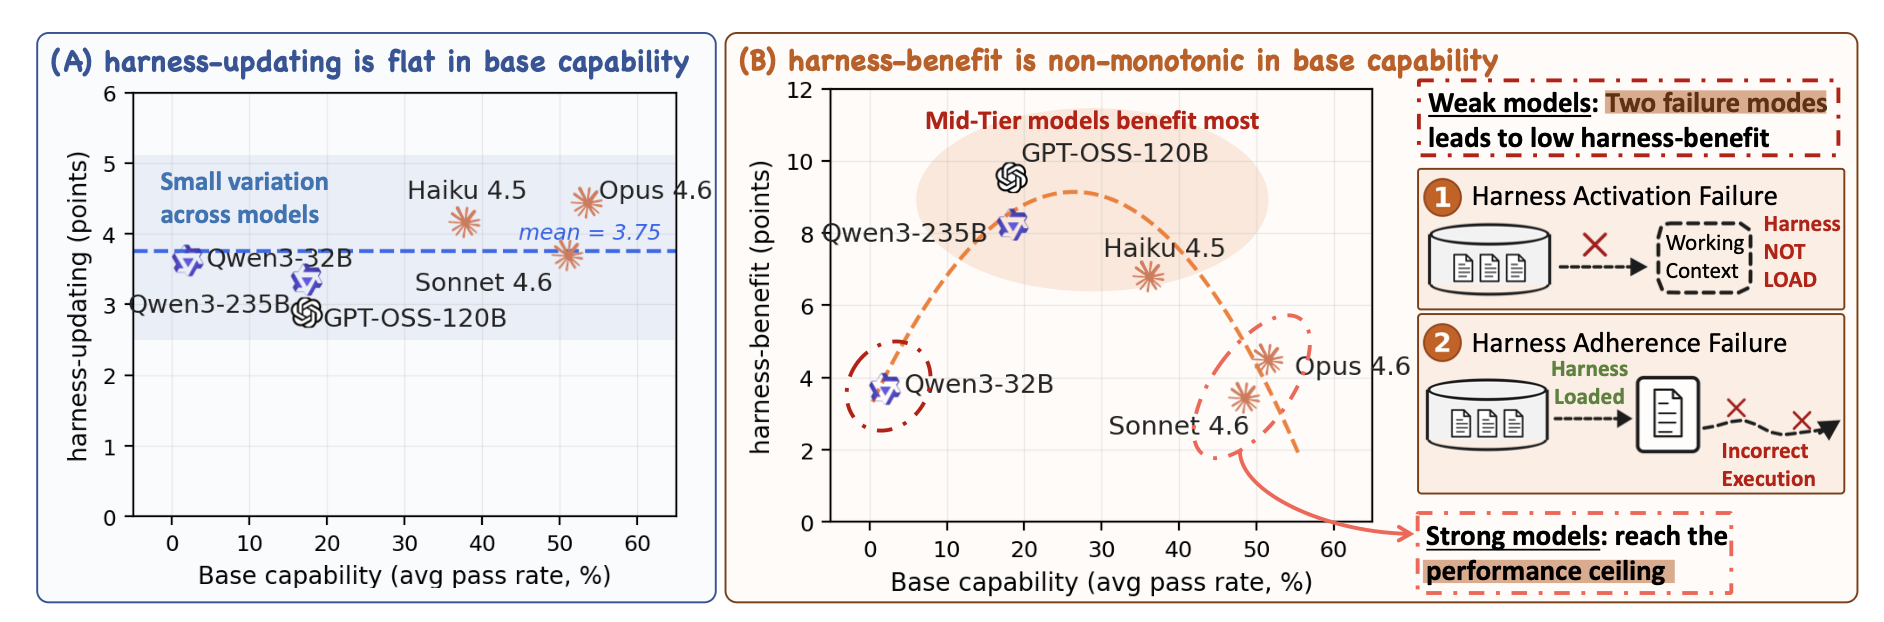
主要结果:(A) 从 Qwen2-32B 到 Opus 4.6,不同模型的 harness updating capability 大致持平;(B) harness benefit capability 非单调,中等层级模型受益最多。Image source: Lin et al. 2026.
更新的工作 Self-Harness(Zhang et al. 2026)依赖 LLM agents 通过 propose-evaluate-accept loop 改进自己的 harness。
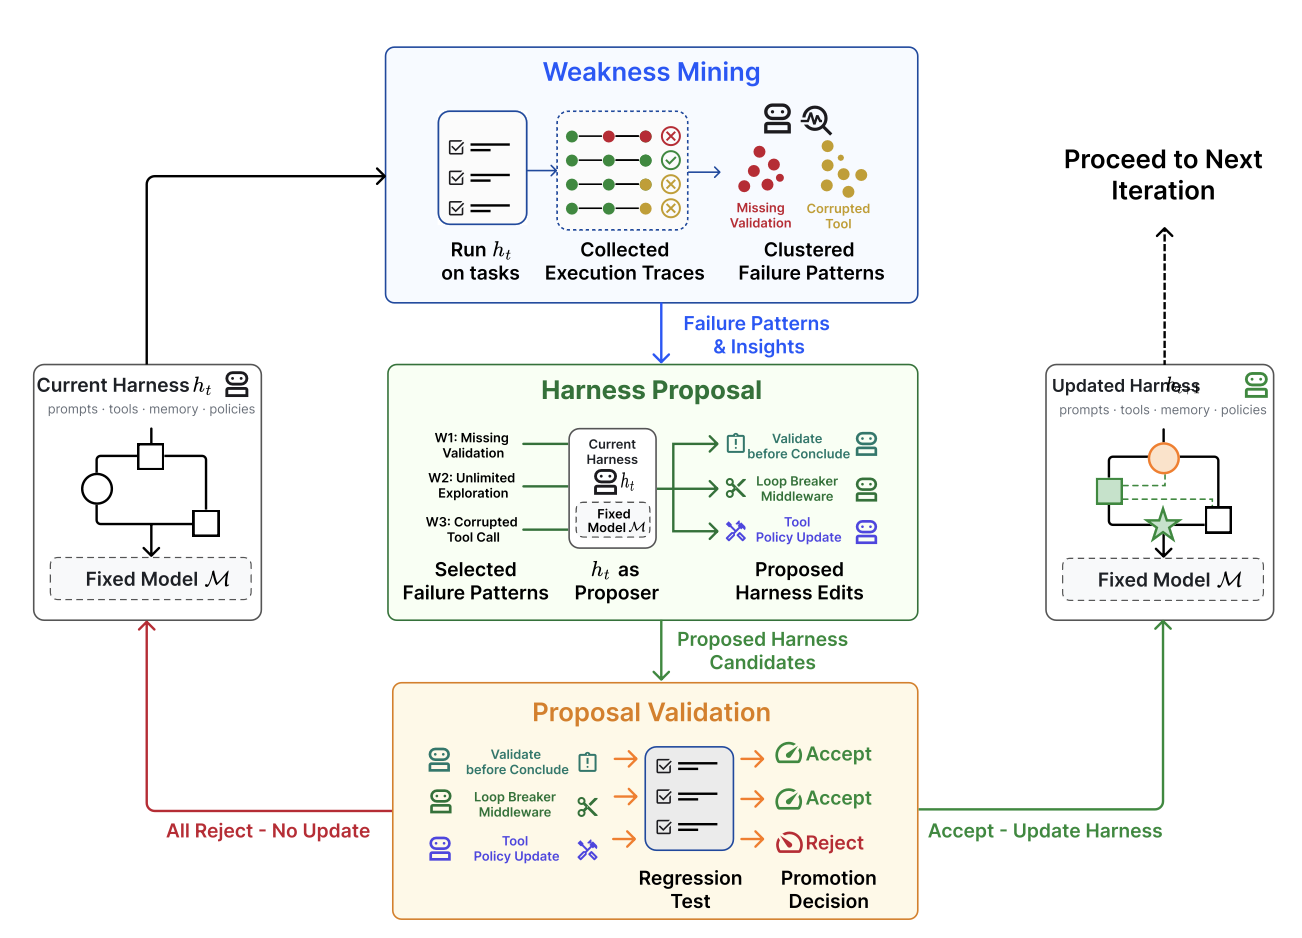
Self-Harness 通过 weakness mining、bounded harness proposal 和 validation 组成的循环来更新 harness。Image source: Zhang et al. 2026.
Self-Harness 的循环有三个阶段:
- Weakness mining:把失败聚类成 verifier-grounded failure patterns。
- 当前 harness $h_t$ 用于在任务上评估,并收集 execution traces 用于分析。
- 注意,两个运行在表层错误日志中可能拥有同样的 verifier outcome,例如 timeout 或 missing artifact,但背后的因果机制不同。因此我们需要信息丰富的 failure record,其中包含终端 verifier-level cause、相关 agent 行为的因果状态,以及 trace 暴露出的抽象 agent 机制,用于揭示根因。
- Harness proposal:基于挖掘出的 failure patterns 提出有界 harness edits。
- 同一个模型在 $h_t$ 下作为 proposer 被调用。
- 模型会得到一个有界 proposal context:(1)当前 harness 的可编辑表面;(2)来自评估系统的 verifier-grounded failure patterns;(3)应被保留的 passing behaviors 记录;(4)此前尝试过的 edits 摘要。
- Harness edits 应该优先选择反复出现、可处理(例如不是任务特定难度)且能通过窄改动解决的错误模式。
- Harness edit candidates 应该彼此不同且多样。
- Proposal validation:验证并合并合格 edits,创建新 harness $h_{t+1}$。
- Candidate edits 会在 held-in $D_\text{in}$(用于测试 weakness 是否被解决)和 held-out $D_\text{out}$(用于检查是否引入其他未知问题)split 上通过 regression tests 评估。
- 只有在 held-in 和 held-out 数据上都没有 regression 的 candidate 才会被接受。
- 被接受的 candidate 会合并并更新 harness 到 $h_{t+1}$;被拒绝的 candidate 会被记录,但不改变 active harness。
在 Terminal-Bench-2 上运行 MiniMax M2.5、Qwen3.5-35B-A3B 和 GLM-5 时,Self-Harness 被证明可以学习模型特定的 harness instructions,针对不同基础模型的不同弱点,并提升 held-out pass rate。
Self-harness 这类工作也让我担心:如果一个程序被允许编辑 OS system,抽象边界就会被打破。可编辑表面需要被妥善设计,权限控制和安全层需要位于这个循环之外。围绕 reward hacking 的所有挑战仍然存在。
Agentic Harness Engineering(AHE;Lin et al. 2026)认为 harness evolution 的瓶颈在于可观测性:当 rollout 失败时,我们需要知道哪个组件负责,并且每个 edit 都应该有证据支撑。
该框架用 3 个可观测性支柱构建闭环:
- 组件可观测性:每个可编辑 harness component 都在文件系统中有表示,因此 action space 是显式且可追踪的。
- 一个 harness 包含 7 个组件:system prompt、tool description、tool implementation、middleware、skill、sub-agent configuration 和 long-term memory。
- 每个 failure pattern 都映射到一个组件,使 edit 更有针对性。
- 经验可观测性:把大量原始轨迹分析并总结成证据和 failure patterns 的层级结构。
- 每个 harness 生成 $k$ 条 traces。
- 使用一个 agent(“Agent debugger”)分析每条存储在文件中的 trajectory,并生成 per-task analysis report,说明失败或成功的根因。
- 所有 per-task reports 会聚合成下一步使用的 benchmark overview;如有需要,仍可访问 raw traces。这种分层访问结构更节省 token。
- 决策可观测性:每个 edit 都配有对下一轮的预测,以便验证。
- 一个 agent(“Evolve agent”)读取 repo,决定编辑哪个组件,然后产出 edit 及其背后的推理。
- 每个 edit 都是文件级、可证伪的 claim,并可以在下一轮验证,受两个约束限制:
- Edits 只能应用到 harness workspace。runs directory、tracer、verifier 和 LLM configuration 是只读的,这会禁用一组 reward hacking 手段,例如禁用 verifier、替换模型或提高 reasoning budget,因此能让每个记录到的收益都归因于 harness edits。
- Edits 是 evidence-driven,并带有 manifesto entry:failure evidence 名称、推断出的根因、目标修复,以及包含 expected fixes 和 at-risk regressions 的 predicted impact。
在 Terminal-Bench-2 上,AHE 的表现优于人类设计的 harness(OpenCode、Terminus-2、Codex),Hard tier 除外;同时也优于一些 self-evolve baselines(ACE、TF-GRPO)。同一个 frozen harness 在不继续演化的情况下迁移到 SWE-bench-verified,说明演化后的 harness 能把工程经验编码进 harness components,而不是只做 benchmark-specific optimization。
演化式搜索
演化式搜索是一种受自然选择启发的优化方法(见我之前关于演化算法的文章)。它通过 mutation 演化一个解的种群,并只保留群体中“fitness”高的解。当(1)搜索空间很大或形状奇怪;(2)很难直接用梯度优化但容易评估候选解时,演化式搜索很有用。Harness search 看起来很适合这一点。
过去的研究已经把演化式搜索用于 prompt engineering。Promptbreeder(Fernando et al. 2023)通过丰富的 mutation operations 优化 task-specific prompts;有趣的是,mutation prompts,也就是要求 LLM 改写 task prompt 的指令,本身也会通过演化得到改进。GEPA(Agrawal et al. 2025)把基于 reflection 的 prompting 与演化式搜索结合起来,并使用对 trial-and-error 轨迹的自然语言反思来提出 prompt updates。
Novikov et al. (2025) 提出了 AlphaEvolve,一个 coding-agent evolutionary search system。它保存一组候选程序,并 prompting frozen LLM 生成用于改进的 diffs。随着系统反复评估 child programs 并保留成功候选,它会逐步发现更好的解。
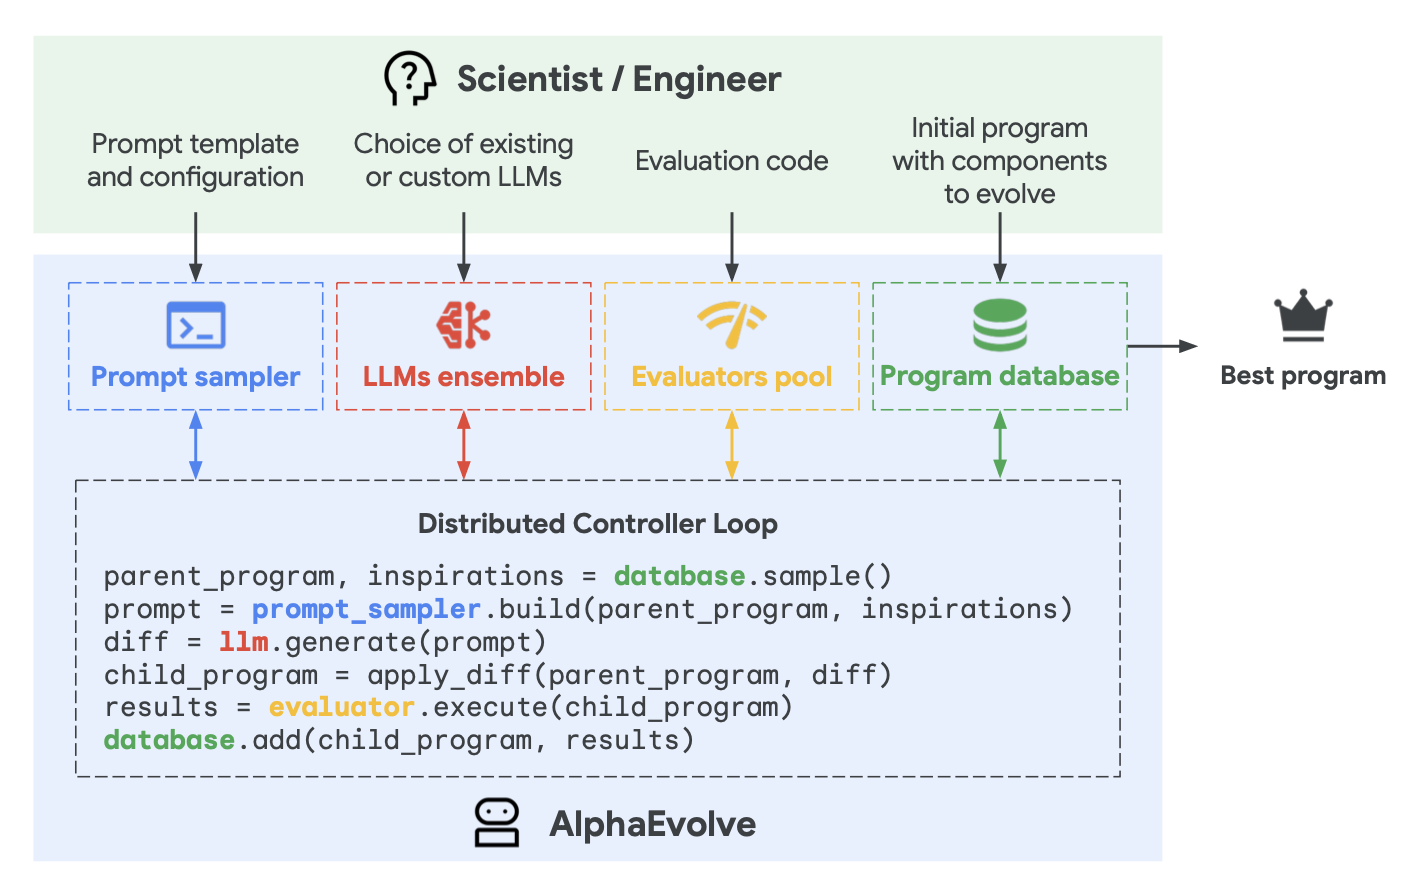
AlphaEvolve 如何工作。Image source: Novikov et al. 2025.
AlphaEvolve 设计中有几个细节很重要:
- Prompt 包含 parent programs、results、instructions,有时还有 meta information。
- Coding agent 可以访问完整 repo,但允许改进的代码区域会用
# EVOLVE-BLOCK-START和# EVOLVE-BLOCK-END明确标出。 - Meta-prompt 会根据 LLM 建议与 instructions 和 context 共同演化,方式类似 solution programs 的演化。
Ablation 表明,evolution procedure、prompt 中的 context、meta-prompts、full-file evolution 以及使用更强 LLM 都有价值。
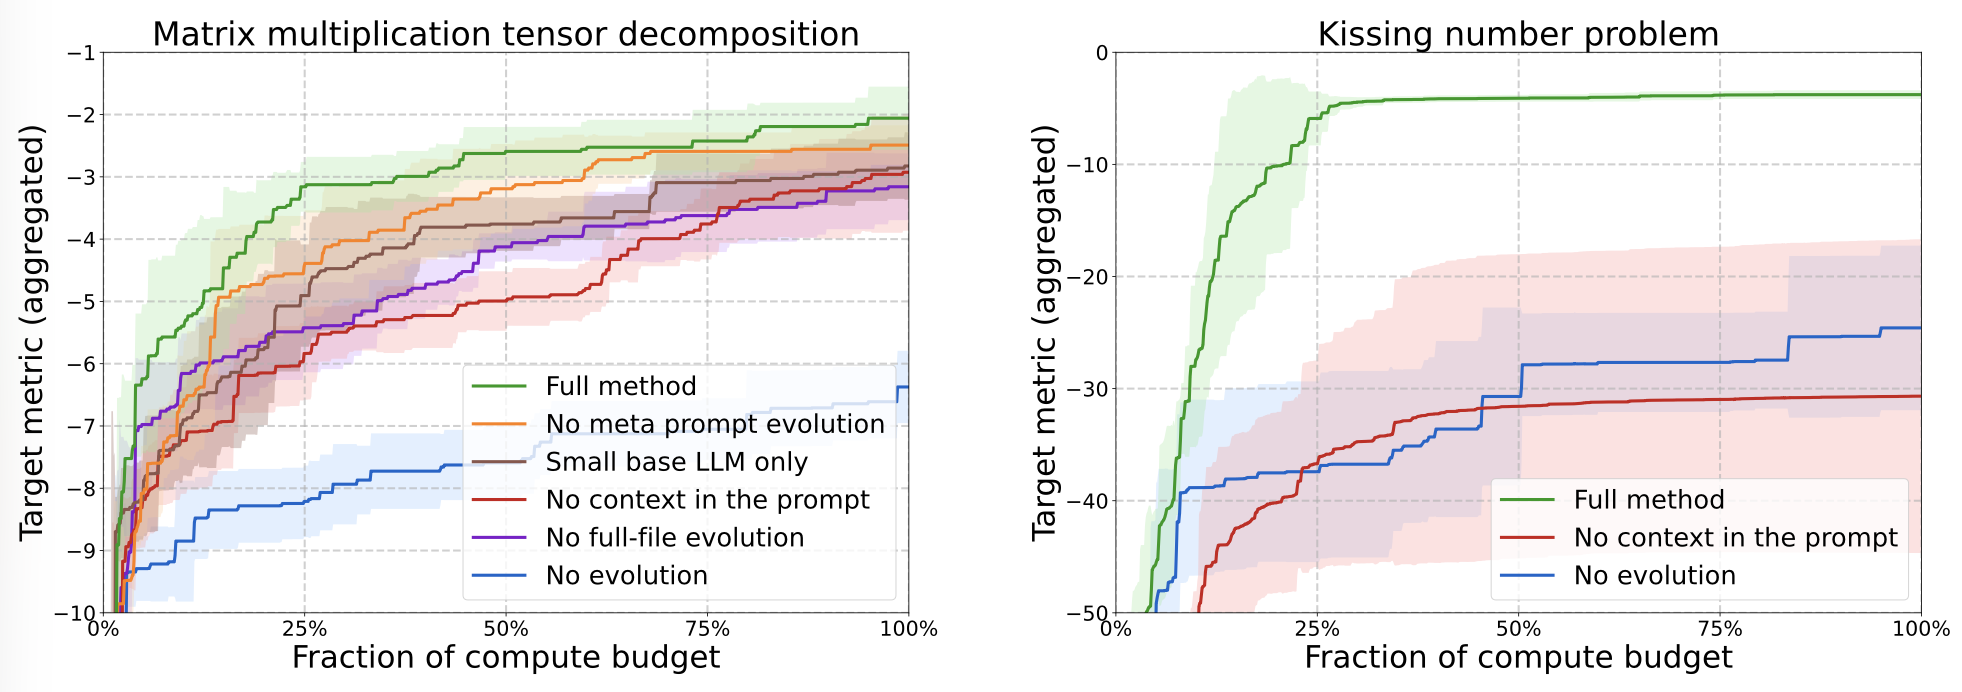
Ablation 展示 AlphaEvolve 中多个设计的价值。Image source: Novikov et al. 2025.
近期变体包括 ThetaEvolve(Wang et al. 2025),它把演化式搜索与 RL 和 in-context learning 结合起来;DemoEvolve(Che, et al. 2026)用人类专家示范作为 harness-level diagnosis 和 editing 的参考经验,增强 self-rollout archive。另一方面,ShinkaEvolve(Lange et al. 2025)引入三个新组件来提升 LLM sampling efficiency:
- 通过设计 parent sampling,在 performance rank 和 offspring count 之间平衡,从而实现更高 sample efficiency 的探索。
- Code-novelty rejection sampling:基于 embedding cosine similarity 丢弃与现有种群过于相似的 candidates。
- 在 meta-scratchpad 中识别成功解里的好模式,用于指导未来 mutation。
不同于上述专注于 solution improvement 的方法,Darwin Gödel Machine(DGM;Zhang et al. 2025)明确以可编辑 harness-code repository 的演化为目标,并使用 LLM-based coding agent。准确地说,这个 agent 被允许修改自己的 harness。后续 Hyperagents 工作(Zhang et al. 2026)引入了 meta-agent,用于控制如何修改既有 task agents 来创建新 agent。
- 从池中的一个 coding agent 开始。
- 每次迭代中,以与性能成正比、与已有子代数量成反比的概率选择一个 parent,修改并分支生成新 agent。
- 被选中的 parent agent 检查自身 benchmark evaluation log,然后提出对自身 harness codebase 的改进,生成新版 coding agent。代码编辑通过两个基础工具实现:(1)bash(args:
<bash_command>);(2)editor(args:view/create/edit <file_path>)。 - 新 coding agents 被评估,只有性能足够高的才会被加入池中。
- 重复第 2-4 步,直到达到某个停止条件。
DGM 是固定模型下的 harness evolution。在以 Claude 3.5 Sonnet 作为基础 LLM、使用简单初始 harness configs 的实验中,DGM 发现的 agents 在 SWE-bench Verified(20% 到 50%)和 Polyglot(14.2% 到 30.7%)上能达到或超过手工构造 agents。
这类方法在候选解可自动评估、候选 fitness 容易量化时表现很好,例如矩阵乘法、GPU kernel 优化、算法竞赛、数据中心调度。它在评估缓慢、模糊或主要依赖启发式指标的领域会更吃力。演化的计算效率和有效性也是值得关注的问题。
与模型权重联合优化
Harness evolution 改变的是模型周围的非参数系统。为了实现完整自我改进,模型当然也可以被允许同时更新自己的权重。权重更新可以通过改进模型训练流水线,或通过测试时持续学习来实现。持续学习这个主题值得未来单独写一篇文章。
SIA(Hebbar et al. 2026)是把 harness improvement 和 model-parameter updates 组合进同一个优化循环的早期尝试,其设计包含三个组件:
- Meta-Agent:提出初始 harness。
- Task-Specific Agent:执行任务。
- Feedback-Agent:根据近期轨迹选择更新 harness 还是模型权重。
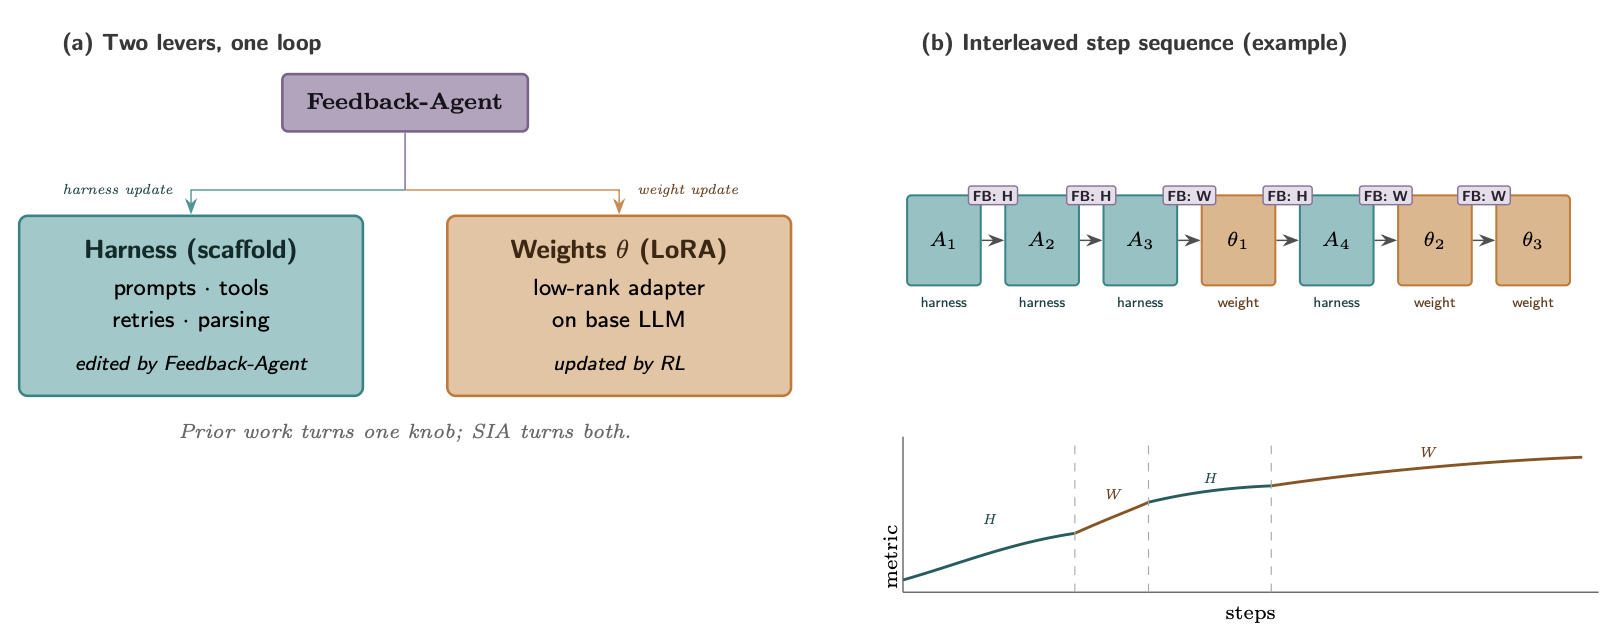
SIA 中的 Feedback-Agent 决定下一次迭代类型。Image source: Hebbar et al. 2026.
SIA 实验中有一些混杂选择,让结果难以解释。例如,task-specific agent 明显弱于 Meta-Agent 和 Feedback-Agent 使用的模型(gpt-oss-120b vs Claude Sonnet 4.6),baseline 也太弱,难以与相关方法清晰交叉参照。我认为这个方向很有趣,但证据仍是初步的。训练稳定性和 Goodhart effect 等许多挑战仍然开放。
Continual Harness(Karten et al. 2026)在长周期 gameplay setting 中实验了 harness updating,并通过蒸馏强 teacher model 在 low-reward trajectories 上的 labels 来共同学习 policy model。
未来挑战
AI Scientist 这一系列工作强有力地展示了:专家设计的 harness 能协调自动研究循环中的很大一部分,并以写研究论文的形式做了实验。但论文生产不等于科学发现。一个系统可以写出看似可信的 manuscript,同时仍然存在 fabricated citations、implementation drift 或弱实验结果。
Trehan & Chopra (2026) 测试了 LLM 是否能在 minimal scaffolding 和基础工具(即 read_file、write_file、llm_search、list_files)下,从研究想法走到论文。每个想法都有独立 workspace,agents 可以生成和读取文档作为上下文的一部分。他们在三个领域做实验:world models、multi-agent RL、AI safety & alignment;每个领域包含 45-50 份高质量 seed documents 用于激发新想法。只有四个想法被人类专家选中进入完整 pipeline,只有一个被完整执行成论文。他们在实验中观察到六类反复出现的失败模式:
- 偏向训练数据默认值:使用旧库、过期命令、标准格式,或没有基于实际 repo/dataset 的假设。
- 执行压力下的实现漂移:当实现变得技术上复杂时,模型可能转向常见的更简单方案,而不是原先提出的方法。
- 记忆和上下文退化:长周期项目会丢失关键细节,除非日志被写成持久 artifacts。
- 过度乐观:即使实验有噪声或失败,模型也会宣称成功。类似模式也被 Bubeck et al. (2025) 观察为“p-hacking and eureka-ing”:模型会加入“numerical duct tape”,并在信号仍是噪声时宣布胜利。
- 领域智能不足:模型缺少 tacit craft knowledge,例如预测实现复杂度、判断实验结果是否可信,或知道哪些 baselines 重要。
- 科学品味薄弱:实验可能可执行,但没有回答正确的问题。
面向完整 RSI,研究者已经取得真实进展,但仍有几个瓶颈。
1. 弱且模糊的评估器。 许多研究 claim 没有快速精确的 verifier,很多真实世界任务也一样。当前自我改进循环最适合评估指标可测量且客观的任务,这和 RL 的工作方式类似。
Research taste、新颖性和长期科学价值更难衡量。例如,research taste 往往混合了问题 framing、实验设计,以及判断哪些惊讶结果值得追踪、哪些失败案例值得重试的能力。
2. 上下文和记忆生命周期。 随着 AI agents 变得更自主、更独立,记忆会不断增长。一个有用的 harness 需要管理上下文和记忆,以弥补长上下文生成现有局限,同时最大化长周期任务成功率。由于人类能在一生中维持记忆,我看到一个类比:上下文工程应该并且将会成为智能的核心部分,而不是停留在软件系统层。
3. 负面结果。 研究者有动机发表成功结果,因此文献会偏向成功。LLM 训练在海量数据上,而这些数据至少目前大多由人类创造,可能因为数据中成功与失败案例的不平衡,而不擅长决定何时放弃假设、报告负面结果,甚至承认失败。Research harness 应该让失败尝试易于保存,因为从失败中学习是缩小任务搜索空间的最佳方式。
4. 多样性坍缩。 演化循环和 RL 循环倾向于利用已知高奖励模式。我们需要机制防止种群坍缩成同一种解的变体。这对开放式研究尤其关键,因为最佳路径在当前评估器下最初可能看起来更差。
5. Reward hacking。 自我改进循环会优化它得到的任何信号。如果奖励来自 unit tests,agent 可能 overfit 到测试;如果来自 judge model,它可能学会针对该 judge 的 reward hacking 技巧;如果来自 benchmark scores,它可能利用 benchmark artifacts。
评估器和权限控制很可能应该位于演化 harness 的循环之外,并配合 held-out tests、trace audits,以及在关键决策点引入 human review。监督能在多大程度上扩展并自动化,仍是开放研究问题。
6. 长期成功。 外在优化循环依赖单个 rollout 之外的奖励,而这些奖励可以在训练 sandbox 中模拟。
以 coding agent 为例。Coding agents 已经提升了软件工程中的日常生产力,但许多优化目标仍然太短期。它通常能完成手头任务,但它应该如何保护一个由成百上千名工程师共同维护的 repo 的长期健康,就没那么清楚了。标准的 sandbox-based RLVR-style training 很少捕捉可维护性、ownership boundaries、migration cost、backwards compatibility 或未来 debugging burden。
7. 人类的角色。 人类应该上移到更高层,而不是被移出循环;也就是说,人类应该在正确时间、正确抽象层级提供监督,系统设计也应该考虑何时以及如何设置这些 touch points。
上面列出的许多挑战都需要人类反馈和引导。毕竟,我们是在为人类更好的未来构建技术,而不是反过来。
引用
请按如下格式引用本文:
Weng, Lilian. “Harness Engineering for Self-Improvement”. Lil’Log (Jul 2026). https://lilianweng.github.io/posts/2026-07-04-harness/
或使用 BibTeX:
@article{weng2026harness,
  title = {Harness Engineering for Self-Improvement},
  author = {Weng, Lilian},
  journal = {lilianweng.github.io},
  year = {2026},
  month = {July},
  url = "https://lilianweng.github.io/posts/2026-07-04-harness/"
}
附录:一些有用的基准
- PaperBench:从零复现 20 篇 ICML 2024 Spotlight 和 Oral 论文,包括理解论文贡献、开发代码库并成功执行实验。
- 每个复现任务被拆分成更小、可单独评分的任务。
- 总共有 8,316 条 rubrics,由论文作者共同开发。
- 当时最好的模型(
Claude 3.5 Sonnet,约 21%)没有超过 ML PhDs。 - 包含 PaperBench、PaperBench Code-Dev(较轻量版本)和 JudgeEval。
- CORE-Bench:评估已发表研究的计算可复现性。
- 包含跨计算机科学、社会科学和医学的 90 篇科学论文,共 270 个任务。
- 任务涉及用提供的代码和数据复现结果。
- 包含多个难度级别,以及 language-only 和 vision-language 任务。
- 当时报告的最佳 agent(
GPT-4o和GPT-4o-mini)在最难任务上仅达到 21% 准确率。
- ScienceAgentBench:评估 LLM agents 进行数据驱动科学发现的能力。
- 从数学、化学、生物、地理四个学科的 44 篇同行评审出版物中抽取 102 个任务。
- 覆盖这些领域中的基础数据科学任务:数据处理、模型开发、数据分析和信息可视化。
- RE-Bench:在真实 ML research-engineering 环境中,将前沿 AI agents 与人类专家对比评估。
- 7 个具有挑战性、开放式的 ML research-engineering 环境。
- 每个环境 = scoring function、starting solution、reference solution;每个环境可用 8 张或更少 H100 GPU 运行。
- 示例包括优化 kernel、运行 scaling-law experiment、修复 embedding、微调 GPT-2 做 QA 等。
- 包含来自 61 位不同人类专家的 71 次 8 小时尝试数据。
- 人类专家在 82% 的 8 小时尝试中获得非零分;24% 达到或超过强 reference solutions。
- 最佳 AI agents 在 2 小时预算下得分是人类的 4 倍,但人类在更长预算下有更好的边际收益,并在 8 小时和 32 小时设置下超过 agents。
- MLE-bench:在离线 Kaggle competitions 上评估 ML engineering agents。
- 包含 75 个从 Kaggle 筛选出的 ML-engineering competitions。
- 测试训练模型、准备数据集、运行实验并向评分脚本提交预测。
- 使用 Kaggle public leaderboards 作为人类 baseline。
- 论文中最佳设置
o1-preview+ AIDE scaffolding,在 16.9% 的 competitions 中至少达到 Kaggle bronze-medal level。 - 包含 resource-scaling 和 contamination 分析。
- KernelBench:评估生成 GPU kernels 的正确性和速度。
- 包含 250 个 PyTorch 任务,用于评估 LLM 是否能写出快速且正确的 kernels。
- 评估指标 fast_p = 生成 kernel 中正确且快于 baseline 的比例。
参考文献
[1] Good, I. J. “Speculations Concerning the First Ultraintelligent Machine.” Advances in Computers, 6:31-88, 1965.
[2] Yudkowsky, Eliezer. “Recursive Self-Improvement.” LessWrong, 2008.
[3] Choi, et al. “Anchored Self-Play for Code Repair.” ICML 2026.
[4] Zhao, et al. “Absolute Zero: Reinforced Self-play Reasoning with Zero Data.” arXiv preprint arXiv:2505.03335, 2025.
[5] Yuan, et al. “Self-Rewarding Language Models.” arXiv preprint arXiv:2401.10020, 2024.
[6] Chen, et al. “Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models.” ICML 2024.
[7] Zhang, et al. “Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models.” ICLR 2026.
[8] Ye, et al. “Meta Context Engineering via Agentic Skill Evolution.” arXiv preprint arXiv:2601.21557, 2026.
[9] Lee, et al. “Meta-Harness: End-to-End Optimization of Model Harnesses.” arXiv preprint arXiv:2603.28052, 2026.
[10] Lu, et al. “Towards end-to-end automation of AI research.” Nature, 651:914-919, 2026.
[11] Meng, et al. “ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence.” arXiv preprint arXiv:2605.26340, 2026.
[12] Kulikov, et al. “Autodata: An agentic data scientist to create high quality synthetic data.” arXiv preprint arXiv:2606.25996, 2026.
[13] Hu, Lu, and Clune. “Automated Design of Agentic Systems.” ICLR 2025.
[14] Madaan, et al. “Self-Refine: Iterative Refinement with Self-Feedback.” NeurIPS 2023.
[15] Zhang, et al. “AFlow: Automating Agentic Workflow Generation.” ICLR 2025.
[16] Zelikman, et al. “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation.” COLM 2024.
[17] Zhang, et al. “Self-Harness: Harnesses That Improve Themselves.” arXiv preprint arXiv:2606.09498, 2026.
[18] Fernando, et al. “Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution.” arXiv preprint arXiv:2309.16797, 2023.
[19] Agrawal, A. et al. “GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning.” arXiv preprint arXiv:2507.19457, 2025.
[20] Novikov, et al. “AlphaEvolve: A coding agent for scientific and algorithmic discovery.” arXiv preprint arXiv:2506.13131, 2025.
[21] Lange, Imajuku, and Cetin. “ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution.” arXiv preprint arXiv:2509.19349, 2025.
[22] Wang, et al. “ThetaEvolve: Test-time Learning on Open Problems.” arXiv preprint arXiv:2511.23473, 2025.
[23] Zhang, et al. “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents.” arXiv preprint arXiv:2505.22954, 2025.
[24] Zhang, et al. “Hyperagents.” arXiv preprint arXiv:2603.19461, 2026.
[25] Yuksekgonul, et al. “Learning to Discover at Test Time.” arXiv preprint arXiv:2601.16175, 2026.
[26] Riaz, et al. “Epistemic Uncertainty for Test-Time Discovery.” arXiv preprint arXiv:2605.11328, 2026.
[27] Hebbar, et al. “SIA: Self Improving AI with Harness & Weight Updates.” arXiv preprint arXiv:2605.27276, 2026.
[28] Trehan and Chopra. “Why LLMs Aren’t Scientists Yet: Lessons from Four Autonomous Research Attempts.” arXiv preprint arXiv:2601.03315, 2026.
[29] Bubeck, et al. “Early science acceleration experiments with GPT-5.” arXiv preprint arXiv:2511.16072, 2025.
[30] Starace, et al. “PaperBench: Evaluating AI’s Ability to Replicate AI Research.” ICML 2025.
[31] Wijk, et al. “RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts.” ICML 2025.
[32] Chan, et al. “MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering.” arXiv preprint arXiv:2410.07095, 2024.
[33] Chen, et al. “ScienceAgentBench: Toward Rigorous Assessment of Language Agents for Data-Driven Scientific Discovery.” ICLR 2025.
[34] Siegel, et al. “CORE-Bench: Fostering the Credibility of Published Research Through a Computational Reproducibility Agent Benchmark.” TMLR 2024.
[35] Ouyang, et al. “KernelBench: Can LLMs Write Efficient GPU Kernels?” arXiv preprint arXiv:2502.10517, 2025.
[36] Lin, et al. “Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents.” arXiv preprint arXiv:2605.30621, 2026.
[37] Lin, et al. “Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses.” arXiv preprint arXiv:2604.25850, 2026.
[38] Karten, et al. “Continual Harness: Online Adaptation for Self-Improving Foundation Agents.” arXiv preprint arXiv:2605.09998, 2026.
[39] Che, et al. “DemoEvolve: Overcoming Sparse Feedback in Agentic Harness Evolution with Demonstrations.” arXiv preprint arXiv:2605.24539, 2026.