基本概论
| 符号 | 含义 |
|---|---|
| state $s$ | 状态 |
| Action $a$ | 动作 |
| Policy $\pi$ | 决策函数,根据状态做出决策到控制 Agent 的动作(马里奥上下左右) |
| reward $R$ | 奖励,最影响强化学习的结果 |
| state transition | 状态转移 $\text{old-state} \rightarrow \text{new-state}$,一般是随机的,随机性从环境来 |
| Return $U(t)$ | 回报,把t时刻以后的奖励加起来 $U_t = R_t+R_{t+1}+R_{t+2}+\dots$ |
| Discounted Return $U(t)$ | 带有衰减 $U_t=R_t+\gamma R_{t+1} + \gamma ^2 R_{t+2} + \gamma ^3 R_{t+3}+\dots$ |
| Action-value Function $Q_\pi(s,a)$ | 动作价值函数,评判动作好坏 $Q_\pi(s_t,a_t) = \mathbb{E}[U_t \mid S_t = s_t,A_t = a_t]$ |
| State-value Function $V_\pi(s)$ | 状态价值函数,来评价策略函数的好坏 $V_\pi(s_t) = \mathbb{E}_A[Q_\pi(s_t,A)] = \sum_{a} \pi(a \mid s_t) \cdot Q_\pi(s_t, a)$ |
决策函数
Policy function $\pi: (s, a) \in [0, 1]$,就是一个 PDF :
$$\pi(a \mid s) = \mathbb{P}(A = a \mid S = s).$$强化学习就是学习这个 Policy function $\pi$, 来指导 Agent 观测 $\mathcal{s}$ 来做出动作 $\mathcal{a}$。这个 $\pi$ 使得Agent 动作有随机性, 这样才不会被“对手”算出来下一步动作, 所以 $\pi$ 最好是一个PDF。
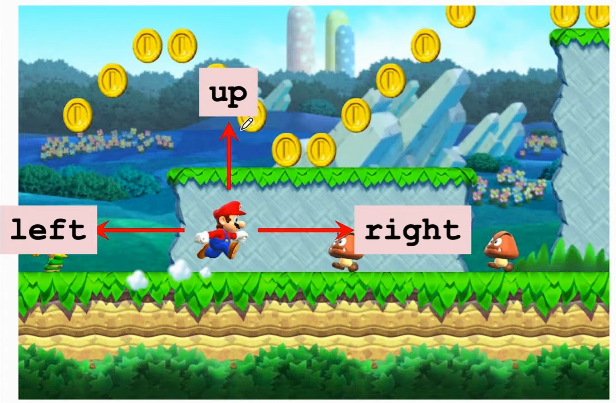
Fig. 1. Policy函数举例,马里奥可以上左右移动。 (Image source: Shusen Wang YouTube, 2019)
Agent 与环境交互
马里奥就是 Agent,环境就是游戏界面,马里奥根据环境来做决策,然后到下一个状态。吃到金币给奖励,赢了游戏给大奖励,与之对应,输了游戏给大惩罚。
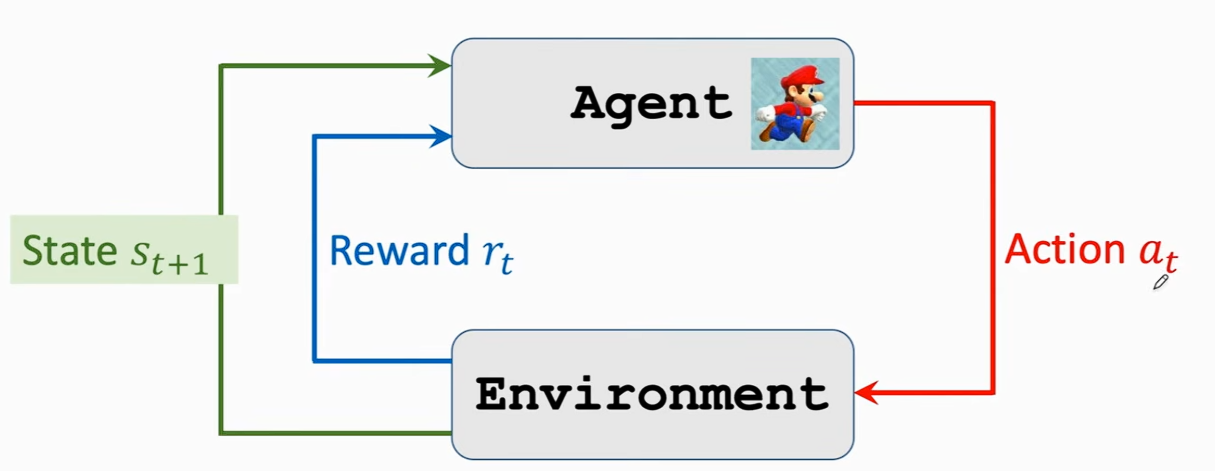
Fig. 2. Agent和环境交互例子。 (Image source: Shusen Wang YouTube, 2019)
RL 中的随机性
动作随机性:给定状态 $s$ ,Agent的状态可能是随机的,比如
- $\pi(\text{"left"} \mid s) = 0.2$,
- $\pi(\text{"right"} \mid s) = 0.1$,
- $\pi(\text{"up"} \mid s) = 0.7$.
状态随机性:给定状态 $S = s,A = a$ ,$S\rightarrow S'$ 环境转移是随机的,系统会随机抽样到下一个状态
- $S' = P(\cdot \mid s,a)$
RL 过程
- 游戏界面 (state $s_1$)
- 根据 $\pi$ 做出 (action $a_1$)
- 得到一个新的游戏界面 (state $s_2$) 和 reward $r_1$
- 根据 $\pi$ 做出 (action $a_2$)
- ….
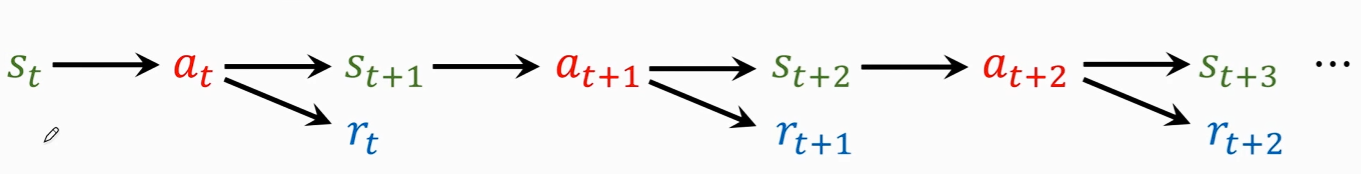
Fig. 3. RL 轨迹链路示意。 (Image source: Shusen Wang YouTube, 2019)
(state,action,reward)轨迹:
$$s_1,a_1,r_1,s_2,a_2,r_2,\dots,s_T,a_T,r_T$$Return & Reward
Return 回报,把t时刻以后的奖励加起来:
- $U_t = R_t+R_{t+1}+R_{t+2}+\dots$
eg, $R_t$ 和 $R_{t+1}$ 同样重要吗?
- 下面哪个你最想要?
- 立刻给你 80
- 一年后给你 100
很明显,肯定是现在 80 最好,一年后的 100 块不如现在的 80。所有 $R_{t+1}$ 不如当前的 $R{t}$ 重要 ,一般要给 $R_{t+1}$ 打个折扣,比如八折。
Discounted Return 折扣回报率。
- $\gamma \in [0,1]$,折扣率 (hyper-parameter)
- $U_t=R_t+\gamma R_{t+1} + \gamma ^2 R_{t+2} + \gamma ^3 R_{t+3}+\dots$
在 $t$ 步,回报 $U_t$ 是随机的。
- 随机性来源两方面:
- action 是随机的,$\mathbb{P}(A = a \mid S = s) = \pi(a \mid s)$
- state 是随机的,$\mathbb{P}(S' = s' \mid S = s,A = a ) = \pi(s' \mid s,a)$
- 对于 $i \ge t$,reward $R_i$ 取决于 $S_i$ 和 $A_i$。
- 因此,给定 $s_t$,回报率 $U_t$ 依赖于这两个随机变量 $A_t,A_{t+1},A_{t+2},\dots$ and $S_{t+1},S_{t+2},\dots$ $$A,S \rightarrow R \rightarrow U$$
价值函数
折扣回报 $U_t = R_t+\gamma R_{t+1} + \gamma ^2 R_{t+2} + \gamma ^3 R_{t+3}+\dots$,是一个随机变量,在 $t$ 时刻并不知道具体是什么,那如何评估呢?可以对 $U_t$ 求期望,这样就可以消除随机变量。
$Q_\pi(s,a)$,动作价值函数
$$Q_\pi(s_t,a_t) = \mathbb{E}[U_t \mid S_t = s_t,A_t = a_t]$$动作价值函数 $Q_\pi(s,a)$ 的直观意义就是,用 Policy 函数 $\pi$ 在 $s_t$ 做出动作 $a_t$ 是好还是坏。 已知 Policy 函数 $\pi$,$Q_\pi(s,a)$ 就会给当前状态下,所有动作 $a$ 打分,这样就可以知道动作的好坏。
$Q^\star(s_t,a_t)$,最大化动作价值函数
$$Q^\star(s_t, a_t) = \max_\pi Q_\pi(s_t, a_t).$$$Q^\star$ 直接根据 $s_t$ 对 $a_t$ 做评价,比如玩超级玛丽的时候,马里奥当前向上走“好不好”、“胜算有多大”。有了 $Q^\star$ 之后,Agent就可以根据 $Q^\star$ 对动作的评价来做决策,比如 $Q^\star$ 认为往上跳分数最高,Agent就会往上跳。
假如我们在 $Q_\pi(s_t,a_t)$ 不对 $\pi$ 求期望,而是对 $A$ 求期望呢?对 $A$ 求期望就可以把 $A$ 消除掉,是不是就可以得到环境的评估函数?
$V(s)$,状态价值函数
$$V_\pi(s_t) = \mathbb{E}_A[Q_\pi(s_t,A)] = \sum_{a} \pi(a \mid s_t) \cdot Q_\pi(s_t, a)$$$V_\pi(s)_t$ 的直观意义就是能够得到局势信息,根据游戏界面,我们就可以知道当前局势是不是“有利”的,是快赢了还是快输了,用于评估状态。
当然我们还可以在 $V_\pi(s)_t$ 对 $s$ 求期望得到 $\mathbb{E}_S[V\pi{S}]$,可以评估 $\pi$ 的好坏。
How does AI control the agent?
假设我们有一个好的 Policy 函数 $\pi(a \mid s)$。
- 观测 State $s_t$,
- 随机采样得到动作:$a_t \sim \pi(a \mid s_t)$
假设我们知道最优动作价值函数 $Q^\star(s_t, a_t)$
- 观测 State $s_t$,
- 根据 $Q^\star(s_t, a_t)$ 选择最好的 $a_t$:$a_t = \text{argmax}_{a}Q^\star(s_t, a_t)$
所有 RL 的目的就是学习这两个函数,有了这两个函数之一,我们就可以让 Agent 对 $s_t$ 来做出决策 $a_t$。
价值学习,Value-Based RL
Deep Q-Network
强化学习的目标:赢下游戏(最大化 reward)。
如果我们知道 $Q^\star(s, a)$, 很明显最好的 action 就是 $a\star = \text{argmax}_{a}Q^\star(s, a)$,
这样我们就可以利用 $Q^\star(s, a)$ 来做决策,虽然在某一时刻不一定 是最好的,但也代表了一个趋势。它不一定追求“即时奖励最大”,而是追求“长远累积回报最大”。
但是问题是,我们不知道 $Q^\star(s, a)$ 是什么。 谁也不是先知,很难预测股票市场的 $Q^\star(s, a)$,但是对于超级玛丽,Agent 玩了几百万场次后也和先知没有区别了。用自己学习到的经验近似先知($Q^\star(s, a)$)。
DQN 就是用神经网络来近似 $Q^\star(s, a)$,
$$Q(s, a;w) \approx Q^\star(s, a)$$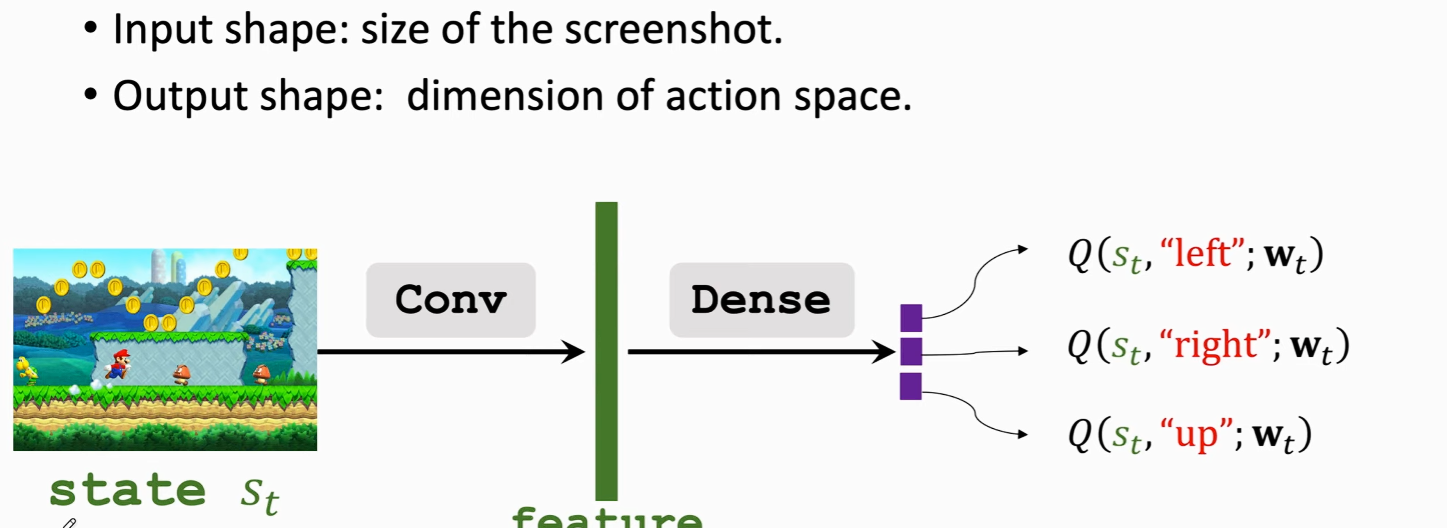
Fig. 4. DQN的输入在不同任务下可能不同,对于超级玛丽来说,游戏画面就是输入,用卷积层将输入变成向量,全连接层映射到输出向量(score action)。 (Image source: Shusen Wang YouTube, 2019)
DQN的输入在不同任务下可能不同,对于超级玛丽来说,游戏画面就是输入,输出就是移动的打分。
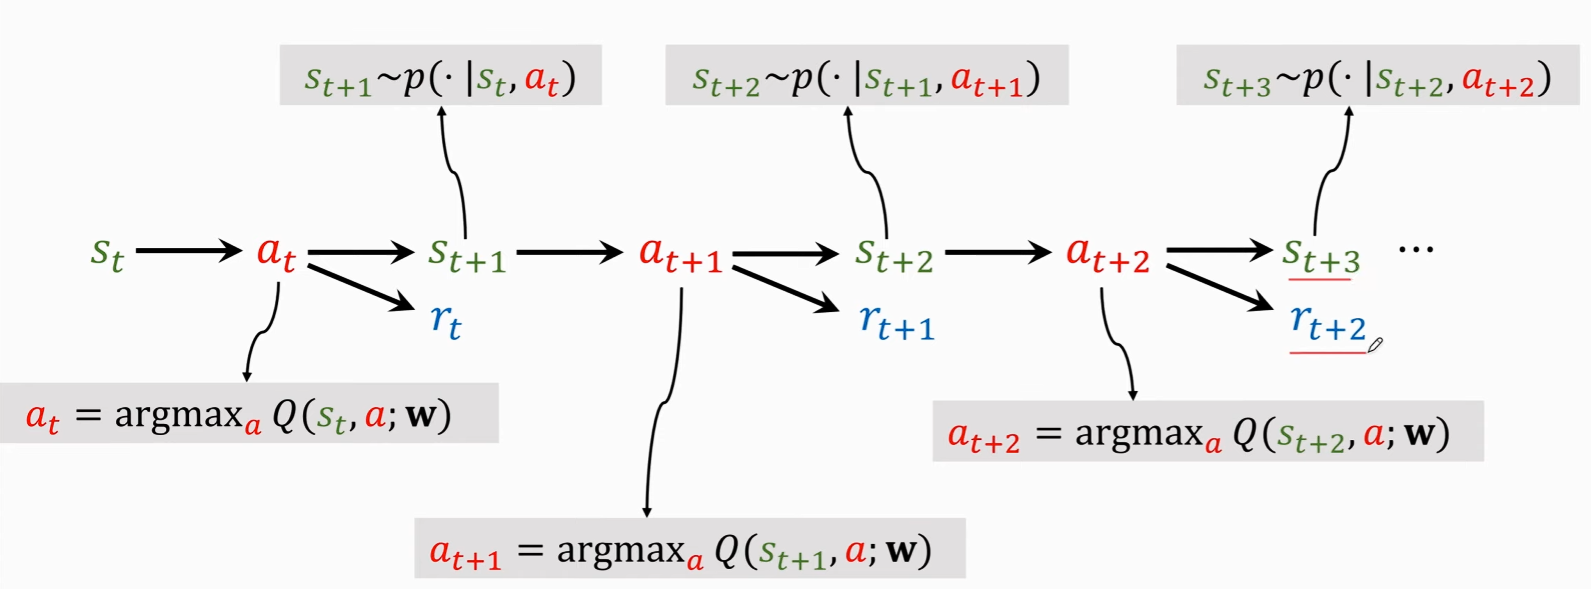
Fig. 5. 将 DQN 应用在游戏里。 (Image source: Shusen Wang YouTube, 2019)
- 将 DQN 应用在游戏里
- 观测到游戏画面内容 $s_t$
- 根据 $a_t = argmax_aQ(s_t, a;w)$ 做出这一步的决策
- 得到奖励 $r_t$,状态转移 $s_{t+1} \sim p(\cdot \mid s_t, a_t)$
- …
Temporal Difference (TD) Learning
驾车从成都到西安需要的时间
模型可能估计要 10 个小时,这个值可能不是准确的,甚至完全偏移。不难想到如果非常多的人用了这个模型,用数据去更新模型,从而让模型更准确。
问题就是 如何更新模型
- 出发前让模型做一个预测: $q = Q(w)$,e.g., $q=10$。
- 实际上我从成都到西安,驾车只需要两个小时,这个两小时就是真实值 $y$,$y=2$。
- $\mathcal{loss}= L = \frac{1}{2}(q-y)^2$,记录损失
- 让模型对 $L$ 在 $w$ 求偏导 $\frac{\partial L}{\partial \mathbf{w}} = \frac{\partial q}{\partial \mathbf{w}} \cdot \frac{\partial L}{\partial q} = (q - y) \cdot \frac{\partial Q(\mathbf{w})}{\partial \mathbf{w}}$
- 用梯度下降更新模型参数 $\mathbf{w}_{t+1} = \mathbf{w}_t - \alpha \cdot \left. \frac{\partial L}{\partial \mathbf{w}} \right|_{\mathbf{w}=\mathbf{w}_t}$
这样的话问题又开了,我们必须完成整个旅途才能更新模型。能不能在中途或者出发前更新呢?
能不能在成都->西安中途去更新模型呢,比如到达汉中的时候就去更新模型,有的兄弟有的,TD 算法就是来解决这个问题的。
- 模型预测 $q=10$,但实际上 6个小时(actual) 就到汉中了
- 模型这个时候更新权重,并且预测 汉中->西安 2个小时(estimate)
- 更新估计值 $6 + 2 = 8$,这个 8小时 就是 TD Target
- 预测值 8个小时比 10个小时 更可靠,因为有了真实观测值介入
所以,TD 更新权重的方法是,
- TD Target $y = 8$
- $L=\frac{1}{2}(Q(W)-y)^2$,$Q(W)-y$ 称为 TD error $\delta$
- $\frac{\partial L}{\partial \mathbf{w}} = \frac{\partial q}{\partial \mathbf{w}} \cdot \frac{\partial L}{\partial q} = (10-8) \cdot \frac{\partial Q(\mathbf{w})}{\partial \mathbf{w}}$
- 用梯度下降更新模型参数 $\mathbf{w}_{t+1} = \mathbf{w}_t - \alpha \cdot \left. \frac{\partial L}{\partial \mathbf{w}} \right|_{\mathbf{w}=\mathbf{w}_t}$
TD Learning for DQN
在 成都->西安,我们有这个表达式:
$$T_{CD->XI'AN} \approx T_{CD->HZ} + T_{HZ->XI'AN}$$其中,$T_{CD->XI'AN}$ 模型总预测,$T_{CD->HZ}$ 实际时间,$T_{HZ->XI'AN}$ 模型估计。
在深度RL中:
$$Q(s_t,a_t;\mathbf{w})\approx r_t+\gamma \cdot Q(s_{t+1},a_{t+1};\mathbf{w})$$其中,$r_t$ t时刻真实的奖励,相当于 $T_{CD->HZ}$ 实际时间,$\gamma \cdot Q(s_{t+1},a_{t+1};\mathbf{w})$ 是 DQN 在$t+1$时刻做的估计。 为什么 RL 有这种公式呢?
回顾一下折扣回报,
$$ \begin{aligned} U_t &= R_t + \gamma R_{t+1} + \gamma ^2 R_{t+2} + \gamma ^3 R_{t+3} + \dots \\ &= R_t + \gamma \cdot(R_{t+1} + \gamma R_{t+2} + \gamma ^2 R_{t+3} + \dots) \\ &= R_t + \gamma \cdot U_{t+1} \end{aligned} $$将 TD 应用到 DQN:
DQN 的输出,$Q(s_t,a_t;\mathbf{w})$,是 $\mathbb{E}[U_t]$
DQN 的输出,$Q(s_{t+1},a_{t+1};\mathbf{w})$,是 $\mathbb{E}[U_{t+1} ]$
由 $U_t = R_t + \gamma \cdot U_{t+1}$ 得到,$Q(s_t,a_t;\mathbf{w}) \approx \mathbb{E}[R_t + \gamma\cdot Q(s_{t+1},a_{t+1};\mathbf{w})]$
有了预测值 $Q(s_t,a_t;\mathbf{w_t})$
TD Target:
$$ \begin{aligned} y_t &= r_t + \gamma \cdot Q(s_{t+1}, a_{t+1}; \mathbf{w}_t) \\ &= r_t + \gamma \cdot \max_{a} Q(s_{t+1}, a; \mathbf{w}_t). \end{aligned} $$Loss: $L_t = \frac{1}{2} [Q(s_t, a_t; \mathbf{w}) - y_t]^2$
Gradient descent: $\mathbf{w}_{t+1} = \mathbf{w}_t - \alpha \cdot \left. \frac{\partial L_t}{\partial \mathbf{w}} \right|_{\mathbf{w}=\mathbf{w}_t}$
策略学习,Policy-Based RL
回顾一下,前面提到 Policy function $\pi (s \mid a) \in [0, 1]$,就是一个 PDF 。 输入是 $s$ ,输出是所有动作的概率,如
$$ \begin{aligned} \pi(\text{left} \mid s) &= 0.2, \\ \pi(\text{right} \mid s) &= 0.1, \\ \pi(\text{up} \mid s) &= 0.7. \end{aligned} $$有了这些概率值,Agent 就会做一次随机抽样来做出动作 $a$ 。
对于超级玛丽这种问题,状态 $s$ 有无数个,我们无法像棋类游戏或者其他简单游戏一样列举出每种情况,因此我们也需要一个参数来近似学习 Policy Function。
Policy network,策略网络: 用神经网络来近似 $\pi(a \mid s)$
- 用 Policy network $\pi(a\mid s;\mathbf{\theta})$ 来近似 $\pi(a\mid s)$
- $\sum_{a \in \mathcal{A}} \pi(a|s; \boldsymbol{\theta}) = 1.$
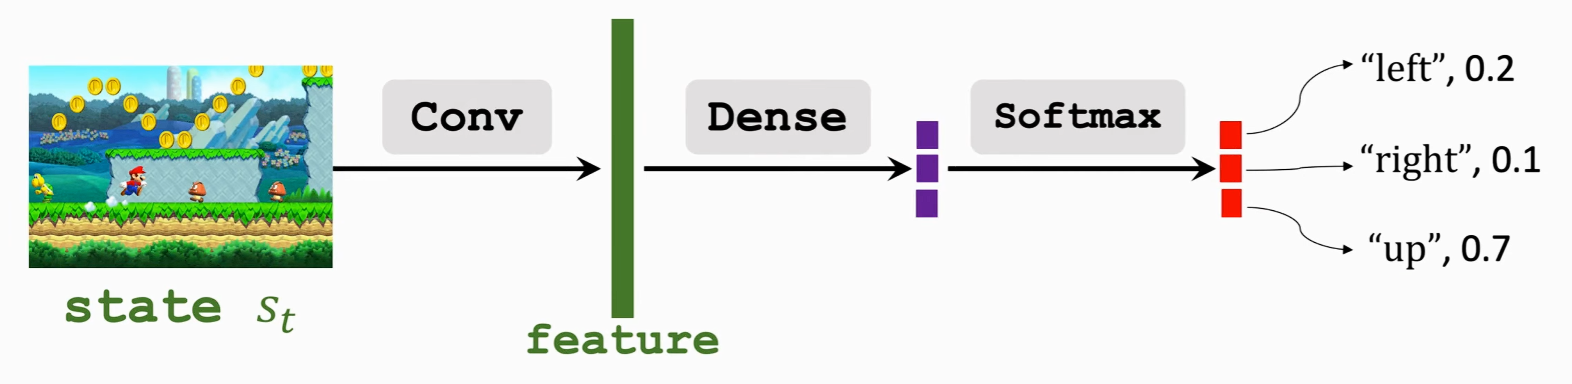
Fig. 6. 策略网络。 (Image source: Shusen Wang YouTube, 2019)
开始之前先回顾一下,折扣回报,
- 随机性来自于未来所有的 $A_t,A_{t+1},A_{t+2}$ 和 $S_{t+1},S{t+2}$ $$U_t = R_t+\gamma R_{t+1} + \gamma ^2 R_{t+2} + \gamma ^3 R_{t+3}+\dots$$
动作价值函数,
$$Q_\pi(s_t,a_t) = \mathbb{E}[U_t \mid S_t = s_t,A_t = a_t]$$状态价值函数,
- 在 $Q_\pi(s_t,a_t)$ 基础上,把 $A$ 消去,只和 $\pi,s_t$ 有关系 $$V_\pi(s_t) = \mathbb{E}_A[Q_\pi(s_t,A)] = \sum_{a} \pi(a \mid s_t) \cdot Q_\pi(s_t, a)$$
State-Value Function $V(s)$ Approximation
可以像近似 $Q\star$ 那样用神经网络来近似 $\pi(a \mid s_t;\mathbf{\theta}) \sim \pi(a\mid s_t)$,
从而可以通过 $\pi(a \mid s_t;\mathbf{\theta})$ 估计 $V_\pi(s_t)$:
$$V(s_t;\mathbf{\theta})=\sum_{a} \pi(a \mid s_t;\mathbf{\theta}) \cdot Q_\pi(s_t,a)$$可以用状态价值函数来评价状态下策略网络 $\pi$ 的好坏,网络越好 $V(s_t;\mathbf{\theta})$ 越大
那如何让策略网络 $\pi$ 越来越好呢?当然,可以通过调整 $\mathbf{\theta}$ 来实现,基于这个想法,目标函数就可以定义为:
$$J(\mathbf{\theta}) = \mathbb{E}_S[V(S;\mathbf{\theta})]$$参数更新方式也类似:
- 观测状态 $s$
- 更新权重 $\mathbf{\theta} \leftarrow \mathbf{\theta} + \beta \cdot \frac{\partial V(s;\mathbf{\theta})}{\partial \mathbf{\theta}}$
Policy Gradient 策略梯度
近似状态价值函数:
- $V(s_t;\mathbf{\theta})=\sum_{a} \pi(a \mid s_t;\mathbf{\theta}) \cdot Q_\pi(s_t,a)$
现在来推导一下 Policy Gradient 策略梯度 $V(s;\mathbf{\theta})$:
- 注意为了方便理解,这里假设 $Q_{\pi}(s,a)$ 与 $\mathbf{\theta}$ 无关,但事实上 $\pi(a\mid s;\mathbf{\theta})$ 依赖于 $\mathbf{\theta}$ $$ \begin{aligned} \frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} &= \frac{\partial \sum_{a} \pi(a|s; \boldsymbol{\theta}) \cdot Q_{\pi}(s,a)}{\partial \boldsymbol{\theta}} \\ &= \sum_{a} \frac{\partial \pi(a|s; \boldsymbol{\theta}) \cdot Q_{\pi}(s,a)}{\partial \boldsymbol{\theta}} \\ &= \sum_{a} \frac{\partial \pi(a|s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s,a) \\ &= \sum_{a} \pi(a \mid s; \boldsymbol{\theta}) \cdot \frac{\partial \log \pi(a \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s, a)\\ &= \mathbb{E}_{A} \left[ \frac{\partial \log \pi(A \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s, A) \right] \end{aligned} $$
至此,我们已经推导出了策略梯度 Policy Gradient,两种形式:
- $\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} = \sum_{a} \frac{\partial \pi(a|s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s,a)$
- $\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} = \mathbb{E}_{A\sim \pi({\cdot \mid s;\mathbf{\theta}})} \left[ \frac{\partial \log \pi(A \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s, A) \right]$
如果动作 $a$ 是离散的,动作空间 $\mathcal{A} = {"\text{left}","\text{right}","\text{up}"}$,用 1 形式:
- 为 $a \in \mathcal{A}$ 计算 $\mathbf{f}(a, \boldsymbol{\theta}) = \frac{\partial \pi(a \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_{\pi}(s, a)$
- Policy Gradient:$\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} = \mathbf{f}(\text{``left''}, \boldsymbol{\theta}) + \mathbf{f}(\text{``right''}, \boldsymbol{\theta}) + \mathbf{f}(\text{``up''}, \boldsymbol{\theta})$
如果动作 $a$ 是连续的,动作空间 $\mathcal{A} = [0,1]$,用 2 形式,但是 $\pi(\cdot \mid s; \boldsymbol{\theta})$ 是个神经网络,无法对其进行定积分,所以用蒙特卡洛近似 (Monte Carlo):
- 根据 PDF $\pi(\cdot|s;\boldsymbol{\theta})$ 随机抽样一个动作 $\hat{a}$
- 计算 $\mathbf{g}(\hat{a}, \mathbf{\theta}) = \boxed{\frac{\partial \log \pi(\hat{a}|s;\mathbf{\theta})}{\partial \mathbf{\theta}} \cdot Q_{\pi}(s, \hat{a})}$
- $\mathbb{E}_{A}\left[\mathbf{g}(A,\mathbf{\theta})\right] = \frac{\partial V(s;\mathbf{\theta})}{\partial \mathbf{\theta}}$
- 由于是根据 PDF 随机抽样的,所以 $\mathbf{g}(\hat{a}, \mathbf{\theta})$ 是 $\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}}$ 的无偏估计
- 蒙特卡洛近似:由于 $\mathbf{g}(\hat{a}, \mathbf{\theta})$ 是 $\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}}$ 的无偏估计,所有可以用 $\mathbf{g}(\hat{a}, \mathbf{\theta})$ 近似策略梯度 $\frac{\partial V(s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}}$ (随机样本近似期望)
更新策略网络
- 观察状态 $s_t$
- 根据 $\pi\left(\cdot \mid s_t ; \boldsymbol{\theta}_t\right)$ 随机采样动作 $a_t$
- 计算 $q_t \approx Q_\pi(s_t, a_t)$
- REINFORE
- 完整走完一局交互,生成完整轨迹: $s_1,a_1,r_1,\; s_2,a_2,r_2,\;\dots\;, s_T,a_T,r_T$
- 对每个时刻t,计算折扣回报: $u_t = \sum_{k=t}^{T} \gamma^{k-t} r_k$
- 由于动作价值函数满足 $Q_\pi(s_t,a_t) = \mathbb{E}\left[U_t\right]$,因此可以用单条轨迹的实际回报 $u_t=$ 近似 $Q_\pi(s_t,a_t)$。
- 于是令近似 $Q$ 值:$q_t = u_t$
- actor-critic:神经网络近似,有一个神经网络近似 $\pi$ 现在用另一个近似 $Q$
- REINFORE
- 对策略网络求导: $\mathbf{d}_{\boldsymbol{\theta},t} = \left. \frac{\partial \log \pi(a_t|s_t,\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \right|_{\boldsymbol{\theta}=\boldsymbol{\theta}_t}$
- 近似策略梯度 $g(a_t, \boldsymbol{\theta}_t) = q_t \cdot \mathbf{d}_{\boldsymbol{\theta},t}$
- 更新策略网络 $\boldsymbol{\theta}_{t+1} = \boldsymbol{\theta}_t + \beta \cdot \mathbf{g}(a_t, \boldsymbol{\theta}_t)$
Actor-Critic Method
actor 是策略网络用来控制 Agent 运动,critic 是策略网络用来给动作打分。
现在要做的就是怎么设计这两个神经网络,然后通过环境奖励更新学习网络。
前面两节分别讲了价值学习和策略学习,Actor-Critic 就是把这两种方法结合起来。 Fig. 7. Actor-Critic 方法,价值学习 & 策略学习 (Image source: Shusen Wang YouTube, 2019)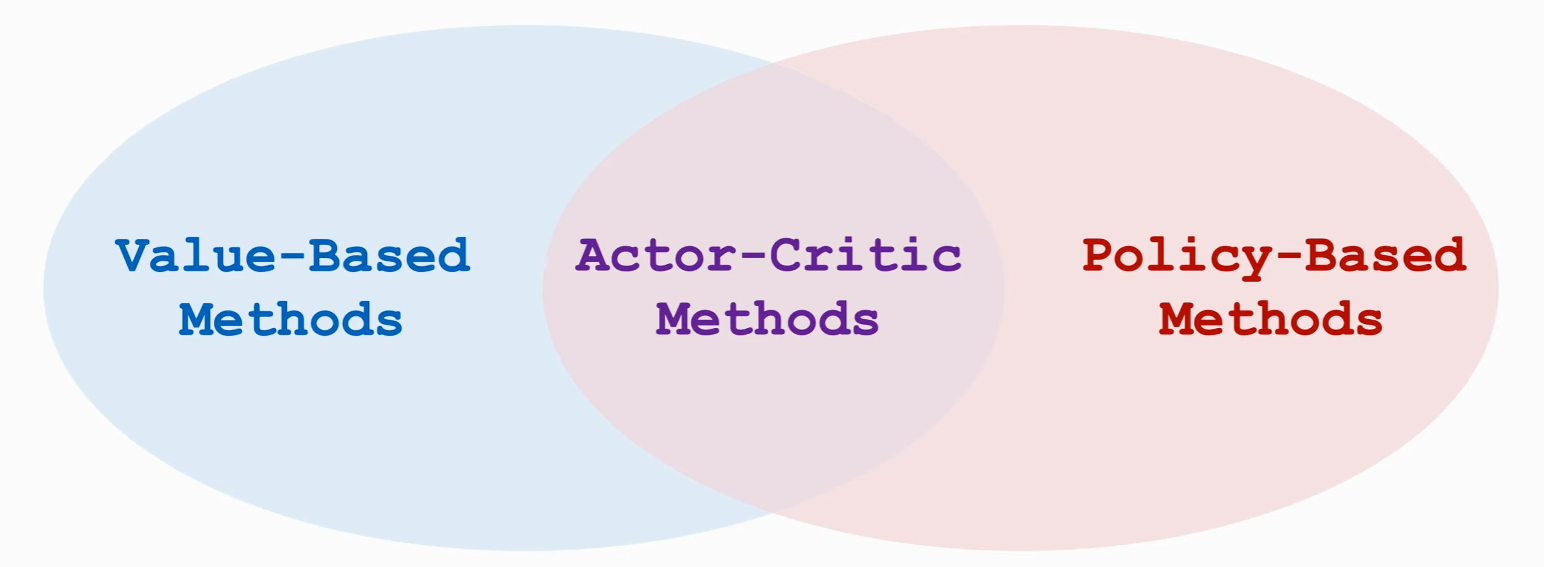
Policy network (actor): 用神经网络 $\pi(a|s; \boldsymbol{\theta})$ 近似 $\pi(a|s)$
- 输入:状态 $s$,例如超级马里奥游戏的画面截图。
- 输出:所有动作上的概率分布。
- 设 $\mathcal{A}$ 为全部动作的集合,例:$\mathcal{A} = \{\text{``左移''}, \text{``右移''}, \text{``上跳''}\}$。
- $\sum_{a \in \mathcal{A}} \pi(a|s, \boldsymbol{\theta}) = 1$。
Fig. 8. 策略网络。 (Image source: Shusen Wang YouTube, 2019)
Value network (critic): 用神经网络 $q(s, a; \mathbf{w})$ 近似 $Q_\pi(s, a)$
- 输入:状态 $s$ 与动作 $a$。
- 输出:近似动作价值(标量)。
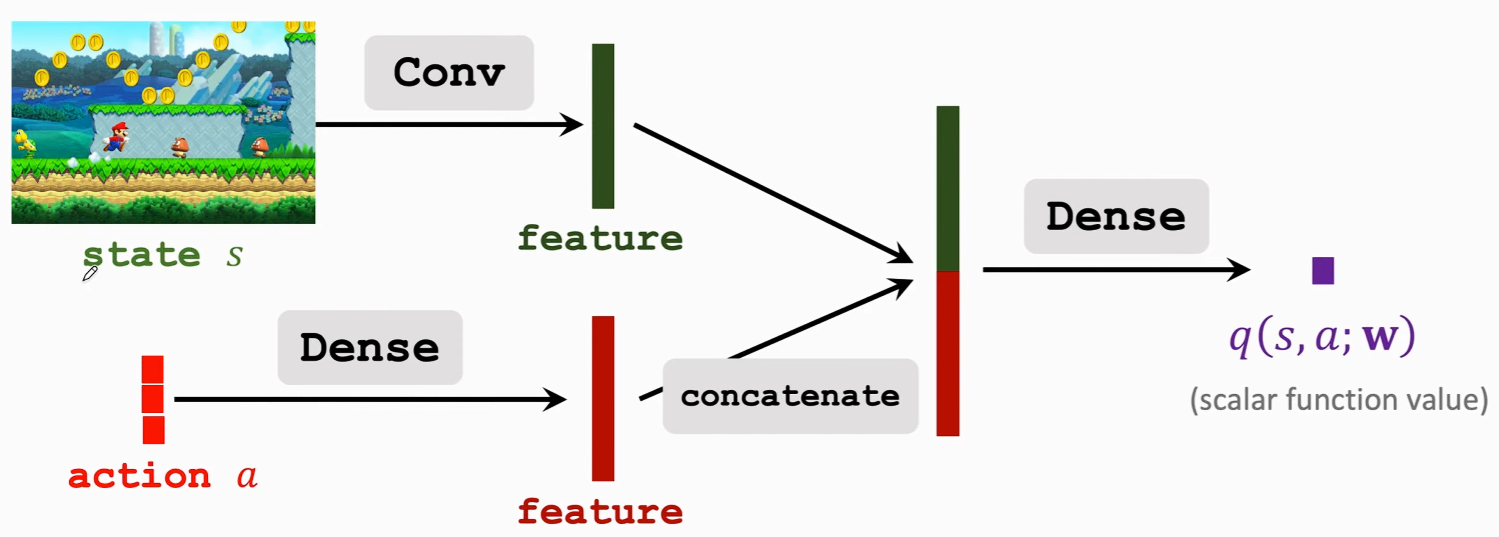
Fig. 9. 价值网络。 (Image source: Shusen Wang YouTube, 2019)
State-value function $V_\pi(s) = \sum_a \boxed{\pi(a|s)} \cdot \boxed{Q_\pi(s,a)} \approx \sum_a \boxed{\pi(a|s; \boldsymbol{\theta})} \cdot \boxed{q(s,a; \mathbf{w})}$ ,训练要更新两个参数 $\boldsymbol{\theta}$ 和 $\mathbf{w}$,而且参数的目的是不同的
- 更新策略网络 $\pi(a|s; \boldsymbol{\theta})$ 来增大状态价值函数 $V_\pi(s;\mathbf{\theta},\mathbf{w})$,同一 $s$ 下 $V$ 越大策略网络越好。且是由价值网络(critic)监督的,cirtic 会给 $\pi(a|s; \boldsymbol{\theta})$ “打分”(监督信号)。
- 更新价值网络 $q(s,a; \mathbf{w})$ 是为了让打分更准确,更好估计未来奖励总和。
$V_\pi(s;\mathbf{\theta},\mathbf{w}) = \sum_a \boxed{\pi(a|s; \boldsymbol{\theta})} \cdot \boxed{q(s,a; \mathbf{w})}$,更新 $\mathbf{\theta}$ 和 $\mathbf{w}$
- 观察到状态 $s$
- 从 $\pi(\cdot|s_t; \boldsymbol{\theta_t})$ 随机抽样 $a_t$
- Agent 执行动作 $a_t$ ,环境更新状态 $s_{t+1}$ 和奖励 $r_t$
- 从 $\pi(\cdot|s_{t+1}; \boldsymbol{\theta_t})$ 随机抽样 $\tilde{a}_{t+1}$ (不执行,只为了估计下一个 $q$)
- 用 TD 更新价值网络 $\mathbf{w}$
- 用价值网络估计 $q_t = q(s_t,a_t;\mathbf{w}_t)$ 和 $q_{t+1} = q(s_{t+1},\tilde{a}_{t+1};\mathbf{w}_t)$
- TD Target:$y_t = r_t + \gamma \cdot q_{t+1}$
- TD 误差:$\delta_t = q_t - y_t$
- 价值网络梯度:$\mathbf{d}_{w,t} = \left.\frac{\partial q(s_t,a_t;\mathbf{w})}{\partial \mathbf{w}}\right|_{\mathbf{w}=\mathbf{w}_t}$
- 梯度下降更新:$\mathbf{w}_{t+1} = \mathbf{w}_t - \alpha \cdot \delta_t \cdot \mathbf{d}_{w,t}$
- 用策略梯度算法更新策略网络 $\boldsymbol{\theta}$
- 策略梯度导数项:$\mathbf{d}_{\theta,t} = \left.\frac{\partial \log \pi(a_t|s_t,\boldsymbol{\theta})}{\partial \boldsymbol{\theta}}\right|_{\boldsymbol{\theta}=\boldsymbol{\theta}_t}$
- 价值函数梯度的蒙特卡洛近似:$\frac{\partial V(s_t;\boldsymbol{\theta}_t,\mathbf{w}_t)}{\partial \boldsymbol{\theta}}= \mathbb{E}_{A}\big[\delta_t \cdot \mathbf{d}_{\theta,t}\big]$
- 梯度上升更新(Baseline):$\boldsymbol{\theta}_{t+1} = \boldsymbol{\theta}_t + \beta \cdot \delta_t \cdot \mathbf{d}_{\theta,t}$
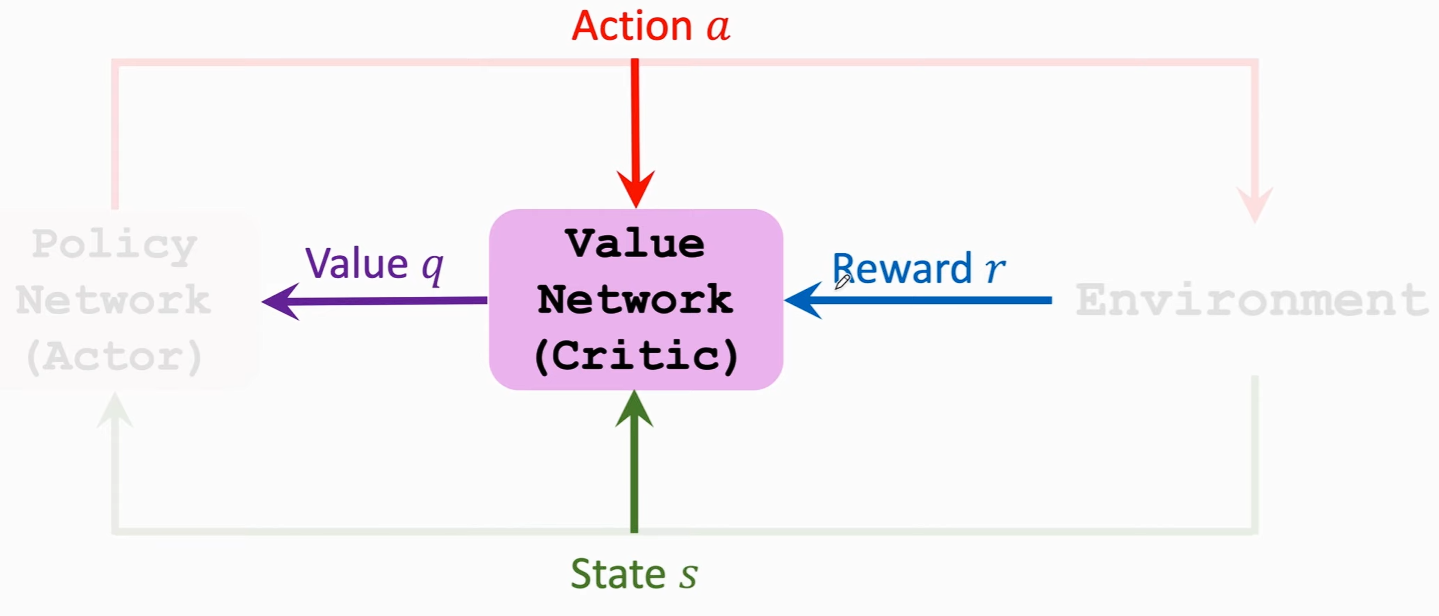
Fig. 10. actor-critic的互相作用。 (Image source: Shusen Wang YouTube, 2019)