策略梯度
回顾一下,使用策略网络 $\pi(a|s; \boldsymbol{\theta})$ 来控制 Agent。
状态价值函数
$$ \begin{aligned} V_\pi(s) &= \mathbb{E}_{A \sim \pi}\big[Q_\pi(s, A)\big] \\ &= \sum_a \pi(a|s; \boldsymbol{\theta}) \cdot Q_\pi(s, a) \end{aligned} $$策略梯度
$$ \frac{\partial V_\pi(s)}{\partial \boldsymbol{\theta}} = \mathbb{E}_{A \sim \pi}\left[ \frac{\partial \ln \pi(A | s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \underline{Q_\pi(s, A)} \right] $$Baseline
在策略梯度强化学习中,baseline $b(s)$ 是一个仅由当前状态 $s$ 决定、和采样动作 $A$ 无关的标量值。Baseline 的核心就是降低梯度方差,避免参数更新抖动,加快训练收敛。baseline 有以下性质:
- 仅依赖状态,与动作无关 $\mathbb{E}_{A \sim \pi}\left[ b \cdot \frac{\partial \ln \pi(A \mid s;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \right] = 0$
可以看出 baseline 具有无偏性,不改变梯度真实期望,原始策略梯度与引入 baseline 的梯度,
$$ \begin{aligned} \frac{\partial V_\pi(s)}{\partial \boldsymbol{\theta}} &= \mathbb{E}_{A \sim \pi}\left[ \frac{\partial \ln \pi(A \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot Q_\pi(s,A) \right] - \mathbb{E}_{A \sim \pi}\left[ \frac{\partial \ln \pi(A \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot b \right] \\ &= \mathbb{E}_{A \sim \pi}\left[ \frac{\partial \ln \pi(A \mid s; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(Q_\pi(s,A) - b\big) \right] \end{aligned} $$Theorem. 如果 $b$ 不依赖 $A_t$, 策略梯度可以写成:
$$ >\frac{\partial V_\pi(s_t)}{\partial \boldsymbol{\theta}} = \mathbb{E}_{A_t \sim \pi}\left[ \frac{\partial \ln \pi(A_t \mid s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(Q_\pi(s_t, A_t) - b\big) \right].$$
Monte Carlo Approximation
策略梯度期望公式
$$ \frac{\partial V_\pi(s_t)}{\partial \boldsymbol{\theta}} = \mathbb{E}_{A_t \sim \pi}\left[ \frac{\partial \ln \pi(A_t \mid s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(Q_\pi(s_t, A_t) - b\big) \right] $$- 从策略分布 $\pi(\cdot \mid s_t; \boldsymbol{\theta})$ 中随机采样动作 $a_t$,计算样本梯度 $\boldsymbol{g}(a_t)$。
- $\boldsymbol{g}(a_t)$ 是策略梯度的无偏估计: $$ \mathbb{E}_{A_t \sim \pi}\big[\boldsymbol{g}(A_t)\big] = \frac{\partial V_\pi(s_t)}{\partial \boldsymbol{\theta}} $$
随机策略梯度公式(蒙特卡洛近似)
$$ \boldsymbol{g}(a_t) = \frac{\partial \ln \pi(a_t \mid s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(Q_\pi(s_t, a_t) - b\big) $$- 虽然 $b$ 不影响 $\mathbb{E}_{A_t \sim \pi}\big[\boldsymbol{g}(A_t)\big]$ 但显然影响 $\boldsymbol{g}(a_t)$
- 当 $b$ 越接近 $Q_\pi(s_t, A_t)$,$\boldsymbol{g}(a_t)$ 方差越小,收敛越快,baseline有以下常见选择
- $b=0$
- $b=V_\pi(s_t)$,事实上 $V_\pi(s_t)$ 就很接近 $Q_\pi(s_t, A_t)$,因为$V_\pi(s_t) = \mathbb{E}_{A_t}\big[Q_\pi(s_t, A_t)\big]$
随机策略梯度上升
$$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} + \beta \cdot \boldsymbol{g}(a_t) $$REINFORCE with baseline
随机策略梯度,
$$ \mathbf{g}(a_t) = \frac{\partial \ln \pi(a_t|s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(Q_\pi(s_t,a_t) - V_\pi(s_t)\big) $$这个时候,梯度还有两个随机量 $Q_\pi(s_t,a_t)$ 和 $ V_\pi(s_t)$
对于 $Q_\pi(s_t,a_t)$
回顾定义:$Q_\pi(s_t,a_t) = \mathbb{E}\big[U_t \mid s_t,a_t\big]$
蒙特卡洛近似估计 $Q_\pi(s_t,a_t) \approx u_t$(REINFORCE 算法):
- 采集轨迹:$s_t,a_t,r_t,s_{t+1},a_{t+1},r_{t+1},\dots,s_n,a_n,r_n$
- 计算回报:$u_t = \sum_{i=t}^n \gamma^{i-t} \cdot r_i$
- $u_t$ 是 $Q_\pi(s_t,a_t)$ 的无偏估计
对于 $V_\pi(s_t)$
- 用价值网络 $v(s; \mathbf{w})$ 近似状态价值函数 $V(s; \theta)$
最终近似梯度,
$$\frac{\partial V_\pi(s_t)}{\partial \boldsymbol{\theta}} \approx \mathbf{g}(a_t) \approx \frac{\partial \ln \pi(a_t|s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(u_t - v(s_t; \mathbf{w})\big) $$到达最终近似梯度,用了三次近似方式
- 使用单个样本 $a_t$ 近似数学期望(蒙特卡洛近似)
- 使用轨迹折扣回报 $u_t$ 近似状态动作价值 $Q_\pi(s_t,a_t)$(蒙特卡洛近似)
- 使用价值网络 $v(s;\mathbf{w})$ 近似状态价值函数 $V_\pi(s)$
有了上面的推导,紧接着就来搭建神经网络:
- 策略网络,用来控制 Agent。
- 价值网络,起辅助作用,作为 baseline 帮助训练策略网络。用策略网络 $\pi({a\mid s;\mathbf{\theta}})$ 近似策略函数 $\pi(a\mid s)$。 用价值网络 $v(s;\mathbf{w})$ 近似 $V_{\pi}(s)$。 由于 $\pi({a\mid s;\mathbf{\theta}})$ 和 $v(s;\mathbf{w})$ 的输入都是状态 $s$,而且都会用到 Conv ,就可共享 Conv 层,用相同的 Conv 层提取参数。
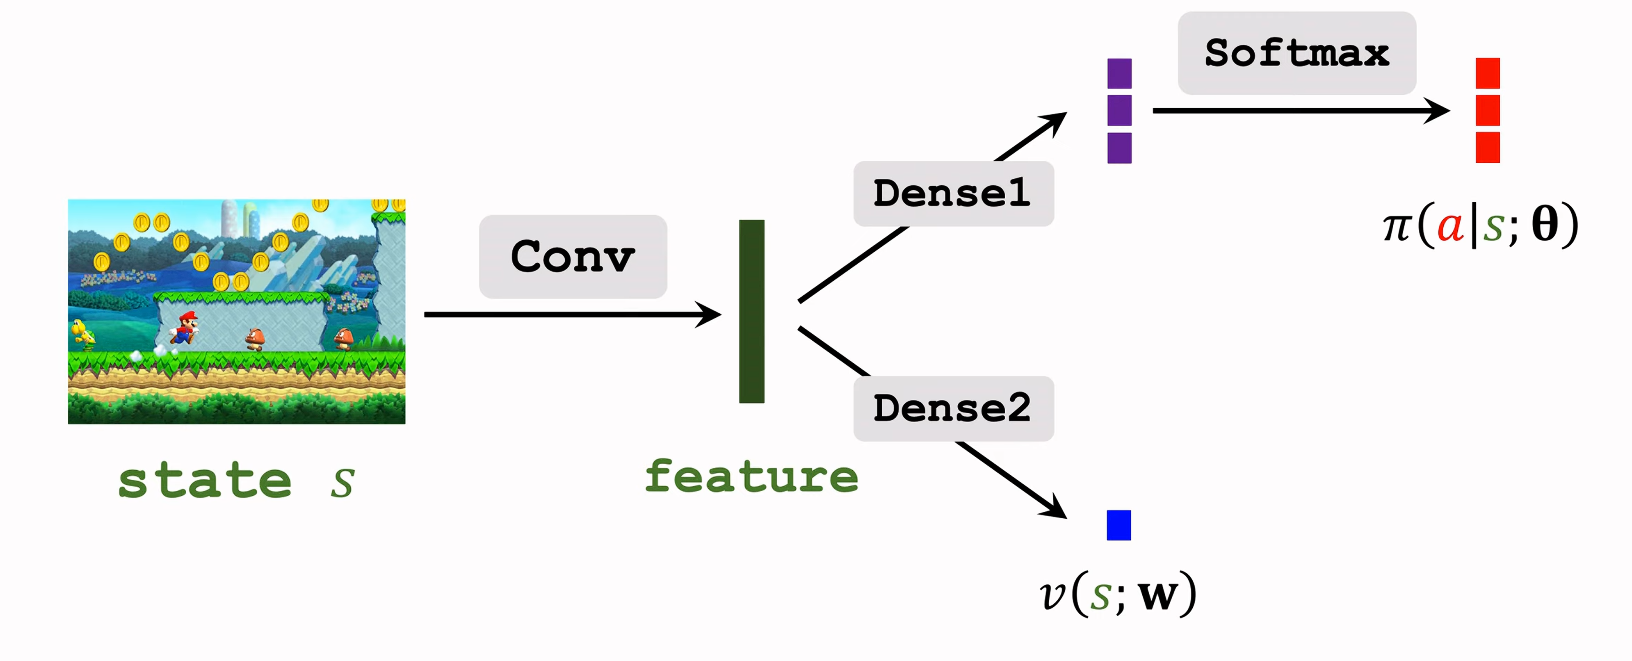
Fig. 1. 参数共享。 (Image source: Shusen Wang YouTube, 2020)
近似策略梯度的参数更新
$$ \frac{\partial V_\pi(s_t)}{\partial \boldsymbol{\theta}} \approx \frac{\partial \ln \pi(a_t|s_t;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(u_t - v(s_t; \mathbf{w})\big) $$- 通过策略梯度上升更新策略网络: $$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} + \beta \cdot \frac{\partial \ln \pi(a_t \mid s_t;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \underbrace{\big(u_t - v(s_t; \mathbf{w})\big)}_{=-\delta_t} $$
价值网络的更新
- 回顾:价值网络 $v(s_t; \mathbf{w})$ 是状态价值 $V_\pi(s_t) = \mathbb{E}[U_t \mid s_t]$ 的近似拟合
- 预测误差: $$ \delta_t = v(s_t; \mathbf{w}) - u_t $$
- 损失梯度(取均方误差损失 $\frac{1}{2}\delta_t^2$): $$ \frac{\partial \left(\delta_t^2 / 2\right)}{\partial \mathbf{w}} = \delta_t \cdot \frac{\partial v(s_t;\mathbf{w})}{\partial \mathbf{w}} $$
- 梯度下降更新价值网络参数: $$ \mathbf{w} \leftarrow \mathbf{w} - \alpha \cdot \delta_t \cdot \frac{\partial v(s_t;\mathbf{w})}{\partial \mathbf{w}} $$
Advantage Actor-Critic (A2C)
这一节将 baseline 与 Actor-Critic 结合。
策略网络(Actor 行动器):$\pi(a \mid s; \boldsymbol{\theta})$
- 是策略函数 $\pi(a \mid s)$ 的近似拟合网络
- 负责智能体的动作决策与行为控制
价值网络(Critic 评价器):$\boldsymbol{v}(s; \mathbf{w})$
之前我们用 $Q_\pi(s,a)$ 作为价值函数,依赖于 $s$ 和 $a$。这里用的是状态价值 $V$ 作为价值函数,不依赖动作 $a$,更易于训练
- 是状态价值函数 $V_\pi(s)$ 的近似拟合网络
- 负责评估当前状态 $s$ 的优劣程度
A2C 的训练过程
- 采集状态转移样本:$(s_t, a_t, r_t, s_{t+1})$
- TD目标值: $$ y_t = r_t + \gamma \cdot v(s_{t+1}; \mathbf{w}) $$
- TD时序差分误差: $$ \delta_t = v(s_t; \mathbf{w}) - y_t $$
- 更新策略网络(Actor): $$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} - \beta \cdot \delta_t \cdot \frac{\partial \ln \pi(a_t \mid s_t; \boldsymbol{\theta})}{\partial \boldsymbol{\theta}} $$
- 更新价值网络(Critic): $$ \mathbf{w} \leftarrow \mathbf{w} - \alpha \cdot \delta_t \cdot \frac{\partial v(s_t;\mathbf{w})}{\partial \mathbf{w}} $$
REINFORCE versus A2C
前面可以看到,REINFORCE with baseline 和 A2C 的形式非常相似。两者都使用策略梯度更新 Actor,并且都引入一个状态价值函数 $v(s;\mathbf{w})$ 作为 baseline 来降低方差。核心区别在于:REINFORCE 使用完整轨迹的 Monte Carlo return,而 A2C 使用一步 TD target。
对于 REINFORCE with baseline,优势函数的估计为:
$$ \hat{A}_t = u_t - v(s_t;\mathbf{w}) $$其中
$$ u_t = \sum_{i=t}^{n} \gamma^{i-t} r_i $$是从时刻 $t$ 开始直到 episode 结束的折扣回报。因此 REINFORCE 需要等一整条轨迹采样完成之后,才能计算 $u_t$ 并更新参数。
Actor 的更新为:
$$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} + \beta \cdot \frac{\partial \ln \pi(a_t \mid s_t;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} \cdot \big(u_t - v(s_t;\mathbf{w})\big) $$如果记
$$ \delta_t = v(s_t;\mathbf{w}) - u_t $$则也可以写成:
$$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta}-\beta\cdot\delta_t\cdot\frac{\partial \ln \pi(a_t \mid s_t;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} $$而在 A2C 中,不再等待完整 episode 结束,而是使用一步 TD target:
$$ y_t = r_t + \gamma v(s_{t+1};\mathbf{w}) $$对应的优势函数估计为:
$$ \hat{A}_t = y_t - v(s_t;\mathbf{w}) = r_t + \gamma v(s_{t+1};\mathbf{w}) - v(s_t;\mathbf{w}) $$如果仍然记
$$ \delta_t = v(s_t;\mathbf{w}) - y_t $$则 Actor 的更新为:
$$ \boldsymbol{\theta}\leftarrow \boldsymbol{\theta}-\beta\cdot\delta_t\cdot\frac{\partial \ln \pi(a_t \mid s_t;\boldsymbol{\theta})}{\partial \boldsymbol{\theta}} $$可以看到,REINFORCE 和 A2C 的 Actor 更新形式几乎一样,区别只在于 $\delta_t$ 的定义不同:
$$ \delta_t^{\text{REINFORCE}}=v(s_t;\mathbf{w}) - u_t $$$$ \delta_t^{\text{A2C}}=v(s_t;\mathbf{w}) -\big(r_t + \gamma v(s_{t+1};\mathbf{w})\big) $$也就是说:
- REINFORCE 用完整回报 $u_t$ 近似 $Q_\pi(s_t,a_t)$。
- A2C 用 TD target $r_t + \gamma v(s_{t+1};\mathbf{w})$ 近似 $Q_\pi(s_t,a_t)$。
- REINFORCE 是 Monte Carlo 方法。
- A2C 是 Temporal Difference 方法。
- REINFORCE 不引入 bootstrap,因此估计偏差较小,但方差较大。
- A2C 引入 bootstrap,因此估计有一定偏差,但方差更小,训练更稳定,样本效率更高。
二者的对比如下:
| 方法 | $Q_\pi(s_t,a_t)$ 的近似 | 是否需要完整轨迹 | 是否 bootstrap | 方差 | 偏差 | 更新频率 |
|---|---|---|---|---|---|---|
| REINFORCE with baseline | $u_t = \sum_{i=t}^{n}\gamma^{i-t}r_i$ | 需要 | 否 | 高 | 低 | episode 结束后 |
| A2C | $r_t + \gamma v(s_{t+1};\mathbf{w})$ | 不需要 | 是 | 低 | 较高 | 每一步或每 $n$ 步 |
直观地说,REINFORCE 会等游戏结束后再总结“这一步到底好不好”;A2C 则在每走一步后就用 Critic 估计未来价值,并立即给 Actor 一个更及时的反馈。因此 A2C 通常比 REINFORCE 收敛更快,也更适合较长 episode 或连续控制任务。