参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)讨论的是一个很现实的问题:当基础模型已经足够大、训练足够贵时,如何只引入很小的任务特定状态,就让同一个模型适配不同任务、领域、用户偏好或输出协议。
如果只从 LoRA 开始看,PEFT 很容易被误解成一种低秩矩阵技巧。但 LoRA 只是 PEFT 谱系中的一类。更完整的视角是看“适配信号被放在哪里”:
- 输入侧适配:改变上下文或输入 embedding,例如 hard prompting、soft prompt、prompt tuning、P-tuning、prefix tuning、P-tuning v2。
- 层内模块适配:冻结主干,在 Transformer 层内部插入小模块,例如 adapter。
- 权重更新适配:不直接更新原权重,而是约束权重更新的形式,例如 LoRA;QLoRA 进一步把冻结基座量化。
这三条线的共同点是:基础模型参数 $\theta_0$ 共享,任务特定参数或状态 $\phi_t$ 很小。差异在于 $\phi_t$ 作用于输入空间、激活空间,还是权重更新空间。
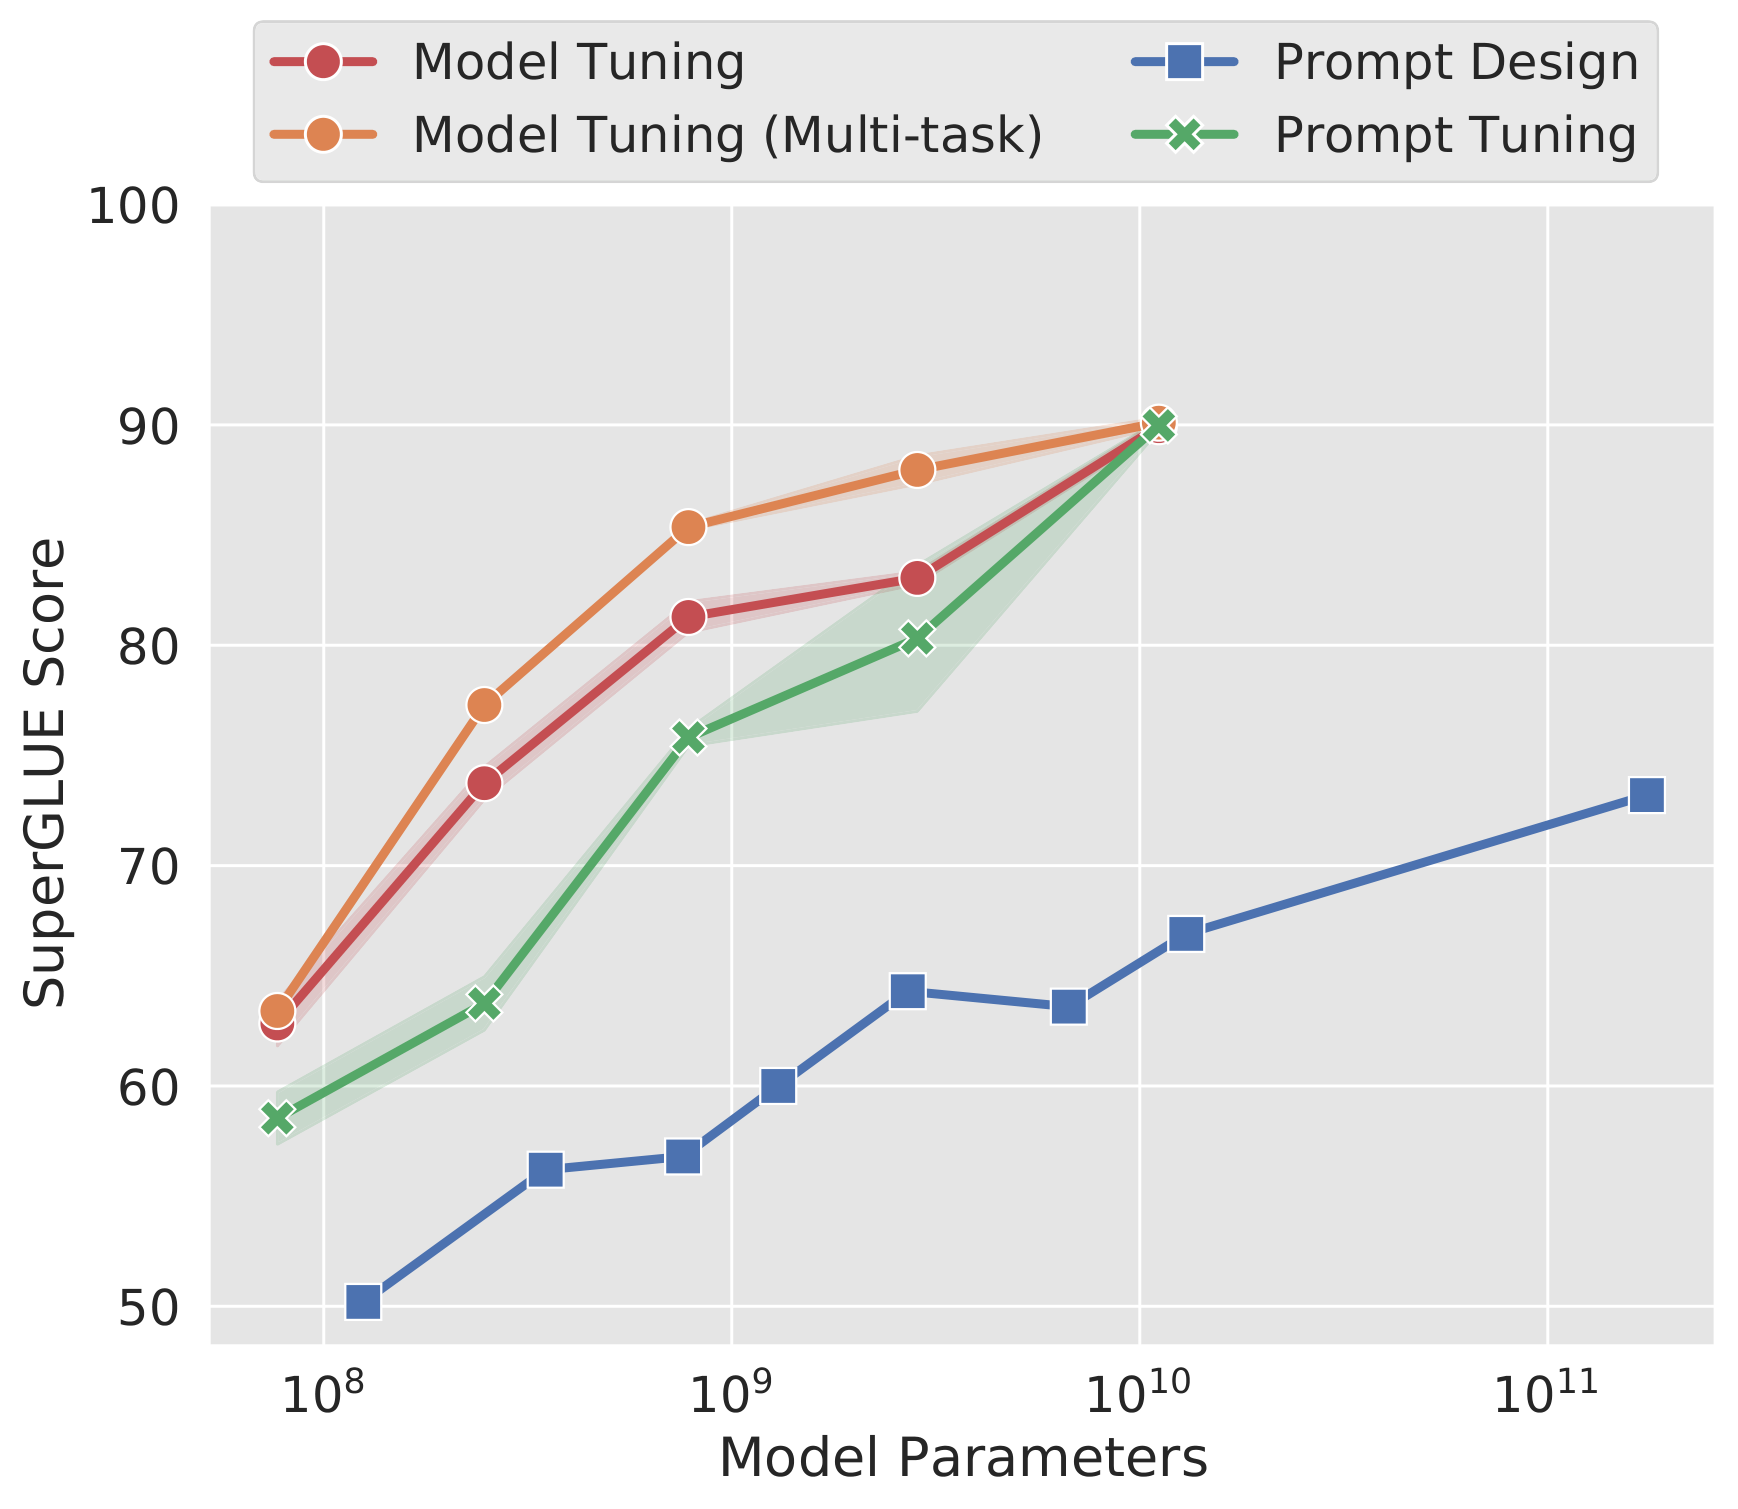
Prompt tuning 论文中的 Figure 1:随着 T5 模型规模增大,prompt tuning 与 full model tuning 的差距逐渐缩小。Image source: Lester et al., 2021.
问题设定
预训练模型可以写成:
$$ y = f_{\theta_0}(x) $$其中 $\theta_0$ 是预训练得到的全部参数。全参数微调会为任务 $t$ 学到一套完整的新参数:
$$ \theta_t = \theta_0 + \Delta\theta_t $$这给模型最大的自由度,但也带来训练显存、优化器状态、模型副本存储、多任务服务切换和灾难性遗忘等成本。PEFT 把问题改写为:
$$ y = f(x; \theta_0, \phi_t), \quad |\phi_t| \ll |\theta_0| $$训练时冻结 $\theta_0$,只优化或切换小型任务状态 $\phi_t$。如果是 hard prompting,$\phi_t$ 可以只是一段离散文本;如果是 P-tuning、adapter 或 LoRA,$\phi_t$ 是少量可训练张量。
| 符号 | 含义 |
|---|---|
| $\theta_0$ | 预训练基础模型参数,PEFT 中通常冻结 |
| $\phi_t$ | 任务 $t$ 的适配参数或适配状态 |
| $x$ | 输入 token 序列 |
| $E(x)$ | 输入 embedding 序列 |
| $d$ | Transformer 隐藏维度 |
| $L$ | Transformer 层数 |
| $m$ | prompt / prefix 的虚拟 token 数 |
| $r$ | bottleneck 或 LoRA rank,通常 $r \ll d$ |
| $W_0$ | 冻结的预训练权重矩阵 |
| $\Delta W$ | 任务适配产生的权重更新 |
| $A,B$ | LoRA 的低秩分解矩阵 |
| $\alpha$ | LoRA 分支缩放系数 |
从工程角度看,PEFT 至少有五个设计轴。
| 设计轴 | 关键问题 | 典型答案 |
|---|---|---|
| 适配位置 | 改输入、改激活,还是改权重更新? | Prompt 系列、Adapter、LoRA |
| 参数规模 | 每个任务要保存多少参数? | 0、$O(md)$、$O(Lmd)$、$O(Ldr)$、$O(dr)$ |
| 推理开销 | 适配是否拉长序列或增加模块? | prompt 增加序列长度;adapter 增加 MLP;LoRA 合并后无额外分支 |
| 表达能力 | 适配信号能影响多深? | input-only、deep prompt、layer module、weight update |
| 可部署性 | 是否能切换、融合、版本化? | prompt 最轻;adapter/LoRA 更像可管理的任务插件 |
PEFT 的本质不是“少训练一点参数”,而是给任务适配施加结构化约束。约束越强,训练和部署越便宜;但如果任务确实需要大幅改变模型行为,约束也可能变成瓶颈。
Prompt 系列
输入侧适配把任务信息放进上下文或 embedding。它的优势是非侵入:模型主体不变,任务差异由输入端控制。它的发展路径大致是:
$$ \text{Hard prompt} \rightarrow \text{Soft prompt / Prompt tuning} \rightarrow \text{P-tuning} \rightarrow \text{Prefix tuning / P-tuning v2} $$这条线的核心问题一直没变:如何让模型在不改主干权重的情况下,稳定地理解任务条件。
Hard Prompt
Hard prompt 是自然语言或结构化文本:
$$ y = f_{\theta_0}([\text{prompt}; x]) $$它可以是任务说明、few-shot examples、输出格式约束、检索片段或工具调用上下文。优点是无需训练、可解释、迭代快;缺点是优化空间离散且巨大:
$$ p^* = \arg\max_{p \in \mathcal{V}^m} J(f_{\theta_0}([p;x])) $$其中 $\mathcal{V}$ 是词表,$m$ 是 prompt 长度。离散 prompt 的小改动可能导致 embedding 空间的大跳变,因此性能对措辞、示例顺序和格式噪声敏感。对需要吸收大量监督数据的稳定任务,hard prompt 通常不够。
Prompt Tuning
Prompt tuning 把 prompt 从离散 token 变成连续向量。设输入 embedding 为:
$$ E(x) = [e_1, e_2, \ldots, e_n], \quad e_i \in \mathbb{R}^{d} $$学习一个长度为 $m$ 的 soft prompt:
$$ P = [p_1, p_2, \ldots, p_m], \quad p_i \in \mathbb{R}^{d} $$输入变成:
$$ [P; E(x)] $$训练时只更新 $P$,参数量为:
$$ |\phi| = m \cdot d $$如果 $m=20$、$d=4096$,一个任务只有 $81{,}920$ 个参数。Lester et al. (2021) 的重要观察是:模型规模越大,prompt tuning 越接近 full model tuning。这说明 soft prompt 的能力强依赖冻结模型本身是否足够强,能否把输入端的连续控制向量解释成任务行为。
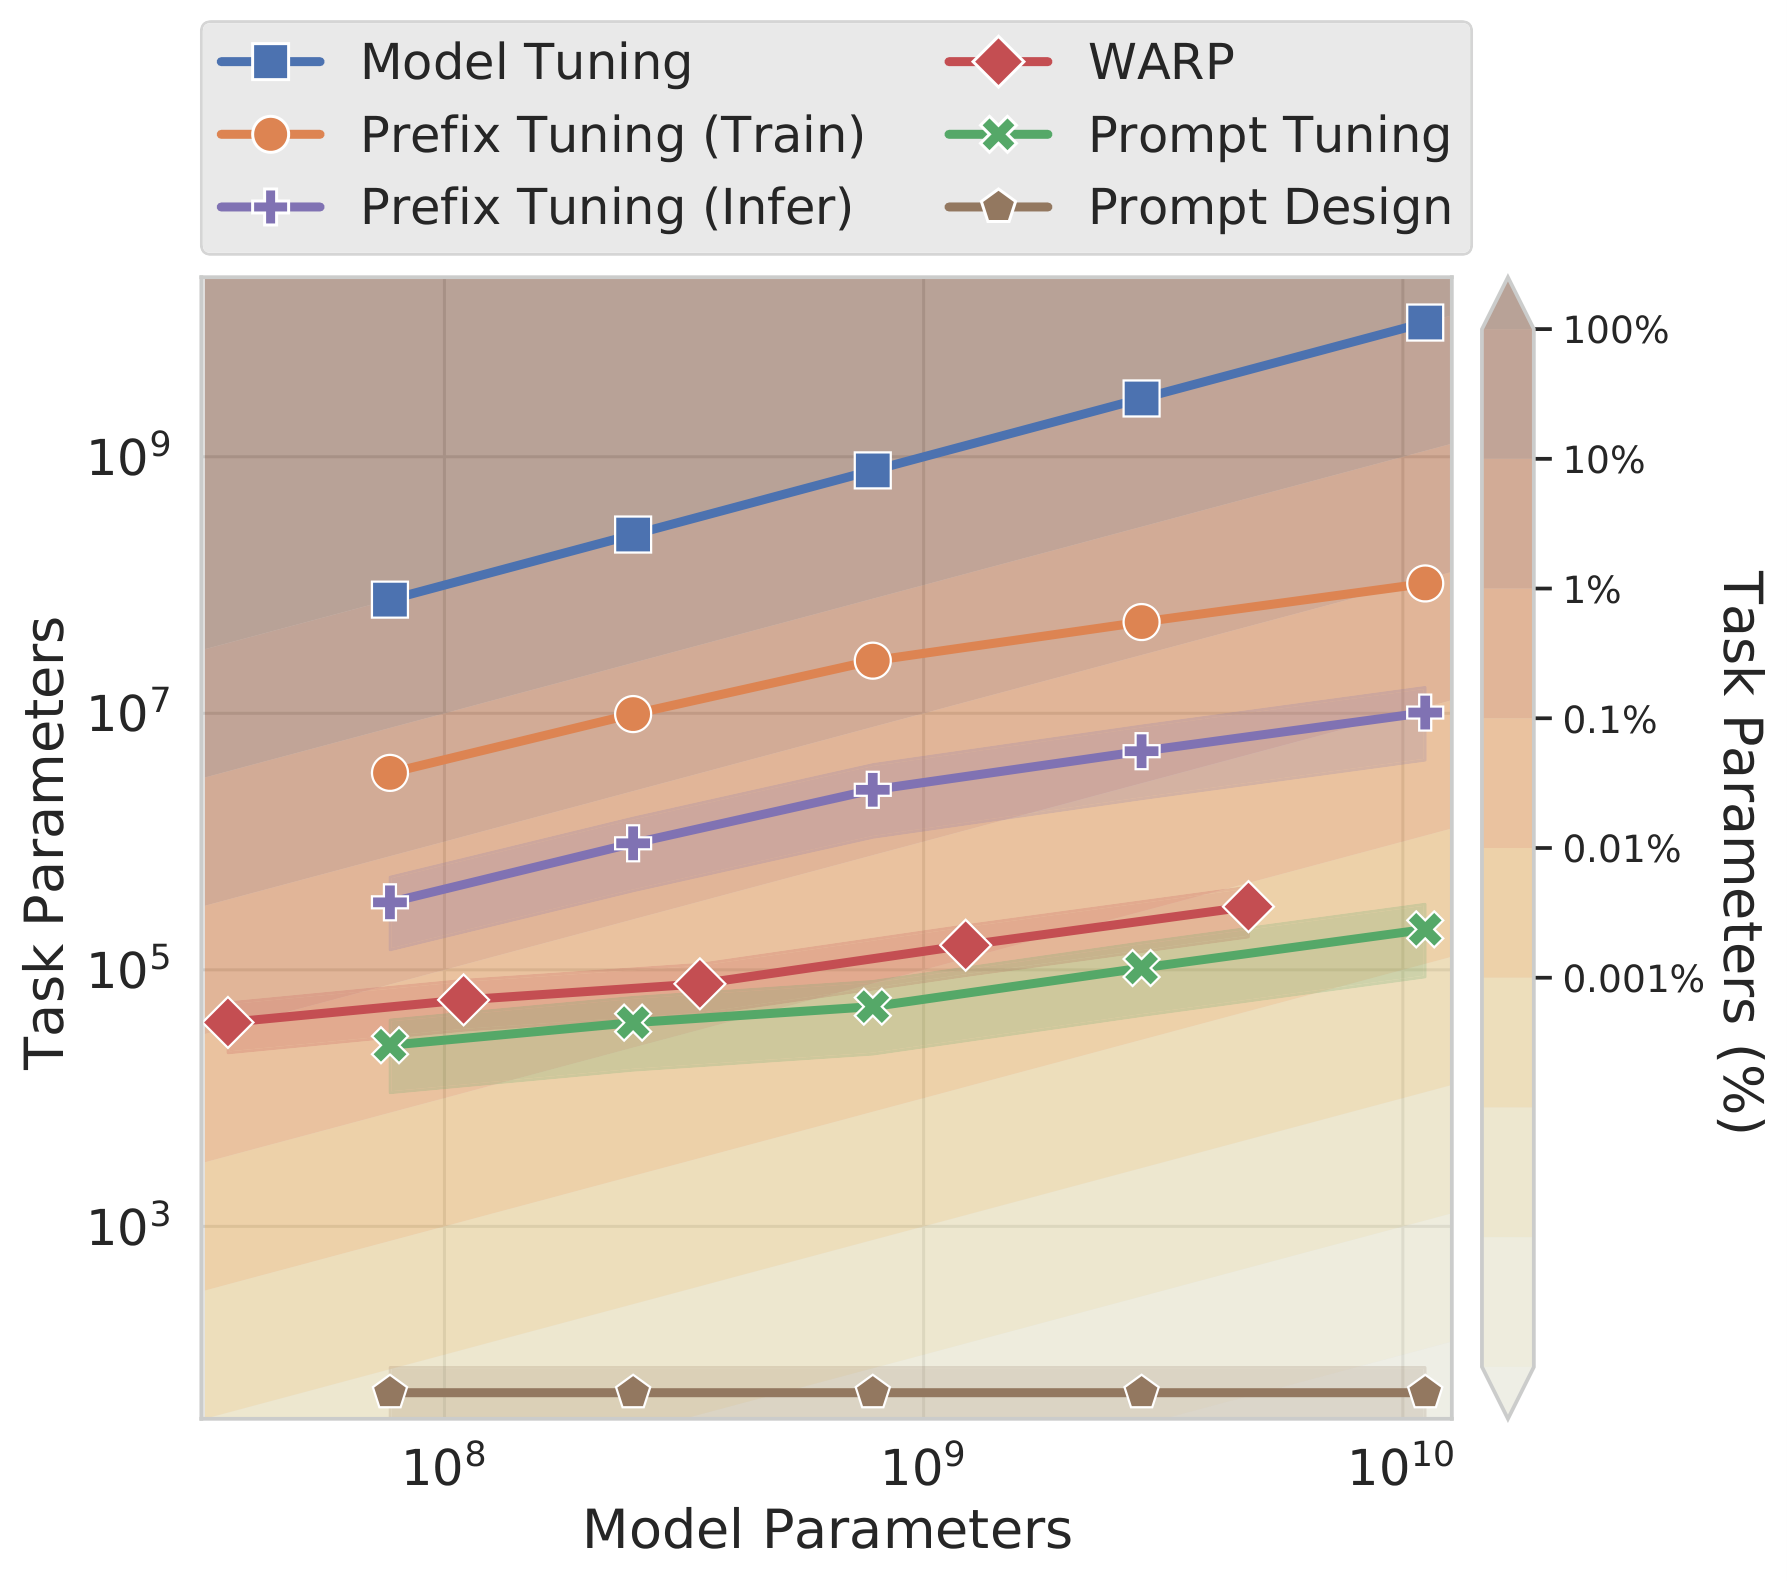
Prompt tuning 论文对不同 conditioning 方法的参数量比较。Prompt tuning 只学习输入端少量连续向量,任务特定参数很少。Image source: Lester et al., 2021.
P-tuning
P-tuning(Liu et al., 2021)和 prompt tuning 的共同点是学习连续 prompt;差异在于 P-tuning 不是简单地把每个 pseudo token 当作独立 embedding,而是引入一个轻量 prompt encoder 来生成连续提示向量。
设 $[P_i]$ 是第 $i$ 个 pseudo prompt token,P-tuning 用一个映射函数 $f$ 得到真正送入模型的连续向量:
$$ h_i = f([P_i]) $$模板可以写成:
$$ T = \{[P_{0:i}], x, [P_{i+1:j}], y, [P_{j+1:k}]\} $$送入预训练模型的不是离散 prompt embedding,而是:
$$ \{h_0,\ldots,h_i, E(x), h_{i+1},\ldots,h_j, E(y), h_{j+1},\ldots,h_k\} $$Prompt encoder 的作用是给 prompt 向量加入结构化依赖。原论文实验过 LSTM、MLP 和 identity mapping;直觉是多个 prompt token 不应该完全独立,它们共同形成一段“连续模板”。训练结束后,推理通常只需要保留 encoder 输出的 prompt embedding,prompt encoder 本身可以被丢弃。
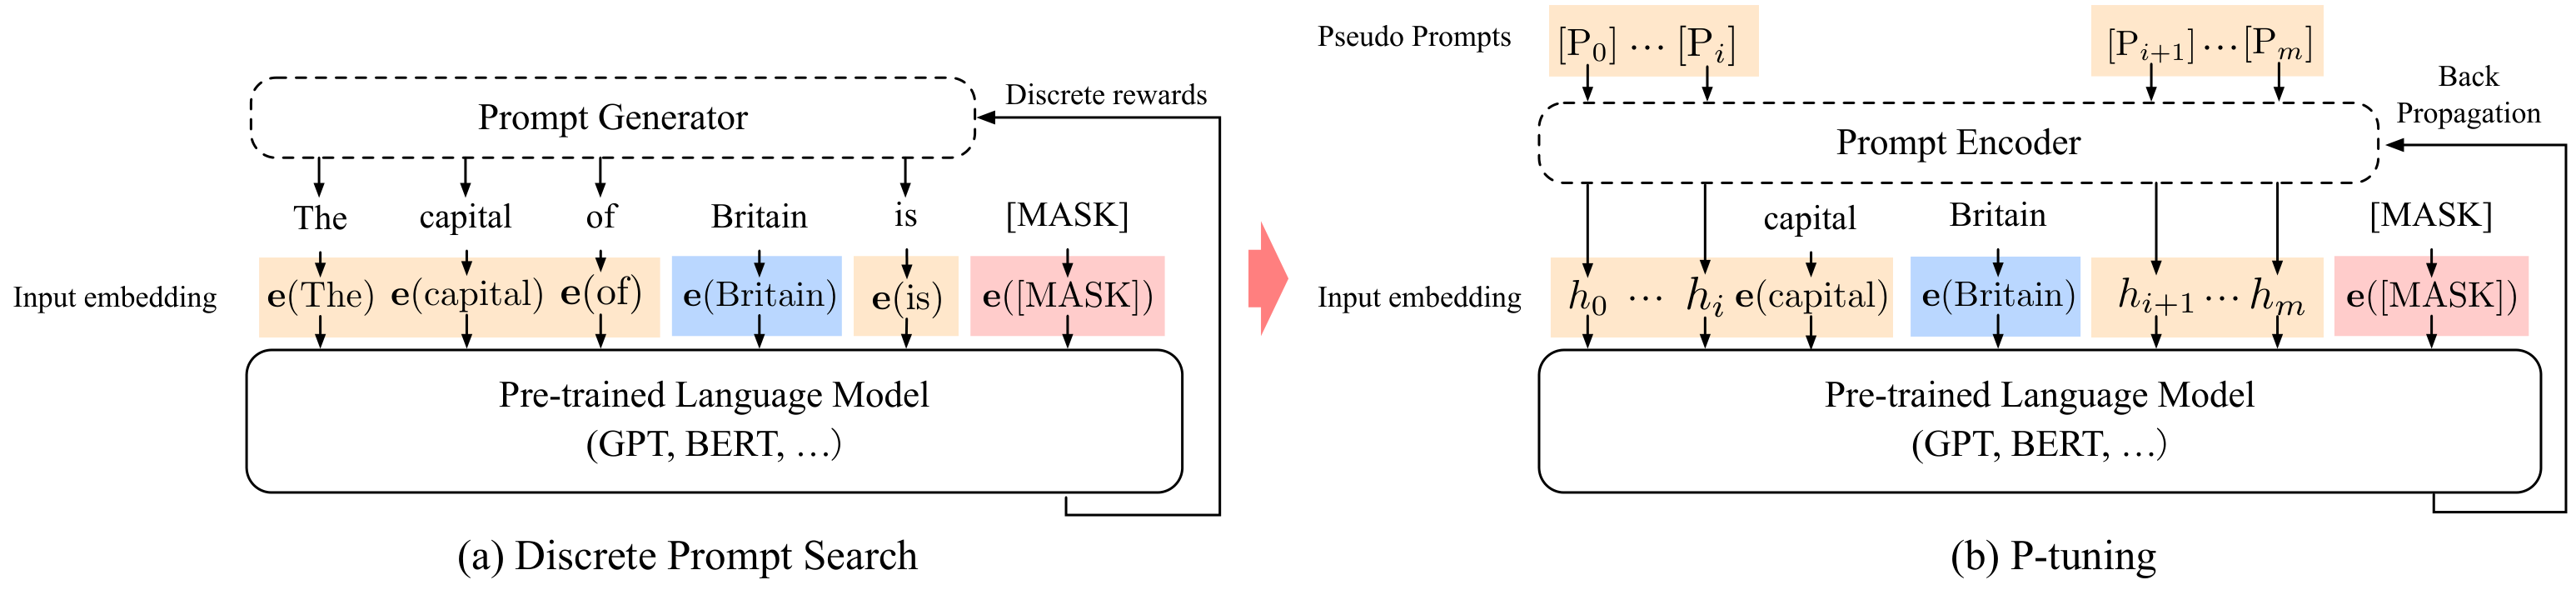
P-tuning 原论文中的框架图:相比离散 prompt search 只能接收离散奖励,P-tuning 通过 prompt encoder 生成可微优化的连续 prompt。Image source: Liu et al., 2021.
P-tuning 的目标不是替代所有微调,而是解决早期离散 prompt 的两个问题:一是人工模板不稳定,二是离散搜索无法顺畅利用梯度。它尤其强调 GPT 风格模型也能通过 cloze-style prompt 做 NLU 任务,因此论文标题是 “GPT Understands, Too”。
Prefix Tuning
Prompt tuning 和 P-tuning 都主要在输入 embedding 层插入连续提示。Prefix tuning(Li & Liang, 2021)把可训练 prefix 注入到每层 attention 的 key/value 中。
在第 $l$ 层,原本有:
$$ K_l = X_l W^K_l, \quad V_l = X_l W^V_l $$Prefix tuning 学习额外的 prefix key/value:
$$ \tilde{K}_l = [P^K_l; K_l], \quad \tilde{V}_l = [P^V_l; V_l] $$后续 token 可以像 attending to context token 一样 attending to prefix。与输入端 soft prompt 相比,prefix 更深:每层 attention 都能直接看到任务特定 memory。
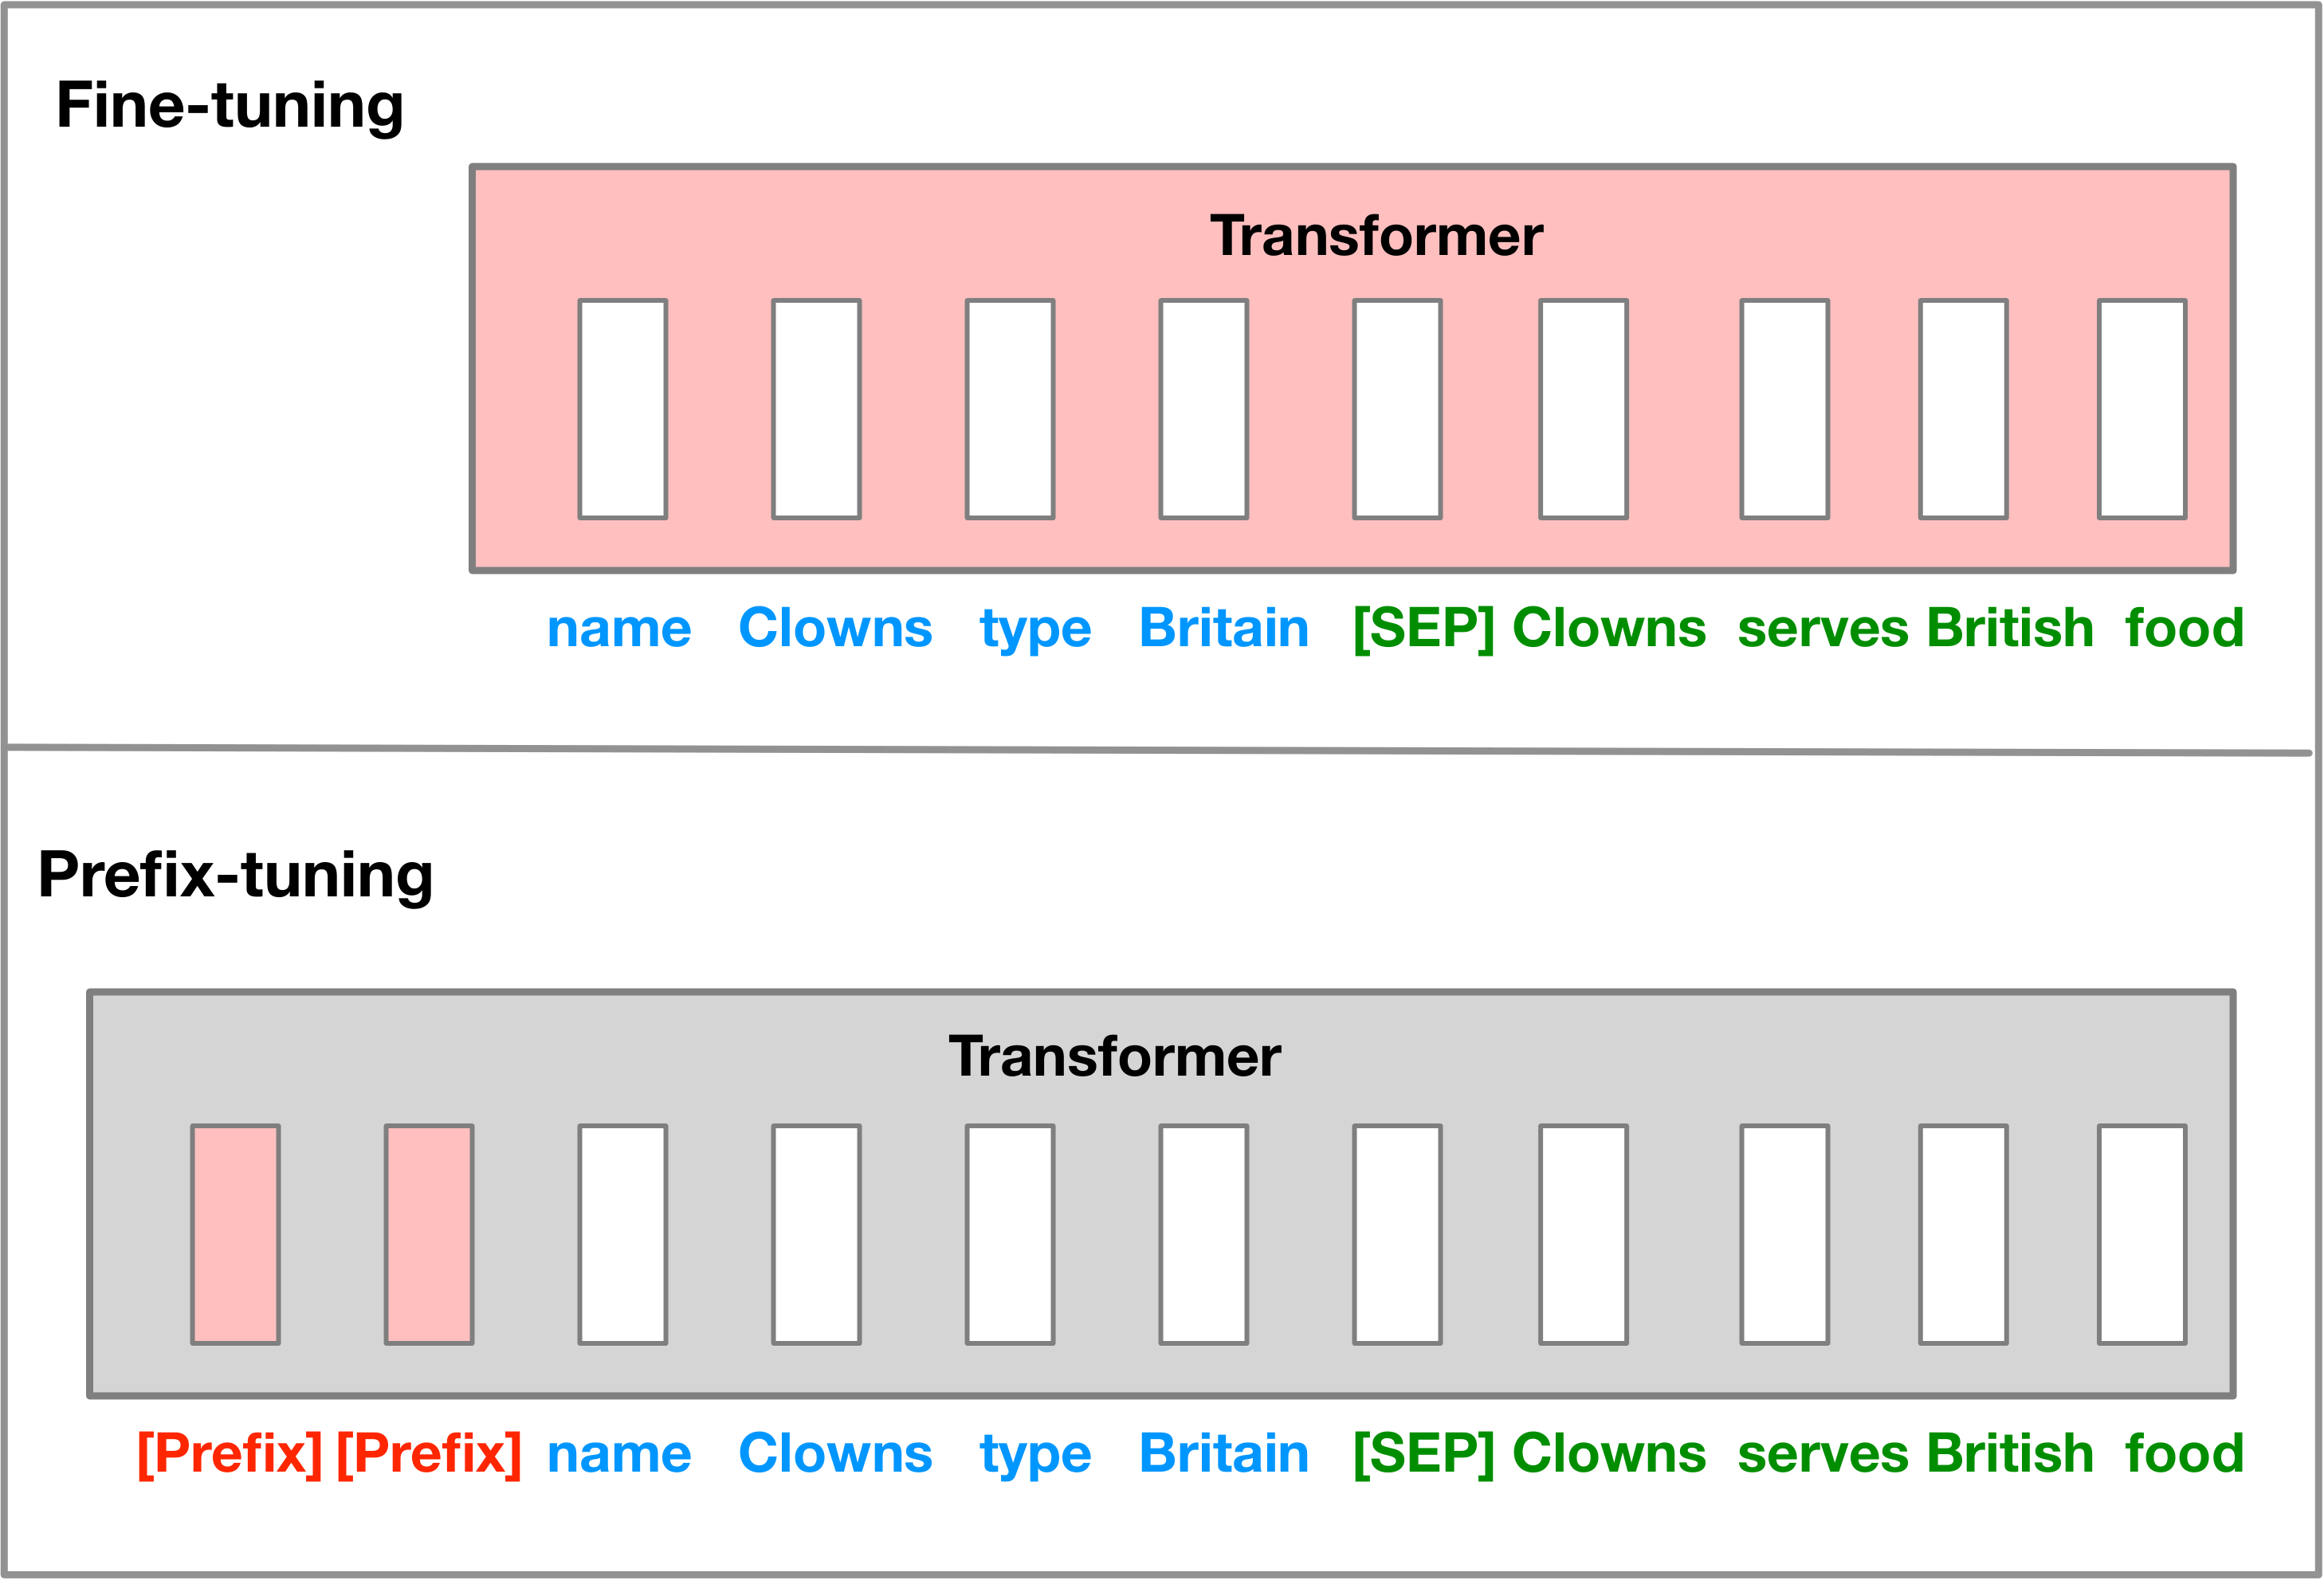
Prefix-tuning 论文中的示意图:prefix 被当作虚拟 token,后续 token 可以对其进行 attention。Image source: Li & Liang, 2021.
P-tuning v2
P-tuning v2(Liu et al., 2021)可以看作把 P-tuning / prompt tuning 从 input-only 推进到 deep prompt tuning。它的动机很直接:只在输入层加连续 prompt 有两个限制。
- 可训练参数受输入长度限制,任务容量小。
- 输入层 prompt 要经过很多 Transformer 层才影响输出,对中小模型和复杂序列标注任务不够直接。
P-tuning v2 在每一层加入独立的连续 prompt,形式上接近为每层添加 prefix token。这样每层都有任务特定信号:
$$ \{P_1, P_2, \ldots, P_L\} $$参数量从非常小的 input prompt 扩展到约 $0.1\%-3\%$ 的 backbone 参数量,仍然属于 PEFT,但任务容量明显更大。论文还强调两个实践变化:一是 reparameterization(如 MLP)是否有用依赖任务;二是在完整监督 NLU 场景中,未必需要 verbalizer + LM head,可以回到普通分类头,这让它更容易处理序列标注、抽取式 QA 等任务。
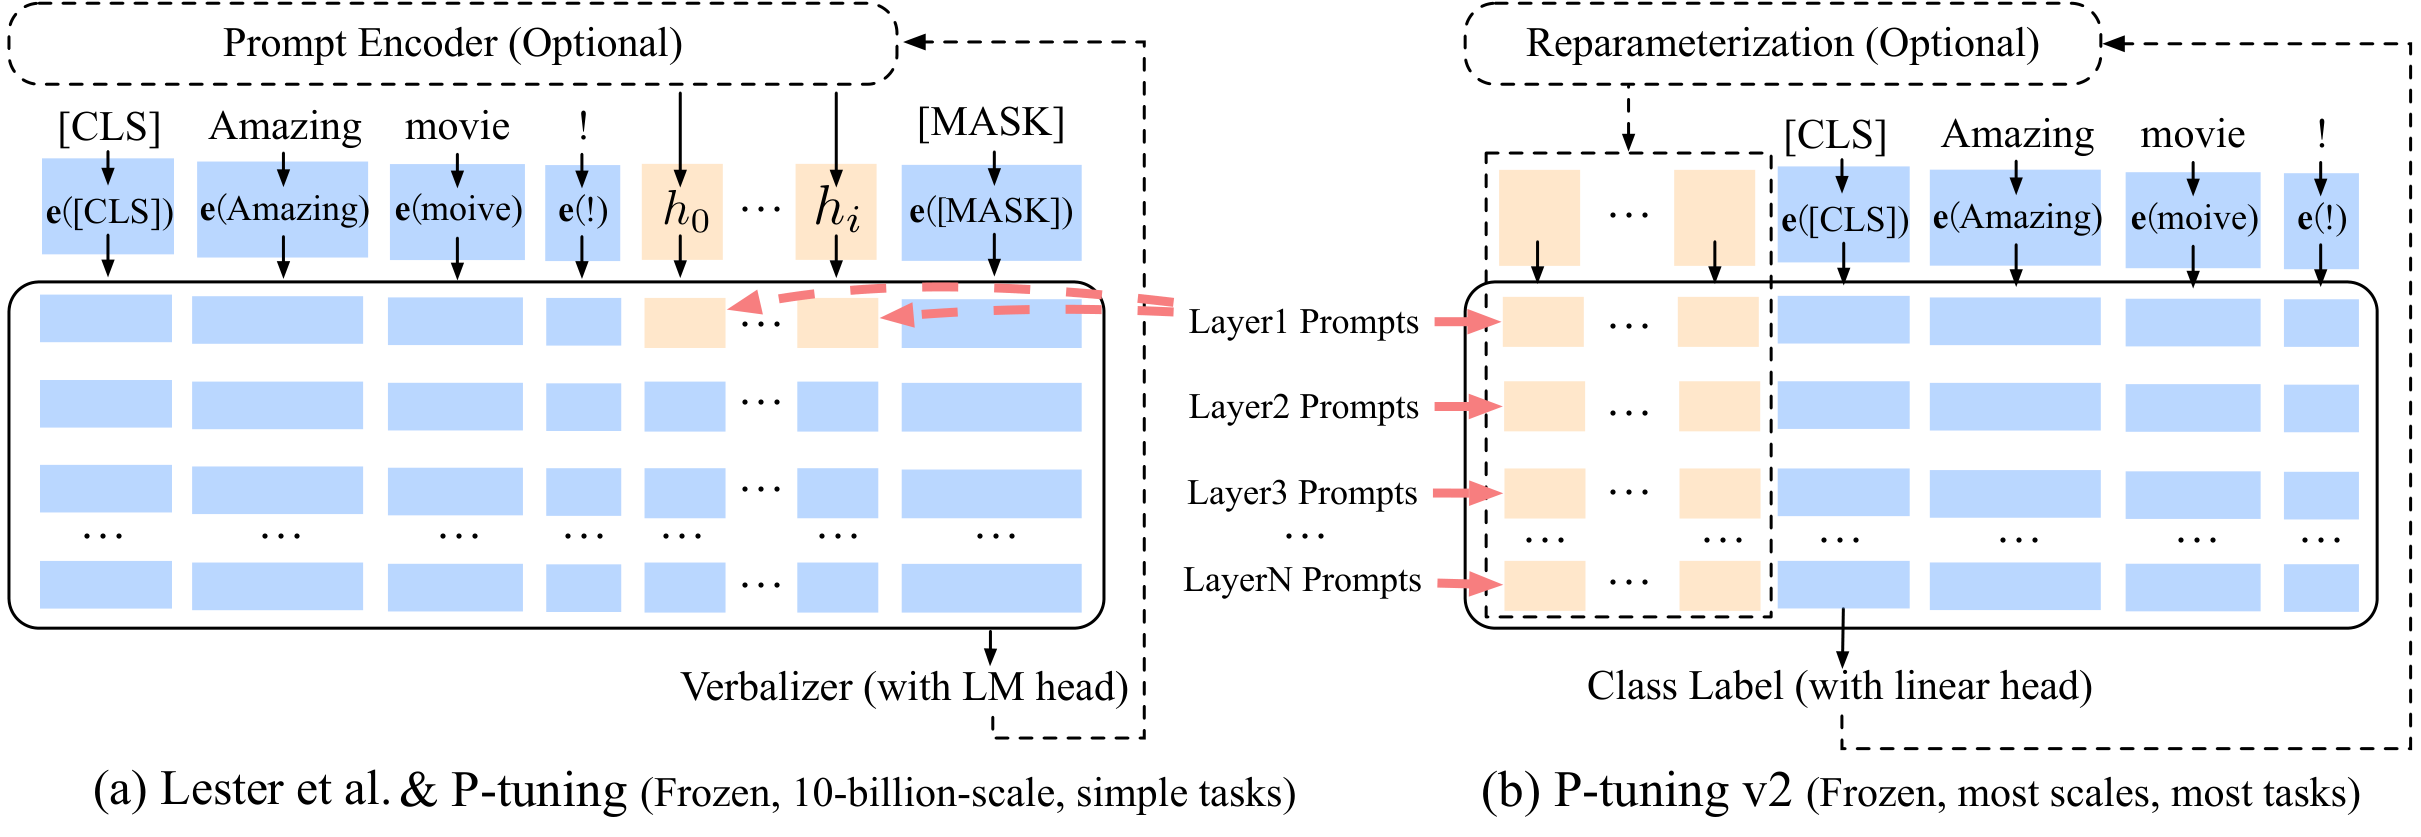
P-tuning v2 原论文中的对比:早期 prompt tuning/P-tuning 只在输入层放连续 prompt,P-tuning v2 在多层加入 deep prompts,提高跨模型规模和跨任务的通用性。Image source: Liu et al., 2021.
Prompt 系列方法的演进可以总结为:hard prompt 解决“无需训练”,soft prompt 解决“可微优化”,P-tuning 解决“连续 prompt 的结构化生成”,prefix tuning / P-tuning v2 解决“输入层控制太浅”的问题。
Adapter
Adapter-tuning 的思路是冻结 Transformer 主干,在每层插入小型可训练模块。原模型负责通用表示,adapter 负责把表示推向任务需要的方向。
Houlsby et al. (2019) 的 adapter 是 bottleneck 结构:
$$ \text{Adapter}(h)=W_{\text{up}}\ \sigma(W_{\text{down}}h) $$其中:
$$ W_{\text{down}} \in \mathbb{R}^{r \times d}, \quad W_{\text{up}} \in \mathbb{R}^{d \times r}, \quad r \ll d $$adapter 输出通过残差方式加回隐藏状态:
$$ h' = h + \text{Adapter}(h) $$参数量约为:
$$ |\phi_{\text{adapter}}| \approx 2dr $$如果每层放两个 adapter,总参数量约为 $4Ldr$。当 $d=4096$、$r=64$ 时,每个 adapter 约 $0.52M$ 参数,相对整层 attention 和 MLP 权重仍很小。
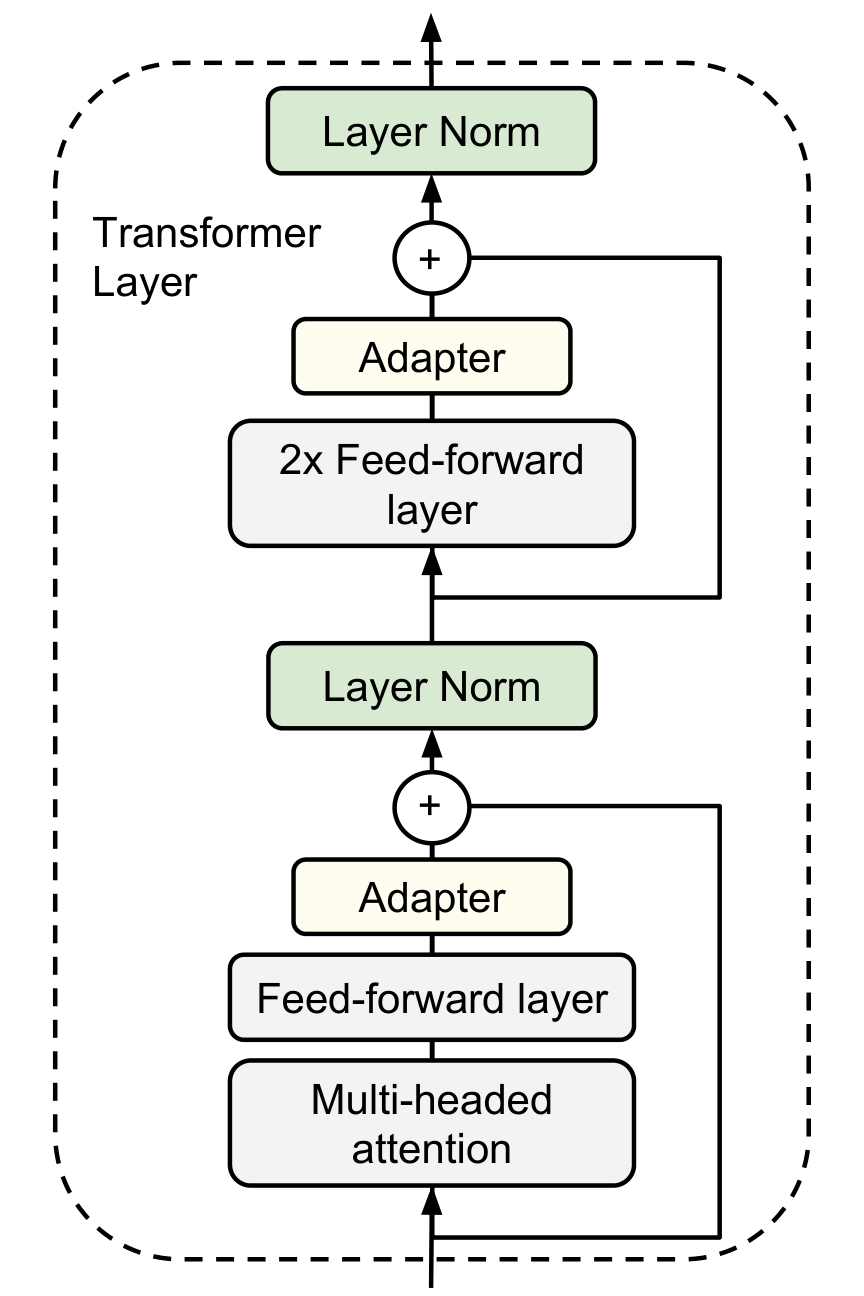
Adapter 原论文中的插入位置:在 Transformer 子层之后加入小型 adapter,并通过残差连接回主路径。Image source: Houlsby et al., 2019.
Bottleneck 的意义不只是省参数。它还给任务适配加了低维通道约束:任务不能任意重写整个隐藏空间,只能先压到 $r$ 维,再升回 $d$ 维。这与 LoRA 的低秩思想有相似性,只是 adapter 作用在激活上,LoRA 作用在权重更新上。
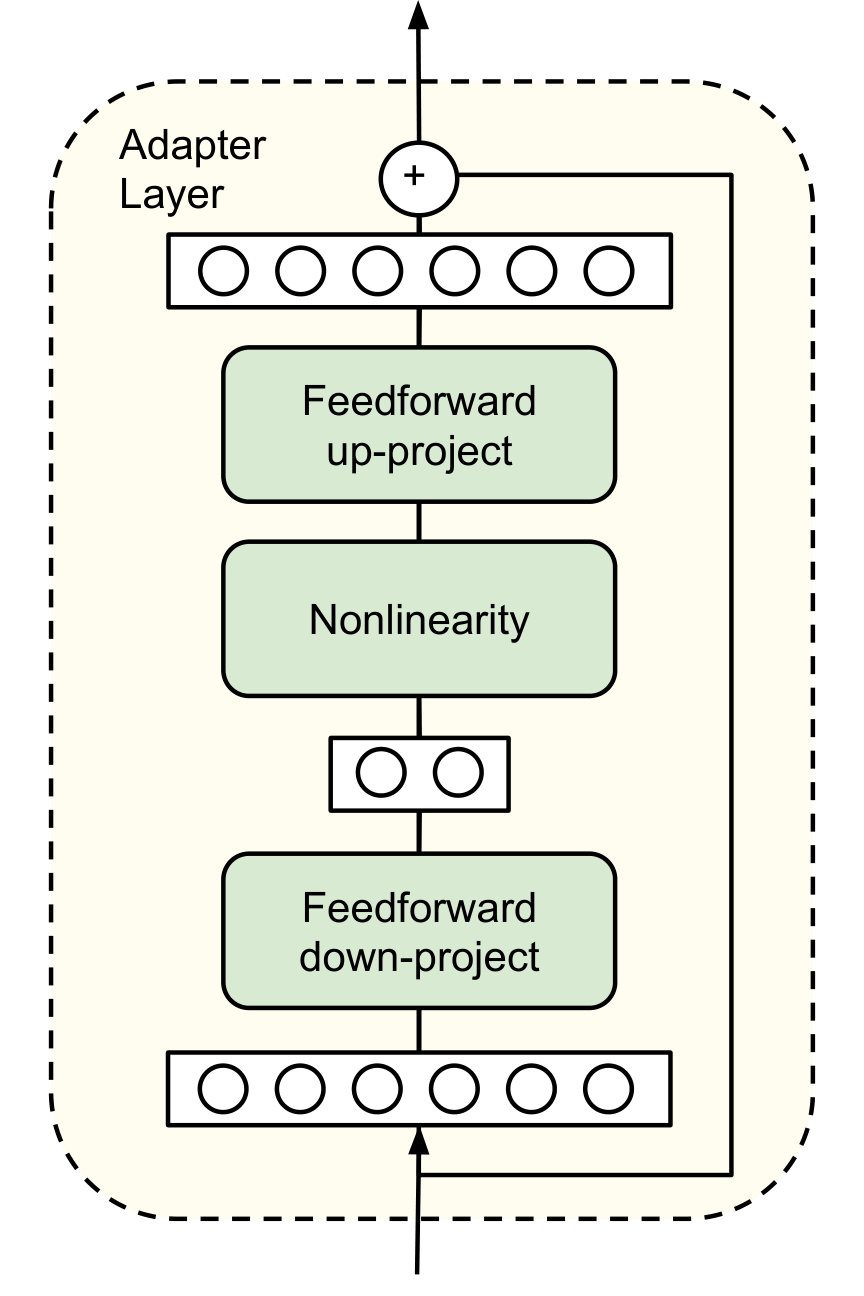
Adapter 模块本身的 bottleneck 结构:先降维,再非线性变换,最后升维回隐藏维度。Image source: Houlsby et al., 2019.
Adapter 的工程优点是模块边界清晰。训练时冻结 $\theta_0$,只训练每个任务的 adapter;部署时加载一个共享基础模型,按任务挂载不同 adapter。Houlsby et al. (2019) 在 GLUE 上报告,adapter 只增加每任务约 3.6% 参数,就能接近 full fine-tuning。
它的代价是推理路径变长。每个 adapter 都是额外 MLP,会引入额外 kernel、激活和残差路径。在多任务隔离、模块管理、组合适配很重要时,adapter 很自然;如果最看重合并后无额外推理延迟,LoRA 更适合。
LoRA 与 QLoRA
LoRA(Low-Rank Adaptation)把适配位置从激活路径移到权重更新路径。它不训练原权重 $W_0$,而是假设微调更新 $\Delta W$ 可以被低秩分解:
$$ W = W_0 + \Delta W, \quad \Delta W = BA $$其中:
$$ A \in \mathbb{R}^{r \times d_{\text{in}}}, \quad B \in \mathbb{R}^{d_{\text{out}} \times r}, \quad r \ll \min(d_{\text{in}}, d_{\text{out}}) $$前向传播为:
$$ y = W_0x + \frac{\alpha}{r}BAx $$训练时冻结 $W_0$,只训练 $A,B$。常见初始化是 $A$ 随机初始化、$B$ 初始化为零,因此训练开始时:
$$ \Delta W = BA = 0 $$模型初始行为与原模型一致,随后逐步学习任务更新。
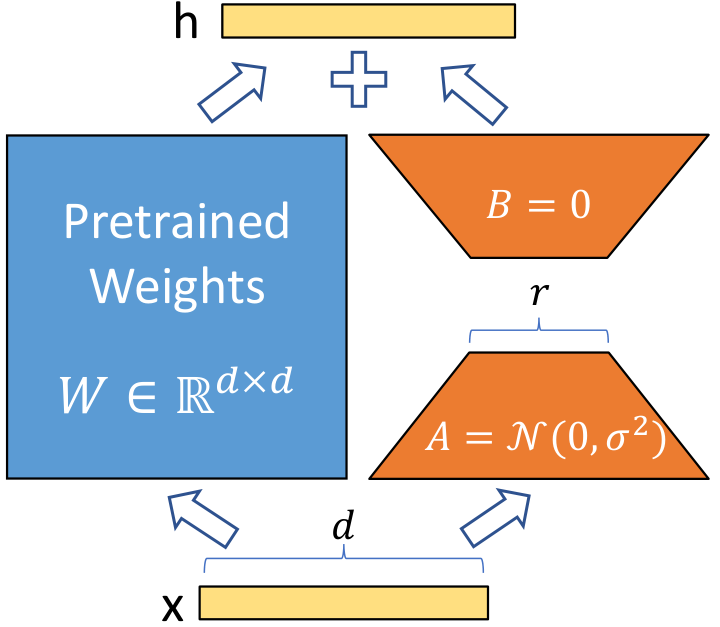
LoRA 原论文中的核心结构:冻结预训练权重 $W$,用低秩矩阵 $A,B$ 表示可训练更新。Image source: Hu et al., 2022.
对一个 $d \times d$ 线性层,全参数微调更新 $d^2$ 个参数;LoRA 只训练:
$$ 2dr $$比例为:
$$ \frac{2dr}{d^2} = \frac{2r}{d} $$如果 $d=4096$、$r=8$,比例约 $0.39\%$。如果只对 attention 中的 $W_Q,W_V$ 或 $W_Q,W_K,W_V,W_O$ 加 LoRA,整体可训练参数占比更低。
LoRA 的关键工程优势是可合并。训练完成后:
$$ W' = W_0 + \frac{\alpha}{r}BA $$把 $\Delta W$ 加回 $W_0$ 后,推理仍是一层普通线性变换,没有额外分支延迟。需要多任务动态切换时,也可以不合并,而是在服务端保留多个 LoRA adapter:
$$ \{\phi_1, \phi_2, \ldots, \phi_T\} $$LoRA 常加在 attention projection 和 MLP projection 上。
| 目标模块 | 作用 | 适配影响 |
|---|---|---|
| $W_Q$ | 产生 query | 改变 token 关注什么 |
| $W_K$ | 产生 key | 改变 token 如何被匹配 |
| $W_V$ | 产生 value | 改变被聚合的信息内容 |
| $W_O$ | attention 输出投影 | 改变多头信息如何回到隐藏空间 |
| MLP up/down/gate projection | 前馈网络 | 改变逐 token 非线性变换 |
| Embedding / LM head | 输入输出词表映射 | 适合词表、风格或领域输出变化 |
早期 LoRA 常只加到 $W_Q,W_V$;现代 LLM 指令微调和领域适配经常覆盖 attention 与 MLP 的多个 projection。目标模块越多,表达能力越强,训练成本也越高。
QLoRA 解决的是另一个瓶颈:LoRA 减少了可训练参数,但基础模型权重仍要加载到显存。一个 65B 模型以 16-bit 加载,仅权重就约需要:
$$ 65B \times 2\text{ bytes} \approx 130\text{ GB} $$QLoRA 把冻结基础模型以 4-bit 存储,同时仍训练 LoRA:
$$ y = \text{Dequant}(W_0^{\text{4-bit}})x + \frac{\alpha}{r}BAx $$基础权重只参与反量化计算,不被更新;梯度回传到 LoRA 参数。QLoRA 的关键机制包括 NF4、double quantization 和 paged optimizers。Dettmers et al. (2023) 报告 QLoRA 可以在单张 48GB GPU 上微调 65B 参数模型,同时保持接近 16-bit 微调的任务性能。
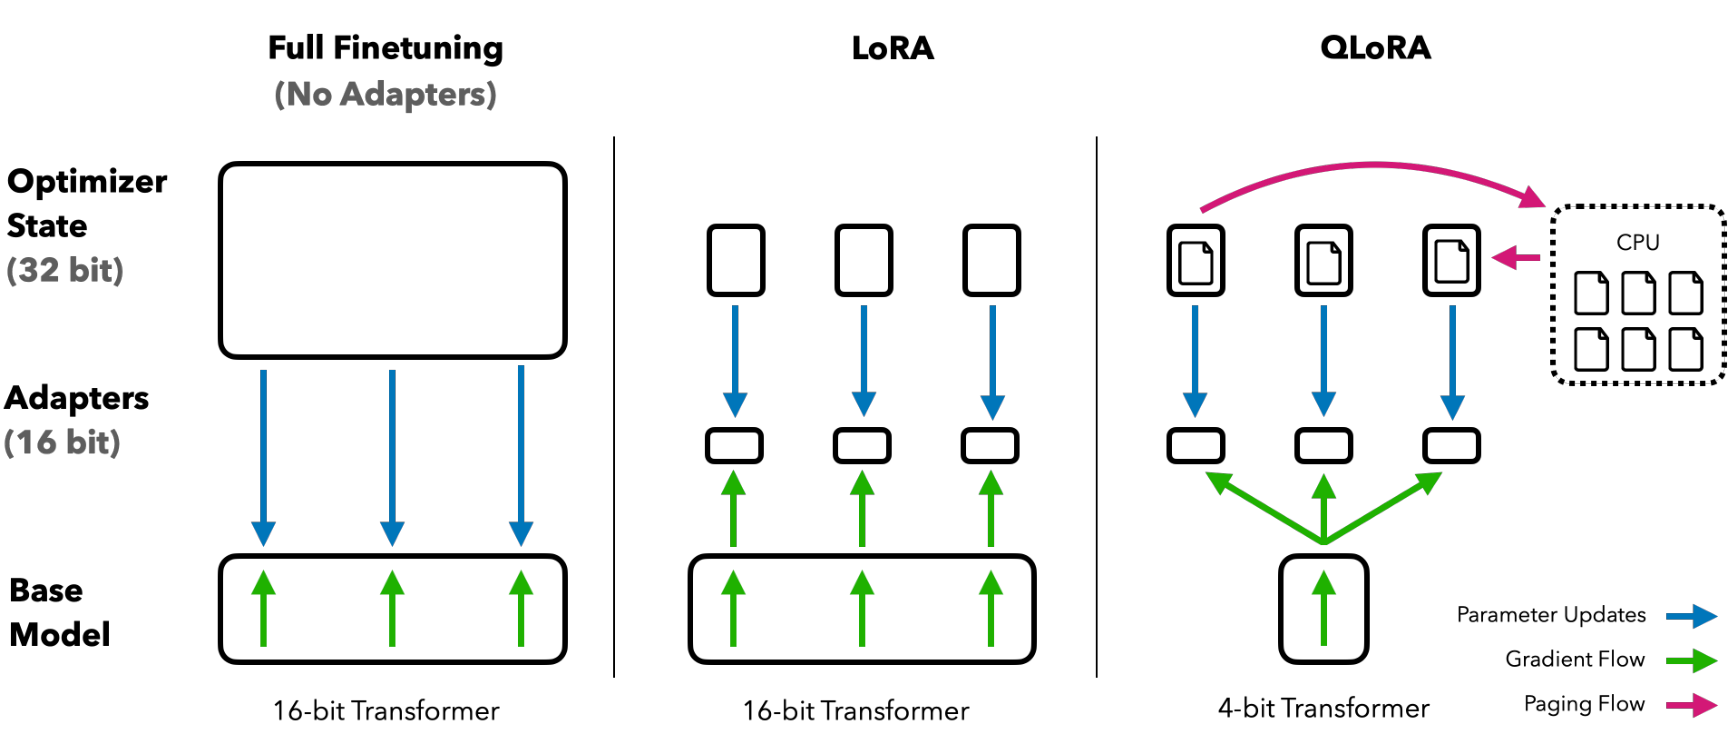
QLoRA 原论文中的对比:full finetuning、LoRA 与 QLoRA 的权重、adapter、优化器状态和分页流。Image source: Dettmers et al., 2023.
LoRA 与 QLoRA 应该放在同一个方法族里理解:LoRA 约束可训练更新,QLoRA 进一步压缩冻结基座。前者回答“训练哪些参数”,后者回答“冻结的大模型怎么放进显存”。
对比与选型
| 方法 | 适配位置 | 可训练对象 | 参数规模 | 推理成本 | 典型优点 | 典型限制 |
|---|---|---|---|---|---|---|
| Hard prompting | 输入文本 | 无 | 0 | 增加上下文长度 | 无训练、可解释、迭代快 | 对措辞和格式敏感 |
| Prompt tuning | 输入 embedding | soft prompt | $O(md)$ | 增加虚拟 token | 参数极少、易切换 | input-only,依赖模型规模 |
| P-tuning | 输入 embedding | prompt encoder / continuous prompt | $O(md)$ 加小 encoder | 增加虚拟 token | 可微优化,prompt token 有结构依赖 | 主要影响输入层 |
| Prefix tuning | 每层 attention | prefix key/value | $O(Lmd)$ | attention 长度增加 | 每层都有控制信号 | 序列开销更明显 |
| P-tuning v2 | 多层 deep prompt | 每层连续 prompt | 约 $0.1\%-3\%$ | 增加多层 prompt | 跨规模、跨 NLU 任务更通用 | prompt 长度和任务细节敏感 |
| Adapter-tuning | 层内激活路径 | bottleneck MLP | $O(Ldr)$ | 增加模块 | 模块化强,多任务隔离好 | 推理路径变长 |
| LoRA | 权重更新路径 | 低秩矩阵 $A,B$ | $O(dr)$ 每目标矩阵 | 合并后无额外延迟 | 强基线,部署方便 | rank 和目标模块需调 |
| QLoRA | 量化基座 + LoRA | LoRA 参数 | 类似 LoRA | 量化反量化开销 | 显存占用极低 | 对量化实现和硬件敏感 |
| Full fine-tuning | 全模型 | 全部参数 | $O( | \theta | )$ | 无额外模块 |
一个实用选型顺序是:
- 任务还在探索期:先用 hard prompt 和 few-shot prompt 明确任务协议。
- 只需要轻量行为控制:试 prompt tuning、P-tuning 或 prefix tuning。
- 需要在中小模型、复杂 NLU 或序列标注上接近全参微调:考虑 P-tuning v2 或 adapter。
- 需要通用强基线、训练后可合并、推理无额外延迟:优先 LoRA。
- 显存是核心瓶颈:用 QLoRA,而不是普通 LoRA。
- 数据量大、目标稳定、PEFT 已充分调参仍不足:再考虑 full fine-tuning 或继续预训练。
常见失效模式也很固定。
把 PEFT 当作数据质量替代品。 PEFT 只能降低训练成本,不能修复脏数据、错误标签和混乱任务定义。LoRA 和 P-tuning 都会学习数据里的格式偏差。
适配位置选错。 如果任务需要改变 MLP 表示,却只给 $W_Q,W_V$ 加 LoRA,模型会学得吃力;如果任务只是格式控制,却上来训练多层 adapter,可能过重。
prompt 协议不一致。 训练 LoRA 或 P-tuning 时使用一种模板,推理时换模板,效果可能明显下降。参数少不代表对上下文协议不敏感。
忽略推理开销。 adapter 参数少,但每层额外 MLP 会增加延迟;prefix / deep prompt 会拉长 attention;未合并 LoRA 也有额外分支。
低估量化误差。 QLoRA 很强,但 4-bit 权重、计算 dtype、量化分组和硬件 kernel 都影响稳定性。小模型、数值敏感任务、特殊领域需要单独验证。
只看单一 benchmark。 PEFT 可能在目标 benchmark 上很好,但在泛化、鲁棒性、拒答、安全偏好或长上下文任务上退化。尤其是 instruction tuning,需要同时评估帮助性、真实性、格式遵循和安全边界。
PEFT 方法也可以组合。RAG + prompting 适合动态知识;Prompt + LoRA 让 prompt 控制运行时协议,LoRA 固化长期偏好;QLoRA + instruction tuning 适合低显存训练;多 LoRA 路由适合领域、用户或风格隔离。组合时要评估模块间是否争夺同一行为控制权,例如 prompt 要求简洁,而 LoRA 数据偏向长解释。
PEFT 的核心价值,是把任务适配从“复制整个模型”变成“保存和切换小型任务状态”。Prompt 系列把状态放在输入和上下文里,adapter 把状态放在层内激活路径里,LoRA 把状态放在权重更新子空间里,QLoRA 则进一步让冻结基座更便宜。今天的 LLM 微调实践中,LoRA/QLoRA 往往是默认训练基线,prompting 是运行时控制层,adapter 和 deep prompt 在模块化或 NLU 任务中仍有清晰位置。
参考文献
[1] Houlsby, Neil, et al. “Parameter-Efficient Transfer Learning for NLP.” ICML 2019.
[2] Li, Xiang Lisa, and Percy Liang. “Prefix-Tuning: Optimizing Continuous Prompts for Generation.” ACL 2021.
[3] Liu, Xiao, et al. “GPT Understands, Too.” arXiv preprint arXiv:2103.10385, 2021.
[4] Lester, Brian, Rami Al-Rfou, and Noah Constant. “The Power of Scale for Parameter-Efficient Prompt Tuning.” EMNLP 2021.
[5] Hu, Edward J., et al. “LoRA: Low-Rank Adaptation of Large Language Models.” ICLR 2022.
[6] Liu, Xiao, et al. “P-Tuning v2: Prompt Tuning Can Be Comparable to Fine-tuning Universally Across Scales and Tasks.” ACL 2022.
[7] He, Junxian, et al. “Towards a Unified View of Parameter-Efficient Transfer Learning.” ICLR 2022.
[8] Dettmers, Tim, et al. “QLoRA: Efficient Finetuning of Quantized LLMs.” NeurIPS 2023.
[9] Mangrulkar, Sourab, et al. “PEFT: State-of-the-art Parameter-Efficient Fine-Tuning methods.” Hugging Face, 2023.